今天咱们来学习一个 Spark 的基础知识,虽然基础,但是也容易被很多同学忽视,尤其是那些原来专业做 Java 开发的,容易带着惯性思维犯这种错误。
这个知识点叫做:如何定义 Spark 的全局变量?
做 Java 开发的同学应该都知道,全局变量的最大特点,是在类中定义,然后可以提供给这个类所有函数可见、可操作(可读、可修改等)的这么一个全局对象。
这种玩法,在单进程(或者单进程多线程)情况下是没有问题的,但是,如果你定义的这个全局变量所属的类,要跑在一个多进程、或者说分布式环境下,这种定义方式就失去了它原来的作用。
0. 举个栗子
来,一起来看这个简单的 Spark 案例。
package com.anryg.bigdata.test.variable

import java.util.concurrent.atomic.AtomicLong

import org.apache.spark.SparkConf
import org.apache.spark.sql.SparkSession
import org.apache.log4j.{Level, Logger}

/**
  * @DESC: Spark 全局变量的使用测试
  * @Auther: Anryg
  * @Date: 2024/6/27 20:55
  */
object VariableTest01 {
    val counter = new AtomicLong() /**定义计数器全局变量*/

    def main(args: Array[String]): Unit = {
        val sparkConf = new SparkConf()
        sparkConf.setAppName("VariableTest01")
        sparkConf.setMaster("local[*]")

        val spark = SparkSession.builder().config(sparkConf).getOrCreate()

        /**构造数据源*/
        val seq = Seq("a","", "", "", "", "", "", "","b", "c", "", "d", "", "e", "f", "g", "h", "i", "", "", "", "", "", "", "", "", "j","", "", "", "", "", "", "", "k", "", "", "", "")
        spark.sparkContext.makeRDD(seq, 3) /**生成 RDD 对象*/
                .foreach(str => {
                    if (str.equals("")) counter.getAndIncrement() /**遇空开始计数*/
                    else println(str)  /**打印不为空的数据*/
                })

        println("累计计数器大小为: " + counter.longValue()) /**打印计数器的大小*/
        spark.close()
    }
}
代码逻辑非常简单,就是在利用 Spark 对数据计算时,对于数据为空字符的情况,进行额外的数量统计,然后把这个统计结果进行汇总,最后打印输出。
从当前的代码书写来看,是一种典型的「Java程序思维」,把这个统计数据为空字符情况的计数器,作为「全局变量」进行定义,然后在具体的代码处理逻辑中,对这个计数器进行累加操作。
你先猜一下,以上这个代码,能正常运行吗?其中定义的「全局变量」计数器,能正确获取到空字符的数量吗?
1. 本地运行测试
我们都知道,这种分布式计算引擎的代码,既能运行在分布式集群上,也可以运行在本地的单机(多线程)环境下。
先让它跑在本地的 IDEA 环境试试看,如果一切正常,这个计数器应该得出的值为 28 (数据中有28个空字符)。
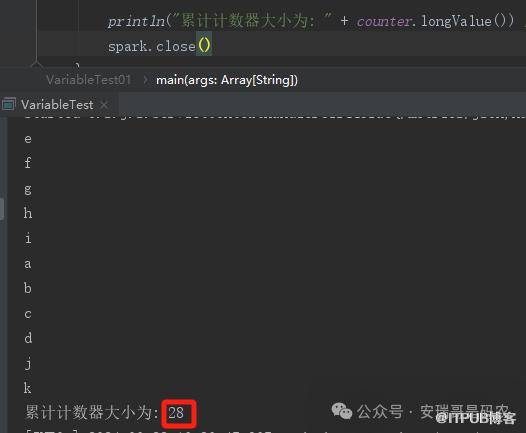
从跑出的结果来看,一切正常。
但你是不是就认为,当前代码就完全没有问题了呢?
2. 提交集群运行测试
做过大数据开发的老手们应该都知道,本地运行可以,并不代表着提交到集群也能万事大吉。
不信,咱提交到 yarn 上试试看。

让它们分别运行在了2台不同的服务器,4个不同的 JVM 中(1个driver,3个 executor)。
先看 driver 的输出日志:

再来分别看看3个 executor 的输出日志:

第1个executor的输出
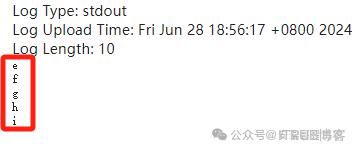
第2个executor的输出

第3个executor的输出
从实测结果来看,executor 的输出结果没有问题,但 driver 输出的计数器为 0。
怎么样?有没有种瞬间懵逼的感觉。
为毛本地跑好好的,上集群后就不行了呢?
3. 原因分析
这就是我在开头提到的,对于一个可以在分布式环境下运行的任务来说,变量的识别,在单进程运行环境下,跟多进程环境下运行,是不一样的。
单进程运行环境下:
刚才在 idea 中跑出来的结果,就是在单进程,多线程下运行的,这个时候它的运行环境,因为是在1个 JVM 内部,所以跟我们的普通 Java 程序没有区别,你定义的全局变量,自然就可以被整个类识别并操作。
多进程(分布式)运行环境下:
当一个分布式程序运行在多台机器(多个 JVM)上时,情况就变得复杂了,这个时候,你就需要严格区别程序的两个角色,「driver」跟「executor」。
driver 是整个程序的管理者,包含管理这个全局变量,它的核心工作是给 executor 下发「计算任务」,自己就只是监督它们干活,管理状态等等。
而在 executor 内部,它只负责对「分布式算子内部」的数据进行计算,也只能识别算子内部的数据处理逻辑,超出这个作用域之外的部分,它就不认识了。
所以,这个时候,当我们试图在「分布式算子内部」去操作原本属于 driver 的变量时,是做不到的。
这也是为什么上面3个 executor 能正常打印处理后的数据,而在打印最终的计数器时,结果为0,因为在 executor 内部,它们都操作了一个根本不认识的对象。
4. 如何解决
既然用上面的全局变量方法不靠谱,但同时我又想实现,记录数据中出现空字符数量的需求,该怎么办?
这个时候,就该祭出 Spark 的一个特殊对象——「累加器」(有的同学可能会说广播变量,但广播变量是只读的,修改不了值)。
它就是用来,在 driver 端定义,但同时又能在 executor 端被识别和操作的对象,专门用来解决当前这种需求的。
所以修改后的代码长这样:
package com.anryg.bigdata.test.variable

import org.apache.spark.SparkConf
import org.apache.spark.sql.SparkSession

/**
  * @DESC: Spark 累加器的使用测试
  * @Auther: Anryg
  * @Date: 2024/6/28 20:21
  */
object VariableTest02 {

    def main(args: Array[String]): Unit = {
        val sparkConf = new SparkConf()
        sparkConf.setAppName("VariableTest02")
        //sparkConf.setMaster("local[*]")

        val spark = SparkSession.builder().config(sparkConf).getOrCreate()

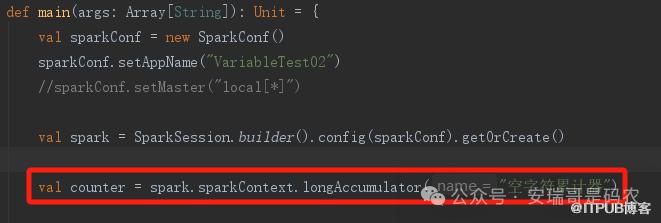
        val counter = spark.sparkContext.longAccumulator("空字符累计器")

        val seq = Seq("a","", "", "", "", "", "", "","b", "c", "", "d", "", "e", "f", "g", "h", "i", "", "", "", "", "", "", "", "", "j","", "", "", "", "", "", "", "k", "", "", "", "")
        spark.sparkContext.makeRDD(seq, 10) /**生成 RDD 对象*/
                .foreach(str => {
                    if (str.equals("")) counter.add(1) /**遇空开始计数*/
                    else println(str)  /**打印不为空的数据*/
                })

        println("累计计数器大小为: " + counter.value) /**打印计数器的大小*/

        spark.close()
    }
}
首先在本地环境测试,测试结果没有问题,这里就不贴出来了。
接着,再提交到 yarn 集群,直接看 driver 端的日志输出:
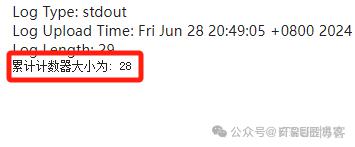
从输出结果来看,终于到达了期望的 28 这个数字,说明用「累加器」才是当前这个问题的正解。
最后
估计有细心的同学可能发现了一个小问题,那就是,当我在用「全局变量」时,这个变量的定义,是在类中的。
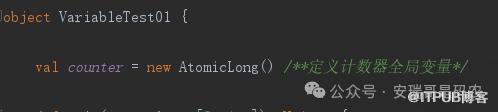
而在定义「累加器」时,是在 main 函数中的。
你可能好奇,如果我把第1个程序中,「全局变量」定义的位置,也给挪到 main 函数中,是不是就能识别了呢?
其实这个我也实测了,一样不能,原因还是那句话:driver 端的(普通)对象,executor 端直接识别不了。
这,就是为什么要用到「累加器」的原因。
原文作者:安瑞哥是码农;如有侵权,请联系管理员删除。

