应该有很多同学都用过 Spark 的 JDBC 方式读取过数据库,一般来说,能想到用 JDBC 来解决数据源的读取问题,算是一种下策。
毕竟,对于那些兼容得更好的数据系统来说,Spark 会提供专门的 connector,比如之前用过的 kafka connector、elasticsearch connector、doris connector 等等,而且官网还会提供专门的 API,易用性更强(类比 Flink 也是一样的)。
但是,到了 Clickhouse(下称CK) 这里,似乎并不怎么受到 Spark 的待见,全系版本都没有推出专门的 CK connector(Flink 更是),但好在,我们还有个通用的 JDBC 方案兜底。
那么今天这篇文章,就借助我在实际工作中遇到的, Spark 读取 CK 作为数据源的案例,来聊聊,Spark 使用 JDBC 方案读取数据库时,应该注意的几个地方。
0. 关于 Spark JDBC
在利用外部工具对数据库的数据进行读取前,我们需要确认一点,那就是如果我们要对数据库的数据进行条件筛选的话,比如用 SQL,这个 SQL 是工具(比如Spark)支持的 SQL 呢?还是数据库本身支持的 SQL ?
对于这两者的区别,我们把它叫做 SQL dialect (SQL 方言),他们隶属于不同系统的 catalog。
比如,当我们用 Flink 的时候,可以在编码的时候显示指定某个 catalog 来使用不同的 SQL 方言,但是对于 Spark 的 JDBC 来说,却没有对使用者显示提供这种选择。
但是,没有显示提供,并不代表它不能。
1. 不能使用数据库 catalog 的情况
这种方式是 Spark JDBC 读取数据库表最简洁的写法。
package test

import java.util.Properties
import org.apache.spark.SparkConf
import org.apache.spark.sql.SparkSession

/**
  * @DESC: Spark通过CK jdbc 读取 CK 表,不能用 CK 的 SQL 方言情况
  * @Auther: Anryg
  * @Date: 2024/6/25 11:00
  */
object SparkWithoutCKDialect {

    def main(args: Array[String]): Unit = {
        val sparkConf = new SparkConf().setAppName("SparkWithoutCKDialect").setMaster("local[*]")
        val spark = SparkSession.builder().config(sparkConf).getOrCreate()

        /**CK属性配置*/
        val propertiesCK = new Properties()
        propertiesCK.put("user","default")
        propertiesCK.put("password", "xxx")
        propertiesCK.put("pushDownPredicate", "true")

        import org.apache.spark.sql.functions._  /**引入spark SQL内置函数*/

        val rawDF = spark.read
            .option("driver", "com.clickhouse.jdbc.ClickHouseDriver")
            .jdbc("jdbc:clickhouse://${CK_HOST}:${PORT}",
            "${DB_NAME}.${TABLE_NAME}",
            propertiesCK).select("${YOUR_COL}")

        rawDF.show(false)
    }
}
比如,如果这个时候,我要读取 CK 表中,某个 json 类型数据的内部字段,用 CK SQL 的查询结果是这样的。
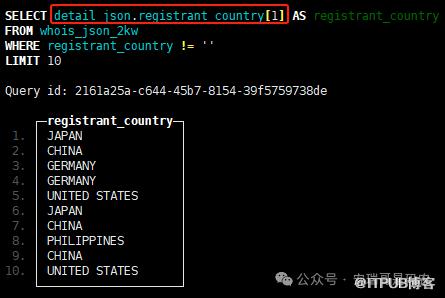
用 CK SQL 的查询结果
而如果我用当前这种 Spark JDBC 的方式,它就识别不了。
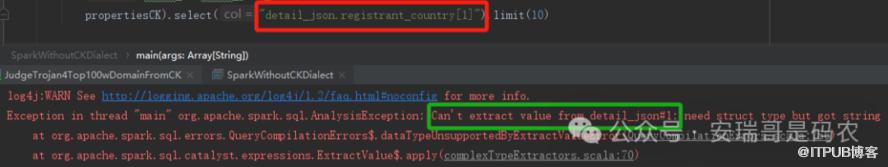
用 Spark SQL 的查询结果
这个时候,即便是你刻意把 JDBC 的「谓词下推」设置打开,也没有卵用。
代码中,数据读取的 where 条件是没有办法下推到 CK 数据库的。
很明显,程序当前使用的是 Spark 默认的 catalog,也就是 Spark SQL,它识别不了当前这个只有 CK 才支持的特殊 column 类型。
2. 使用数据库 catalog 的情况
相比上面,能使用 CK catalog 的写法。
package test

import java.util.Properties

import org.apache.spark.SparkConf
import org.apache.spark.sql.SparkSession

/**
  * @DESC: Spark通过CK jdbc 读取 CK 表,可以用 CK 的 SQL 方言, 以及利用数据库本身的“谓词下推”功能
  * @Auther: Anryg
  * @Date: 2024/6/25 11:10
  */
object Spark4CKDialect {

    def main(args: Array[String]): Unit = {
        val sparkConf = new SparkConf().setAppName("Spark4CKDialect").setMaster("local[*]")
        val spark = SparkSession.builder().config(sparkConf).getOrCreate()

        val rawDF = spark.read
                        .format("jdbc")
                        .option("url", "jdbc:clickhouse://${CK_HOST}:${PORT")
                        .option("driver", "com.clickhouse.jdbc.ClickHouseDriver")
                        .option("user", "default")
                        .option("password", "xxx")
                        .option("query",  /**这种方式可以用到 CK 的方言,以及谓词下推功能*/
                            """
                              |SELECT
                              |detail_json.registrant_country[1] as registrant_country
                              |FROM
                              |${DB_NAME}.${TABLE_NAME}
                              |WHERE
                              |registrant_country != ''
                              |limit 10
                            """.stripMargin)
                        .load()

        rawDF.show(false)
    }
}
注意跟第1种写法的差别。
现在,就可以用完全的 CK SQL 来正常读取 CK 字段类型为 json 的数据了。
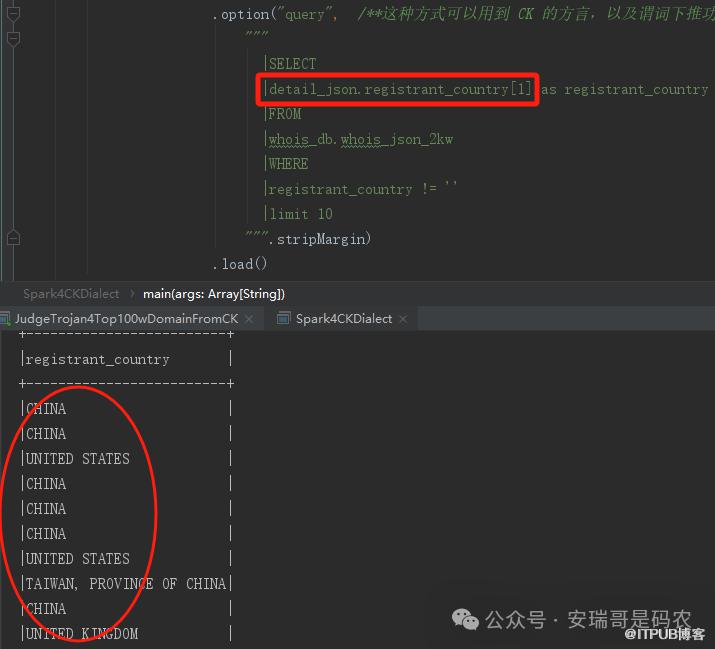
3. 对比谓词下推跟不推的效率区别
换个玩法,以一个业务的数据检查项目中,统计各个没有通过项目的个数前5为例。
先看不利用 CK catalog 的 Spark SQL 写法(不能进行谓词下推)的查询效率。
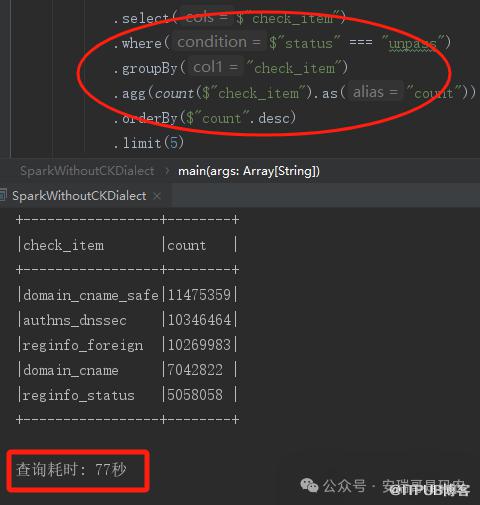
整个进程跑完,耗时:77 秒。
再看利用 CK catalog 的 CK SQL 写法(可以利用谓词下推)时的查询效率。

整个进程跑完,耗时:27 秒。(忽略跟上面的统计结果不太一样,因为后台数据一直在增长)
从对比结果可以看出来,「下推」比「不下推」快了整整 50 秒。
但你可能会怀疑说,这最快的也要27秒,也挺慢的呀! 但别忘了,我这统计的可是整个进程运行完的时间,要知道,对于 Spark 来说,它的 context 初始化时间,都需要至少十几秒钟呢。
最后
从上面两种不同的,利用 Spark JDBC 读取 CK 的写法来看(其他数据库也一样),虽然都谈不上什么难度,但就是因为在写法上的那么一丢丢差别,导致在实际开发过程中,有些同学就很容易犯错。
从这次的实测对比来看,虽然第1种 Spark JDBC 的写法更加简洁一点,但付出的代价是:
1. 无法利用数据库自身的 SQL dialect 便利,比如,对一些特殊类型字段的内容查询就用不了;
2. 也不能用到数据库查询时的「谓词下推」,查询效率会大打折扣。
而第2种 Spark JDBC 的写法 ,虽然麻烦一点点,但如果你不想读取数据库表的全量数据,则完全可以利用数据库自身的 SQL dialect, 快速筛选目标数据,提升必要的数据处理效率。
原文作者:安瑞哥是码农;如有侵权,请联系管理员删除。

