用过 Spark 开发的同学们,很多人应该遇到过这样的场景,那就是如果你的数据处理过程稍微复杂一点,比如,在对「主数据」进行计算过程中,需要引入一个,跟主数据系统不同的「外部系统数据源」,你一般会考虑怎么做?
0. 举个栗子
比如,你当前的业务目的,是用 Spark 从数据源的域名信息中,过滤掉那些属于非法的域名。
此时的数据来源可以是 Kafka,或者 MySQL、Clickhouse、Doris、HDFS 等任何数据存储系统,而此时,我们需要引入一个外部的“域名黑名单”,来跟当前的主数据进行“碰撞”,从而筛选出主数据中的合法域名。
而这个黑名单数据,如果存储在 Redis 中,该如何操作?
1. 数据源说明
对于一般比较简单的 Spark 开发程序来说,主数据一般也就一个,或者就算是多个,也是在同一个系统里,用 Spark SQL 轻轻这么一 join,就可以把它们给合二为一。
但今天这个场景,数据来源分属不同系统,显然用关联的方式是行不通的。
先来看主数据,因为它不是今天的主角,同时也为了方便演示,这里我直接就在代码里构造得了。
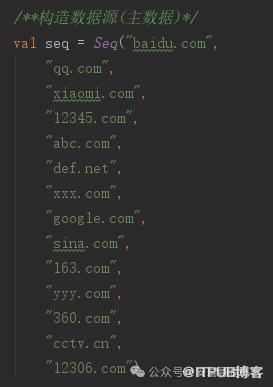
主数据由一系列域名构成,实际工作中,它们可能来自任何一个数据存储系统。
再来看 Redis 中的黑名单数据。
这个黑名单放在一个 key 为 「black_domain」, vlaue 为 Set 类型的数据结构里。
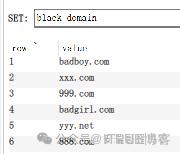
看到这个黑名单,你是不是觉得:「我靠,就区区6条,还用费这劲,我直接在代码写死不就完了吗?」
「肤浅了吧,如果这个黑名单有十万、百万之众呢?是不是这么干就有道理了。」
当然,这里的 Redis 也可以是任何其他数据库,思路是一样的。
2. 黑名单数据如何引入
在明晰了主数据,跟黑名单数据这两者的背景之后,接下来,就是要解决它们如何实现「碰撞」的问题。
要引入 Redis 中的黑名单数据,既然不能用普通的 join,那我们最容易想到的,就是基于 Java 的 Jedis。
用过 Jedis 的同学应该都知道,Jedis 虽好,但如果它的连接管理,你玩不转的话,尤其是对于一个分布式任务来说,后果一定是灾难级的。
咋整?
为了保证计算过程中,不会出现过多的 Redis 连接,从而导致 Redis 不可用,其中一个保险的做法是——用连接单例(当然,还有别的方案)。

红框中,是我已经封装出来的,用 Jedis 构建的一个单例连接客户端,通过它来获取 Redis 中的黑名单数据。
怎么样,看起来还挺简单的对不对?但是,如果你想把整个程序真正跑起来,可能并没有那么简单。
不信,咱往下看。
3. 一种普通的写法
这是一个典型的,普通 Java 程序员思维的写法。
package com.anryg.bigdata.test.variable

import java.util

import com.anryg.bigdata.RedisClientUtils
import org.apache.log4j.{Level, Logger}
import org.apache.spark.SparkConf
import org.apache.spark.sql.SparkSession

/**
  * @DESC: 测试 Spark 如何读取外部数据源
  * @Auther: Anryg
  * @Date: 2024/7/2 17:09
  */
object SparkReadExternalDataTest01 {

    /**
      * @DESC: 从Redis读取黑名单数据
      * */
    private def getBlackDomain(): util.Set[String] ={
        val blackDomain = RedisClientUtils.getSetResult(RedisClientUtils.getSingleRedisClient, /**用Jedis连接单例来获取黑名单数据*/
            5, /**Redis的db编号*/
            "black_domain"  /**对应黑名单的key*/
        )
        blackDomain
    }

    def main(args: Array[String]): Unit = {
        Logger.getLogger("org.apache.spark").setLevel(Level.WARN)
        val sparkConf = new SparkConf().setAppName("SparkReadExternalDataTest01")
            .setMaster("local[3]")
        val spark = SparkSession.builder().config(sparkConf).getOrCreate()

        /**构造数据源(主数据)*/
        val seq = Seq("baidu.com",
            "qq.com",
            "xiaomi.com",
            "12345.com",
            "abc.com",
            "def.net",
            "xxx.com",
            "google.com",
            "sina.com",
            "163.com",
            "yyy.net",
            "360.com",
            "cctv.cn",
            "12306.com")

        spark.sparkContext.makeRDD(seq) /**生成 RDD 对象*/
            .foreachPartition(iter => {
                val blackDomain = getBlackDomain() /**获取黑名单数据*/
                while (iter.hasNext){
                    val domain = iter.next()
                    if (!blackDomain.contains(domain)) println(domain)  /**碰撞后,输出合法域名*/
                }
        })
    }
}
先花20秒读一下这个代码,猜一下,它能在本地跑起来吗?
如果不能,用最简单的改动,改哪里就可了呢?
4. 运行结果
来,先看在本地运行后的第一个异常:
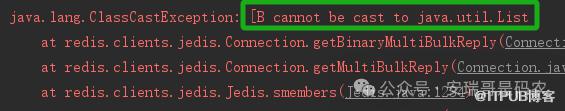
从错误提示来看,你以为它是数据转换导致的问题(代码逻辑中,其实没有任何数据转换操作),但如果你再跑一次试试。
一模一样的代码,它又抛出了下面的异常:
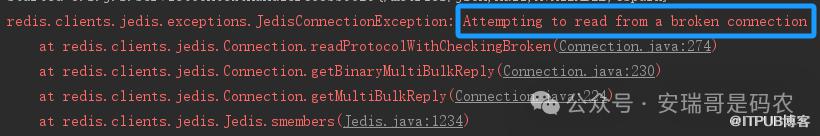
两次运行,得出两个完全不一样的错误,就问你害不害怕(你要再敢跑第三次,异常又会不一样,你信不信?)。
如果我告诉你,只需要把这个地方原来的「3」,给改为「1」。

所有的异常就都不存在了,你信不?
再看一眼把这个「3」给改为「1」之后的运行结果:
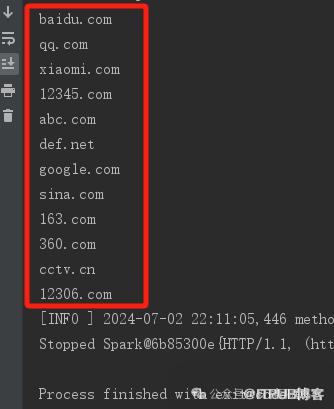
从输出结果来看,很明显,那两个黑名单域名「xxx.com」跟「yyy.net」已经被碰撞掉了,符合预期。
而这个罪魁祸首的数字 3 (事实上,任何一个大于 1 的数都不行),指的是当前程序处理数据的并行度。
5. 原因分析
那为什么改为 1 就可以了呢?
核心原因在于当前程序,只用了1个「单例连接」,所谓单例,就是在一个 JVM 内部,对象全局唯一,也就是这个连接 Redis 的连接对象,在整个程序中,有仅只有1个。
而对于当前这个在本地运行的 Spark 程序来说,它也只会启动一个 JVM,也就是单个进程,但是,会启动 3 个数据处理线程,而代码中,调用那个获取 Redis 黑名单数据的方法,是在线程内部执行的(foreachPartition),所以,它会被 3 个线程同时调用。
也就是说,在程序运行时,会存在 3 个线程,在同一时间,同时争抢 1 个连接对象的情况,而一个连接对象,在同一时间,又只能被一个线程使用,所以就抛出了上面截图出来的诡异异常(事实上,还可以有更多不一样的异常情况出现)。
如果有兴趣,你也可以去试试。
最后
将上面线程数 3 改为 1,只能算是一种最简单,但同时又最笨拙的解决办法。
在给出我认为更优的解决方案之前,我希望你能思考下面两个问题:
1, 上面的代码不变,如果我提交到集群(要求分布式运行),需要怎么设置参数,才能保证不报错?
2,如果优化上面的代码,让它可以「多进程 + 多线程」的方式运行(本地跟集群都可以),有哪些方法?
答案将在下期揭晓,当然,也期待你的互动。
原文作者:安瑞哥是码农;如有侵权,请联系管理员删除。

