#!/usr/bin/env bash
#########################################
##
#Desc: 模拟真实的数据生产行为,将原始数据文件的内容逐行读到准备区文件中
#
#Author: Anryg
#
##########################################
set -o nounset #必须使用初始化之后的变量
set -o errexit #命令执行过程中如果有报错,直接退出整个脚本
###################################################
#
# _LOG
#
####################################################
# $1 - message
# $2 - log file
_LOG() {
        message="[$(date +'%Y-%m-%d %H:%M:%S') ${0##*/}] $1"
        echo ${message}
        if [[ $# == 2 ]]; then
                echo ${message} >>$2  ##指定日志文件
        fi
}
#################################################
current_dir=$(cd `dirname $0`; pwd)  ##获取程序所在的绝对路径
batch_num=100    #推送100条数据到kafka之后,sleep一次
current_num=0    ##当前已经推送kafka数量的计数器

while read line
    do
        echo "${line}" >> staging.csv ##将读取的数据写入到准备区文件中
        let current_num+=1  ##推送次数自增
        if [[ ${current_num} -eq ${batch_num} ]]; then
            sleep 1  ##每间隔1秒写一次
            current_num=0 ##计数器归位
        fi
    done < $1  ##指定数据源文件

_LOG "数据文件写入完毕..." ${current_dir}/staging.log

exit 0
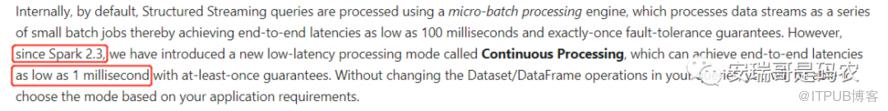
package com.anryg.bigdata.streaming

import java.util.concurrent.TimeUnit

import com.alibaba.fastjson.JSON
import org.apache.spark.SparkConf
import org.apache.spark.sql.SparkSession
import org.apache.spark.sql.streaming.{OutputMode, Trigger}

/**
  * @DESC:  从kafka读取上网行为数据
  * @Auther: Anryg
  * @Date: 2022/08/08 09:56
  */
object StructuredStreamingFromKafka {

    def main(args: Array[String]): Unit = {
        val conf = new SparkConf().setAppName("StructuredStreamingFromKafka").setMaster("local[*]")
        val spark = SparkSession.builder().config(conf).getOrCreate()

        val rawDF = spark.readStream
            .format("kafka") //确定数据源的来源格式
            .option("kafka.bootstrap.servers", "192.168.211.107:6667") //指定kafka集群的地址,理论上写一个broker就可以了
            .option("subscribe","test")  //指定topic
            //.option("group.id","test9999") /**不再用该方式来绑定offset,而是每个程序有个唯一的id,该id跟checkpointLocation绑定,虽然group.id属性在运行中依然保留,但是不再跟offset绑定*/
            .option("failOnDataLoss",false)  //如果读取数据源时,发现数据突然缺失,比如被删,则是否马上抛出异常
            .option("fetchOffset.numRetries",3)  //获取消息的偏移量时,最多进行的重试次数
            //.option("maxOffsetsPerTrigger",100)/**用于限流,限定每次读取数据的最大条数,不指定则是as fast as possible*/
            .option("startingOffsets","latest")  //第一次消费时,读取kafka数据的位置
            .load()

        import spark.implicits._
        val ds = rawDF.selectExpr("CAST(value AS STRING)")  //将kafka中的数据的value转为为string,原始为binary类型
                        .map(row => {
                            val line = row.getAs[String]("value") //获取row对象中的field,其实也只有一个field
                            val rawJson = JSON.parseObject(line)      //原始string是一个json,对其进行解析
                            val message = rawJson.getString("message")  //获取业务数据部分
                            val msgArray = message.split(",")  //指定分隔符进行字段切分
                            msgArray
                        }).filter(_.length == 9)  //只留字段数为9的数据
                        .map(array => (array(0),array(1),array(2),array(3),array(4),array(5),array(6),array(7),array(8))) //将其转化成为元组,为了方便下一步赋予schema
                        .toDF("client_ip","domain","time","target_ip","rcode","query_type","authority_record","add_msg","dns_ip") //给裸数据添加字段名

        ds.printSchema() //打印schema,确认没有问题

        val query = ds.writeStream
            .outputMode(OutputMode.Append())  //指定数据的写入方式
            .format("console")  //指定外部输出介质
            //.trigger(Trigger.ProcessingTime(60,TimeUnit.SECONDS))/**每60秒执行一次,不指定就是as fast as possible*/
            .option("checkpointLocation","hdfs://192.168.211.106:8020/tmp/offset/test/kafka_datasource-05") /**用来保存offset,用该目录来绑定对应的offset,如果该目录发生改变则程序运行的id会发生变化,类比group.id的变化*/
            .start()

        query.awaitTermination()
    }

}
    <dependencies>
        <!--主要提供SparkConf和SparkContext对象-->
        <dependency>
            <groupId>org.apache.spark</groupId>
            <artifactId>spark-core_2.12</artifactId>
            <version>3.2.0</version>
        </dependency>
      <!--主要提供SparkSession对象-->
        <dependency>
            <groupId>org.apache.spark</groupId>
            <artifactId>spark-sql_2.12</artifactId>
            <version>3.2.0</version>
        </dependency>
      <!--主要提供Structured streaming读取kafka-->
        <dependency>
            <groupId>org.apache.spark</groupId>
            <artifactId>spark-sql-kafka-0-10_2.12</artifactId>
            <version>3.2.0</version>
        </dependency>
        <!--通过json转换-->
        <dependency>
            <groupId>com.alibaba</groupId>
            <artifactId>fastjson</artifactId>
            <version>1.2.71</version>
        </dependency>
        <!--hdfs客户端依赖-->
        <dependency>
            <groupId>org.apache.hadoop</groupId>
            <artifactId>hadoop-client-api</artifactId>
            <version>3.3.1</version>
        </dependency>
    </dependencies>
原文作者:安瑞哥是码农;如有侵权,请联系管理员删除。
上一篇:
经验不足,被问大数据项目问题,咋整?
下一篇:
实战大数据项目第1步——模拟数据源接入

请登录后发表评论
登录
全部评论
