
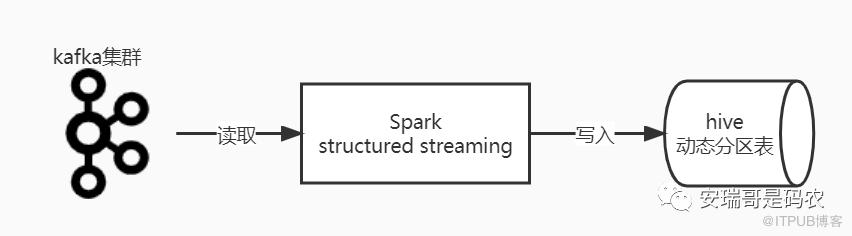
因为spark2 + hive3坑实在太多,而且网上关于他们解决方案的资料也凤毛麟角,为了提高开发效率,我干脆把spark2升级到了spark3,因为官网说spark3解决了与hive3的兼容性问题,详情也可参考之前的文章().
1,kafka:2.0.0版本,HDP3.1自带;
2,spark:3.2.0版本,由原来HDP中的2.3版本升级而来;
3,hive:3.0.0版本,HDP3.1自带;
package com.anryg.bigdata.streaming

import java.util.concurrent.TimeUnit

import com.alibaba.fastjson.JSON
import org.apache.spark.SparkConf
import org.apache.spark.sql.SparkSession
import org.apache.spark.sql.streaming.{OutputMode, Trigger}

/**
  * @DESC:  从kafka读取上网数据,写入hive动态分区表
  * @Auther: Anryg
  * @Date: 2022/08/17 12:56
  */
object StructuredStreamingFromKafka2Hive {

    def main(args: Array[String]): Unit = {
        val conf = new SparkConf()
                .setAppName("StructuredStreamingFromKafka2Hive")
                .setMaster("local[*]")//本地运行模式,如果提交集群,注释掉这行
        val spark = SparkSession.builder().config(conf)
                .config("spark.sql.hive.hiveserver2.jdbc.url","jdbc:hive2://xxxxxx/;serviceDiscoveryMode=zooKeeper;zooKeeperNamespace=hiveserver2")
                .config("spark.datasource.hive.warehouse.metastoreUri","thrift://xxxxxxx:端口")
                .enableHiveSupport() //打开hive支持功能,可以与hive共享catalog
                .getOrCreate()

         val rawDF = spark.readStream
            .format("kafka") //确定数据源的来源格式
            .option("kafka.bootstrap.servers", "xxxxxx:端口") //指定kafka集群的地址,理论上写一个broker就可以了
            .option("subscribe","test")  //指定topic
            .option("failOnDataLoss",false)  //如果读取数据源时,发现数据突然缺失,比如被删,则是否马上抛出异常
            .option("fetchOffset.numRetries",3)  //获取消息的偏移量时,最多进行的重试次数
            .option("maxOffsetsPerTrigger",500)/**用于限流,限定每次读取数据的最大条数,不指定则是as fast as possible*/
            .option("startingOffsets","earliest")  //第一次消费时,读取kafka数据的位置
            .load()

        import spark.implicits._
        val ds = rawDF.selectExpr("CAST(value AS STRING)")  //将kafka中的数据的value转为为string,原始为binary类型
                        .map(row => {
                            val line = row.getAs[String]("value") //获取row对象中的field,其实也只有一个field
                            val rawJson = JSON.parseObject(line)      //原始string是一个json,对其进行解析
                            val message = rawJson.getString("message")  //获取业务数据部分
                            val msgArray = message.split(",")  //指定分隔符进行字段切分
                            msgArray
                        }).filter(_.length == 9)  //只留字段数为9的数据
                        .filter(array => array(2).length >= 8)//确保日期字段符合规范
                        .map(array => (array(0)+array(1)+array(2),array(0),array(1),array(2),array(3),
                if(array(4).isInstanceOf[Int]) array(4).toInt else 99,array(5),array(6),array(7),array(8),array(2).substring(0,4),array(2).substring(4,6),array(2).substring(6,8))) //将其转化成为元组,为了方便下一步赋予schema
                        .toDF("id","client_ip","domain","time","target_ip","rcode","query_type","authority_record","add_msg","dns_ip","year","month","day") //给裸数据添加字段名

        ds.printSchema() //打印schema,确认没有问题

        val query = ds.writeStream
            .outputMode(OutputMode.Append())  //指定数据的写入方式
                .format("orc")  //指定外部输出的文件存储格式
                .option("format", "append")
                .trigger(Trigger.ProcessingTime(10,TimeUnit.SECONDS))/**每60秒执行一次,不指定就是as fast as possible*/
                .option("checkpointLocation","hdfs:/xxxxx:8020/tmp/offset/test/StructuredStreamingFromKafka2Hive") /**用来保存offset,用该目录来绑定对应的offset,如果该目录发生改变则程序运行的id会发生变化,类比group.id的变化,写hive的时候一定不要轻易变动*/
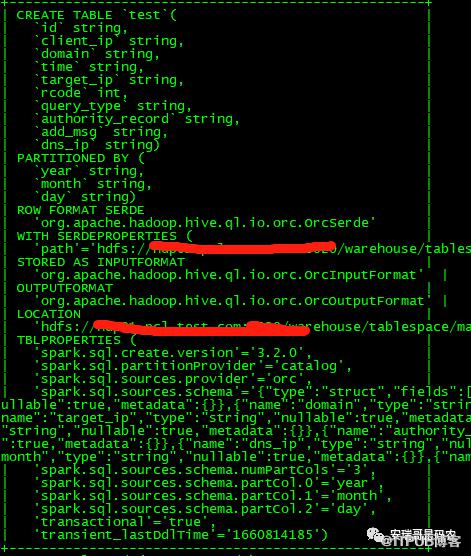
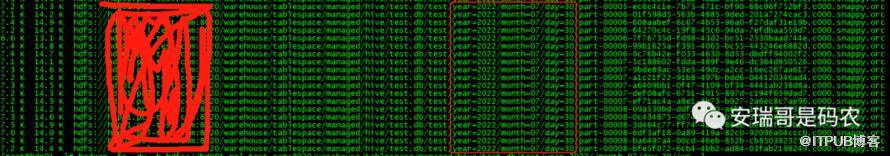
                .partitionBy("year","month","day")//提供分区字段
                .toTable("test.test")//写入hive表
        query.awaitTermination()
    }

}
为了方便,还是以一镜到底的方式把全部逻辑都写在main方法中,但是如果是在生产环境中,千万别这么干,容易被你的leader揍。
<dependencies>
        <!--主要提供SparkConf和SparkContext对象-->
        <dependency>
            <groupId>org.apache.spark</groupId>
            <artifactId>spark-core_2.12</artifactId>
            <version>3.2.0</version>
        </dependency>
        <!--提供SparkSession对象-->
        <dependency>
            <groupId>org.apache.spark</groupId>
            <artifactId>spark-sql_2.12</artifactId>
            <version>3.2.0</version>
        </dependency>
        <!--spark读取kafka的connector-->
        <dependency>
            <groupId>org.apache.spark</groupId>
            <artifactId>spark-sql-kafka-0-10_2.12</artifactId>
            <version>3.2.0</version>
        </dependency>
        <!--通过json转换-->
        <dependency>
            <groupId>com.alibaba</groupId>
            <artifactId>fastjson</artifactId>
            <version>1.2.71</version>
        </dependency>
        <!--提供spark读取hive-->
        <dependency>
            <groupId>org.apache.spark</groupId>
            <artifactId>spark-hive_2.12</artifactId>
            <version>3.2.0</version>
        </dependency>
    </dependencies>
|最后
任何新的技术或者api,在第一次使用的时候一定会遇到很多坑,这是每一个学大数据人的必经之路,能否坚持住并趟过这些坑,是你水平增长的关键。
原文作者:安瑞哥是码农;如有侵权,请联系管理员删除。
上一篇:
工作这么难找,还去面试吗?
下一篇:
大数据开发,真的只能写SQL吗?

请登录后发表评论
登录
全部评论
