利用临近点均值法,将缺失值填充:
要求用scala编写spark的处理程序,临近点定义为缺失处的上下n个元素,n<=4。要考虑大数据量情况下,不出现内存溢出。
输入:DataFrame(自己造测试数据,行数为2000万以上,列数至少要有2列以上,每一列随机产生一些空数据);
输出:经过缺失值填充后的DataFrame;
|解题思路
对于一般的数据处理思路,我们要么是针对每一条数据去应用我们的数据处理逻辑,要么是以一个分区的粒度为单位进行数据处理,典型的算子分别为map或者mapPartition。
但是对于这个题目来说,好像这两种方法都失效了,因为它要求的是,当处理到当前行数据时,如果当前行数据的某个字段值为空,那么需要根据上下n行(n=4)数据中该字段值的平均值来进行填充。
这个时候,传统的解题思路好像不奏效了。
咋整?
当我们在处理每一行数据时,同时要知道与当前行前后存在一定逻辑关系的其他行数据信息时,此时就需要要用到spark的窗口函数。
而这题的条件已经非常明显的在告诉你,在每次处理一个行时(当某个字段为空情况下),需要知道该行前后n行的数据情况,于是用窗口函数是没跑了。
再来看其他条件:考虑大数据量,不出现内存溢出,然后说数据量有2000万以上,至少2列以上数据。
我们来算一下200万数据量,3列的情况会有多大,假如我们用最浪费内存的string类型来存储所有列的数据,我们知道一个字符占用1个byte,就算1个字段有10个字符组成,也就是10byte大小,那么3列加起来,一行数据也就30byte,就算读到内存中之后,用容器进行存放,给它算到一行占用50byte,够多了吧。
即便是这样,2000万行数据我们就算按照50byte每行计算,也就不到1G的大小,虽然在数据处理过程中会通过窗口函数进行聚合操作,但是也就前后8行而已(n=8),这点资源对于spark不是小case吗?
|上代码
解题思路分析清楚了,那么接下来就是show you the code时间。
import org.apache.spark.SparkConf
import org.apache.spark.sql.SparkSession
import org.apache.spark.sql.expressions.Window
import org.apache.spark.sql.types.FloatTypeobject SparkWindowAgg1 {
    def main(args: Array[String]): Unit = {
        val sparkConf = new SparkConf().setAppName("一道面试题").setMaster("local")

        val spark = SparkSession.builder().config(sparkConf).getOrCreate()

        import spark.implicits._  /**引入隐式转换对象*/
        import org.apache.spark.sql.functions._  /**引入spark内置函数*/

        val df1 = Seq((1, "a", 7), (2, "a", 0), (3, "a", 6), (4, "b", 2), (9,"c", 8), (7, "d", 5), (5, "b",0), (6, "b", 1))
         .toDF("id", "category", "score") //定义数据源,这里只是举个栗子

        val window = Window.rowsBetween(-4, 4) /**定义窗口对象,确定应用的数据窗口*/
        val df2 = df1.withColumn("score", when (column("score") === 0, avg($"score") over window)
                .otherwise(column("score")))/**通过对空值字段进行基于窗口期数据求均值,并对空值进行替换*/
        df2.show()
    }
}
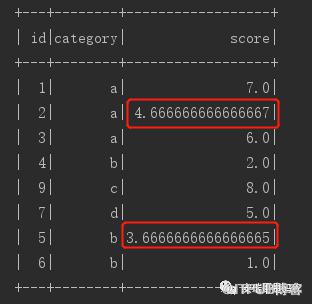
import org.apache.spark.SparkConf
import org.apache.spark.sql.SparkSession
import org.apache.spark.sql.expressions.Window
import org.apache.spark.sql.types.FloatTypeobject SparkWindowAgg2 {
    def main(args: Array[String]): Unit = {
        val sparkConf = new SparkConf().setAppName("一道面试题").setMaster("local")

        val spark = SparkSession.builder().config(sparkConf).getOrCreate()

        import spark.implicits._  /**引入隐式转换对象*/
        import org.apache.spark.sql.functions._  /**引入spark内置函数*/

        val df1 = Seq((1, "a", "7"), (2, "a", ""), (3, "a", "6"), (4, "b", "2"), (9,"c", "8"), (7, "d", "5"), (5, "b",""), (6, "b", "1"))
         .toDF("id", "category", "score") //定义数据源,这里只是举个栗子

        val window = Window.rowsBetween(-4, 4) /**定义窗口对象,确定应用的数据窗口*/
        val df2 = df1.withColumn("score", when (column("score") === "", avg($"score".cast(FloatType)) over window)
                .otherwise(column("score").cast(FloatType)))/**通过对空值字段进行基于窗口期数据求均值,并对空值进行替换*/
        df2.show()
    }
}
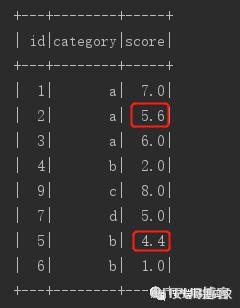
|最后
至于题目中说的考虑效率,目前这种写法,应该就是我目前想到的,最简的解决问题的方式了。
如果你有更好的解决方案,找我切磋哈。

原文作者:安瑞哥是码农;如有侵权,请联系管理员删除。

