从2021年7月7日0点开始,用户每天签到可以领1金币,并可以开始累积签到天数,连续签到的第3、7天分别可额外领2、6金币。每连续签到7天后重新累积签到天数(即重置签到天数:连续第8天签到时记为新的一轮签到的第一天,领1金币) 问题:计算每个用户2021年7月以来每月获得的金币数(该活动到10月底结束,11月1日开始的签到不再获得金币)。结果按月份、ID升序排序。
注:如果签到记录的in_time-进入时间和out_time-离开时间跨天了,也只记作in_time对应的日期签到了。
uid,article_id,in_time,out_time,if_sign101, 0, "2021-07-07 10:00:00", "2021-07-07 10:00:09", 1101, 0, "2021-07-08 10:00:00", "2021-07-08 10:00:29", 1101, 0, "2021-07-09 10:00:00", "2021-07-09 10:00:42", 1101, 0, "2021-07-10 10:00:00", "2021-07-10 10:00:59", 1101, 0, "2021-07-12 10:00:28", "2021-07-12 10:00:43", 1101, 0, "2021-07-13 10:00:32", "2021-07-13 10:00:50", 1101, 0, "2021-07-17 09:00:09", "2021-07-13 10:00:33", 1101, 0, "2021-07-18 09:30:09", "2021-07-13 10:00:50", 1101, 0, "2021-07-19 09:45:09", "2021-07-13 10:00:22", 1101, 0, "2021-07-20 09:58:09", "2021-07-13 10:00:50", 1101, 0, "2021-07-15 10:00:28", "2021-07-13 10:01:22", 1101, 0, "2021-07-16 11:00:28", "2021-07-13 12:00:31", 1101, 0, "2021-07-14 10:00:18", "2021-07-13 10:10:33", 1102, 0, "2021-10-01 10:00:20", "2021-10-01 10:09:50", 1101, 0, "2021-07-11 23:59:45", "2021-07-11 23:59:59", 1102, 0, "2021-10-02 10:00:01", "2021-10-02 10:01:50", 1102, 0, "2021-10-03 11:00:15", "2021-10-03 11:00:59", 1102, 0, "2021-10-04 11:00:45", "2021-10-04 11:00:55", 0102, 0, "2021-10-05 11:00:53", "2021-10-05 11:00:59", 1102, 0, "2021-10-06 11:00:45", "2021-10-06 11:00:55", 1
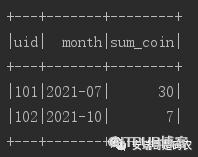
+---+-------+--------+
|uid| month|sum_coin|
+---+-------+--------+
|101|2021-07| 30 |
|102|2021-10| 7 |
+---+-------+--------+
|问题逻辑拆解
这道题首先需要根据if_sign字段来判断用户是否登录系统,1登录,0未登录,以及in_time字段来判断其登录时间,另外当article_id为0时,登录才有效;
其次我们需要计算的数据范围在2021-07-07 00:00:00和2021-10-31 23:59:59之间,其他无效数据提前过滤掉;
对上面条件进行筛选之后,接着我们需要根据uid以及in_time进行分组排序,然后根据其in_time的时间是否连续来确定其是否【连续签到】;
接着就需要根据规则,连续第3天签到额外获得2金币,以及连续第7天签到额外获得6金币进行条件判断,计算出每一次签到应该获得的金币数量;
最后,根据uid以及用户登录的月份时间进行分组聚合,统计出每个uid在每个月的获取金币总数量。
|难点分析
这道题之所以难,原因在于对数据处理的条件过多,除了简单的条件筛选外,
还有2个复杂的逻辑:
1,需要根据uid和in_time字段进行【连续性】判断,来确定每一行数据参与领金币的逻辑;
2,当连续到达一定条件时(连续第3天和连续第7天),其计算逻辑是不一样的,而且在连续签到7天后,其领金币的逻辑需要进行重置;
虽然这道题的难度相对比较高,但是要知道,任何复杂的题目,都可以将其进行逻辑拆解成多个简单的步骤,最后只要能将这些简单步骤【逐个击破】,那么再复杂的问题也可以迎刃而解。
接下来,咱就利用SparkSQL,用庖丁解牛的方式来逐步瓦解这道题。
|第1步:环境准备
这一步,就是将样例数据加载到spark,将原始数据转化成DataFrame,方便后续用spark SQL对其进行sql操作。
上代码:
object SparkSQLTest03 {
    def main(args: Array[String]): Unit = {
        val sparkConf = new SparkConf()
        sparkConf.setAppName("连续登陆领金币问题")
        sparkConf.setMaster("local[*]")

        val spark = SparkSession.builder().config(sparkConf).getOrCreate()
        import spark.implicits._
        val seq = Seq(
            (101, 0, "2021-07-07 10:00:00", "2021-07-07 10:00:09", 1),
            (101, 0, "2021-07-08 10:00:00", "2021-07-08 10:00:09", 1),
            (101, 0, "2021-07-09 10:00:00", "2021-07-09 10:00:42", 1),
            (101, 0, "2021-07-10 10:00:00", "2021-07-10 10:00:09", 1),
            (101, 0, "2021-07-12 10:00:28", "2021-07-12 10:00:50", 1),
            (101, 0, "2021-07-13 10:00:32", "2021-07-13 10:00:50", 1),
            (101, 0, "2021-07-17 09:00:09", "2021-07-13 10:00:50", 1),
            (101, 0, "2021-07-18 09:30:09", "2021-07-13 10:00:50", 1),
            (101, 0, "2021-07-19 09:45:09", "2021-07-13 10:00:50", 1),
            (101, 0, "2021-07-20 09:58:09", "2021-07-13 10:00:50", 1),
            (101, 0, "2021-07-15 10:00:28", "2021-07-13 10:00:50", 1),
            (101, 0, "2021-07-16 11:00:28", "2021-07-13 10:00:50", 1),
            (101, 0, "2021-07-14 10:00:18", "2021-07-13 10:00:50", 1),
            (102, 0, "2021-10-01 10:00:20", "2021-10-01 10:00:50", 1),
            (101, 0, "2021-07-11 23:59:55", "2021-07-11 23:59:59", 1),
            (102, 0, "2021-10-02 10:00:01", "2021-10-02 10:01:50", 1),
            (102, 0, "2021-10-03 11:00:55", "2021-10-03 11:00:59", 1),
            (102, 0, "2021-10-04 11:00:45", "2021-10-04 11:00:55", 0),
            (102, 0, "2021-10-05 11:00:53", "2021-10-05 11:00:59", 1),
            (102, 0, "2021-10-06 11:00:45", "2021-10-06 11:00:55", 1)
        )

        val df = spark.createDataset(seq).toDF("uid","article_id","in_time","out_time","if_sign")
        df.show()
        df.printSchema()

    }
}
        val df1 = df.select($"uid",$"in_time")
                .where(to_date($"in_time").between("2021-07-07 00:00:00","2021-10-31 23:59:59"))
                .where($"article_id" === 0 and $"if_sign" === 1 )
        df1.show()
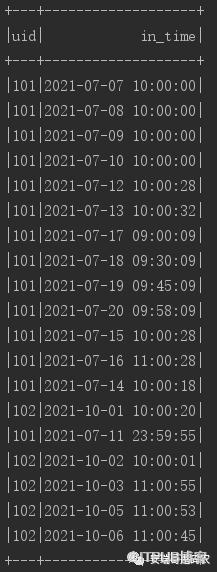
val df2 = df1.withColumn("row_number", row_number() over(Window.partitionBy($"uid").orderBy($"uid",$"in_time")))
df2.show()
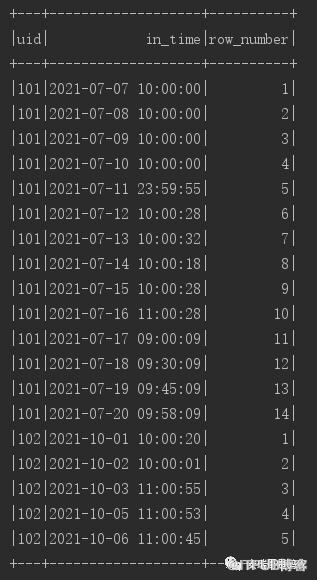
  val df3 = df2.withColumn("sub_time", date_sub($"in_time", $"row_number"))
  df3.show()
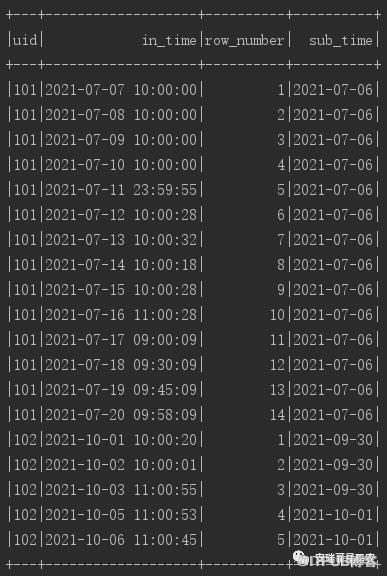
由于上两步的目的在于判断in_time是否连续,那么row_number字段就不要了,且因为最后结果要求是根据月份统计,因此需要把in_time转化成为月份日期类型,代码如下:
val df4 = df3.select($"uid", date_format($"in_time","yyyy-MM").as("month"), $"sub_time")
df4.show()
运行结果如下:

|第6步:根据sub_time分组确定连续次数
上一步已经知道哪些是连续签到的时间了,那么这一步就结合sub_time字段,通过row_number函数添加连续签到次数字段,代码如下:
val df5 = df4.withColumn("continuous_login", row_number().over(Window.partitionBy($"uid",$"month",$"sub_time").orderBy($"uid",$"month",$"sub_time")))
df5.show()
运行结果如下:
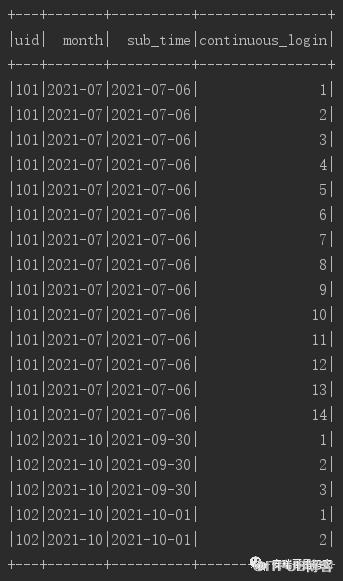
其中,continuous_login字段的值就代表了连续多少次签到。
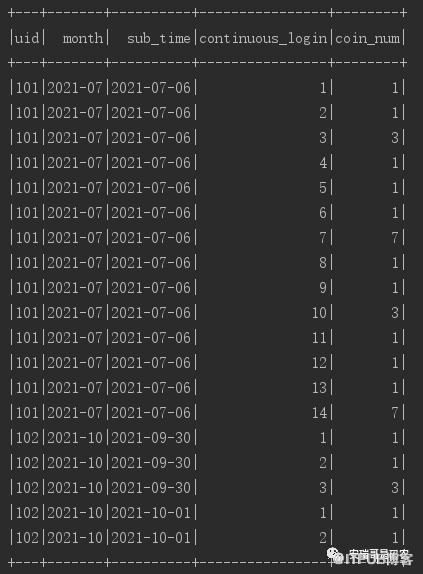
|第7步:根据连续签到次数算出每次应该领取的金币数量
既然用户的连续签到次数已经知道了,那么现在就是根据规则来确定每次签到时,应该可以领取的金币数量了。
根据题目要求,每签到一次就可以领取1枚金币,如果连续登陆3次,则可以获得额外2枚金币,而如果连续登陆7次,则可以额外获得6枚金币,但是7次之后,其登陆次数就要重置,也就是说如果你每次登陆都是连续的,那么你的金币领取数量应该是:1,1,3,1,1,1,7,1,1,3,1,1,1,7,1......
那么根据这个规律,换成代码逻辑就是:
1,当连续登陆次数能被7整除时:其领取金币数为7;
2,当连续登陆次数不能被7整除时:a,当余数为3时,领取金币数为3;b,当余数为其他数时,领取金币数为1;
代码如下:
val df6 = df5.withColumn("coin_num",
                when($"continuous_login"%7 === 0, 7)
                .when($"continuous_login"%7 === 3, 3)
                .otherwise(1))
df6.show()
val result = df6.select($"uid", $"month", $"coin_num")
                .groupBy($"uid", $"month")
                .agg(sum($"coin_num").as("sum_coin"))
result.show()
import org.apache.log4j.{Level, Logger}
import org.apache.spark.SparkConf
import org.apache.spark.sql.SparkSession
import org.apache.spark.sql.expressions.Window


/**
  * @DESC: 连续登陆领金币问题
  * @Auther: Anryg
  * @Date: 2022/09/13 12:10
  */
object SparkSQLTest03 {
    def main(args: Array[String]): Unit = {
        val sparkConf = new SparkConf()
        sparkConf.setAppName("连续登陆领金币问题")
        sparkConf.setMaster("local[*]")

        val spark = SparkSession.builder().config(sparkConf).getOrCreate()
        import spark.implicits._
        val seq = Seq(
            (101, 0, "2021-07-07 10:00:00", "2021-07-07 10:00:09", 1),
            (101, 0, "2021-07-08 10:00:00", "2021-07-08 10:00:09", 1),
            (101, 0, "2021-07-09 10:00:00", "2021-07-09 10:00:42", 1),
            (101, 0, "2021-07-10 10:00:00", "2021-07-10 10:00:09", 1),
            (101, 0, "2021-07-12 10:00:28", "2021-07-12 10:00:50", 1),
            (101, 0, "2021-07-13 10:00:32", "2021-07-13 10:00:50", 1),
            (101, 0, "2021-07-17 09:00:09", "2021-07-13 10:00:50", 1),
            (101, 0, "2021-07-18 09:30:09", "2021-07-13 10:00:50", 1),
            (101, 0, "2021-07-19 09:45:09", "2021-07-13 10:00:50", 1),
            (101, 0, "2021-07-20 09:58:09", "2021-07-13 10:00:50", 1),
            (101, 0, "2021-07-15 10:00:28", "2021-07-13 10:00:50", 1),
            (101, 0, "2021-07-16 11:00:28", "2021-07-13 10:00:50", 1),
            (101, 0, "2021-07-14 10:00:18", "2021-07-13 10:00:50", 1),
            (102, 0, "2021-10-01 10:00:20", "2021-10-01 10:00:50", 1),
            (101, 0, "2021-07-11 23:59:55", "2021-07-11 23:59:59", 1),
            (102, 0, "2021-10-02 10:00:01", "2021-10-02 10:01:50", 1),
            (102, 0, "2021-10-03 11:00:55", "2021-10-03 11:00:59", 1),
            (102, 0, "2021-10-04 11:00:45", "2021-10-04 11:00:55", 0),
            (102, 0, "2021-10-05 11:00:53", "2021-10-05 11:00:59", 1),
            (102, 0, "2021-10-06 11:00:45", "2021-10-06 11:00:55", 1)
        )

        val df = spark.createDataset(seq).toDF("uid","article_id","in_time","out_time","if_sign")
        df.show()
        df.printSchema()
        import org.apache.spark.sql.functions._  /**引入spark内置函数*/

        val df1 = df.select($"uid",$"in_time")
                .where(to_date($"in_time").between("2021-07-07 00:00:00","2021-10-31 23:59:59"))
                .where($"article_id" === 0 and $"if_sign" === 1 )
        df1.show()

        val df2 = df1.withColumn("row_number", row_number() over(Window.partitionBy($"uid").orderBy($"uid",$"in_time")))
        df2.show()

        val df3 = df2.withColumn("sub_time", date_sub($"in_time", $"row_number"))
        df3.show()

        val df4 = df3.select($"uid", date_format($"in_time","yyyy-MM").as("month"), $"sub_time")
        df4.show()

        val df5 = df4.withColumn("continuous_login", row_number().over(Window.partitionBy($"uid",$"month",$"sub_time").orderBy($"uid",$"month",$"sub_time")))
        df5.show()

        val df6 = df5.withColumn("coin_num",
                when($"continuous_login"%7 === 0,7)
                .when($"continuous_login"%7 === 3, 3)
                .otherwise(1))
        df6.show()

        val result = df6.select($"uid", $"month", $"coin_num").groupBy($"uid", $"month").agg(sum($"coin_num").as("sum_coin"))
        result.show()

    }
}
原文作者:安瑞哥是码农;如有侵权,请联系管理员删除。

