
object MapTest {
    def main(args: Array[String]): Unit = {
        val conf = new SparkConf().setAppName("MapTest")/*.setMaster("local")*/
        val spark = SparkSession.builder().config(conf).getOrCreate()
        val rawDF = spark.read.csv(args(0))//读取HDFS的数据源
        import spark.implicits._
        rawDF.printSchema() //spark job 1
        rawDF.show() //spark job 2
        val resultDF = rawDF.map(row => {
            val clientIP = row.getAs[String]("_c0")
            val domain = row.getAs[String]("_c1").toLowerCase//将域名转成小写
            val time = row.getAs[String]("_c2")
            val targetIP = row.getAs[String]("_c3")
            val rcode = row.getAs[String]("_c4")
            val queryType = row.getAs[String]("_c5")
            val authRecord = if (row.getAs[String]("_c6") == null ) "" else row.getAs[String]("_c6").toLowerCase
            val addMsg = if (row.getAs[String]("_c7") == null ) "" else row.getAs[String]("_c7")
            val dnsIP = row.getAs[String]("_c8")
            (clientIP,domain,time,targetIP,rcode,queryType,authRecord,addMsg,dnsIP)
        }).toDF("client_ip","domain","time","target_ip","rcode","query_type","authority_record","add_msg","dns_ip")

        /**将转换后的数据写入HDFS*/
        resultDF.write.csv(args(1))//spark job 3
    }
}
object MapPartitionTest {
    def main(args: Array[String]): Unit = {
        val conf = new SparkConf().setAppName("MapPartitionTest")/*.setMaster("local")*/
        val spark = SparkSession.builder().config(conf).getOrCreate()
        val rawDF = spark.read/*.option("header",true)*/.csv(args(0))

        import spark.implicits._
        rawDF.printSchema()
        rawDF.show()
        val resultDF = rawDF.mapPartitions(iterator => {
            val array = new mutable.ArrayBuffer[(String,String,String,String,String,String,String,String,String)]
            while (iterator.hasNext){
                val next = iterator.next()
                val clientIP = next.getAs[String]("_c0")
                val domain = next.getAs[String]("_c1").toLowerCase//将域名转成小写
                val time = next.getAs[String]("_c2")
                val targetIP = next.getAs[String]("_c3")
                val rcode = next.getAs[String]("_c4")
                val queryType = next.getAs[String]("_c5")
                val authRecord = if (next.getAs[String]("_c6") == null ) "" else next.getAs[String]("_c6").toLowerCase
                val addMsg = if (next.getAs[String]("_c7") == null ) "" else next.getAs[String]("_c7")
                val dnsIP = next.getAs[String]("_c8")
                array.+=((clientIP,domain,time,targetIP,rcode,queryType,authRecord,addMsg,dnsIP))
            }
            array.toIterator
        }).toDF("client_ip","domain","time","target_ip","rcode","query_type","authority_record","add_msg","dns_ip")

        resultDF.write.csv(args(1))
    }
}
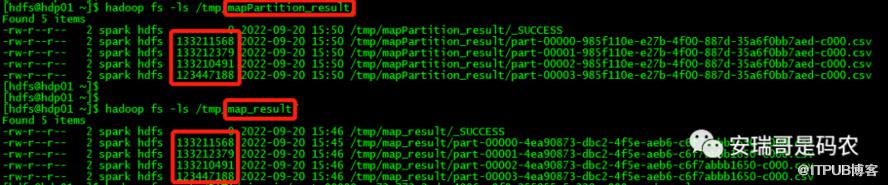
spark-submit --master yarn --deploy-mode client --conf spark.driver.memory=1g --conf spark.yarn.max.executor.failures=1 --conf spark.memory.fraction=0.8 --conf spark.task.maxFailures=1 --class com.anryg.bigdata.test.map_pk_mappartition.MapTest --executor-cores 1 --num-executors 1 --executor-memory 2g --name MapTest --jars ./spark-coding-1.0-SNAPSHOT-with-dependencies.jar ./spark-coding-1.0-SNAPSHOT.jar /the/path/to/source/data /dir/of/output




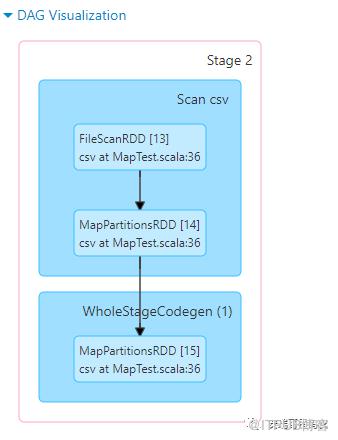
可以看出来,其运行速度每次都差不多,大概在38秒左右,然后每次都只有一个stage,该stage有4个Partition。
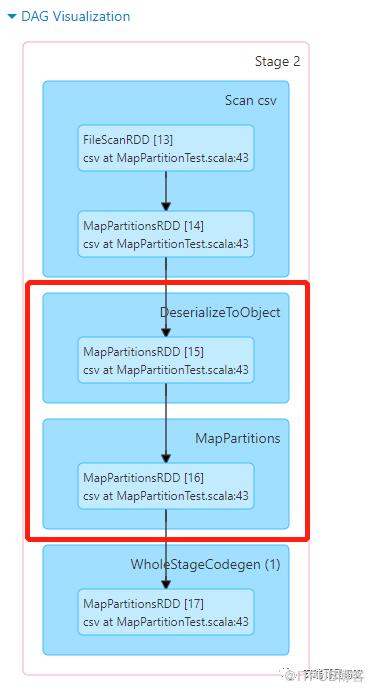
再来看下mapPartitions的运行截图:




| 对比次数 |
map耗时 |
mapPartitions耗时 |
| 1 |
37s |
54s |
| 2 |
37s |
54s |
| 3 |
41s |
54s |
| 4 |
38s |
1.1min |


原文作者:安瑞哥是码农;如有侵权,请联系管理员删除。
上一篇:
跟一位字节朋友的聊天

请登录后发表评论
登录
全部评论
