昨天刚写完那篇用Flink消费kafka数据写Doris时,在某个场景下会丢数据的文章。
在凌晨3点多,就有个小伙伴私信我,说,想要从kafka偏移量恢复之前的数据,应该这样设置:

看到他的这条消息,我兴奋地赶紧从床上爬了起来,匆匆洗漱、健身完毕就跑到了办公室,心想,这下问题应该可以解决了。
然鹅,现实却“啪”一记耳光呼过来,生疼。
1. 根据官网再次调整API
这位小伙伴提到这个关于offset的设置,我在官网中大概瞄过一眼,但是没有留下深刻印象,因为关于offset的设置问题,Flink的官网有多处描述。
而且,这个东西本来就不复杂,就是那么几个关键设置,设置完就可以正常消费kafka数据了。
这个是我之前的,对kafka的offset相关设置:
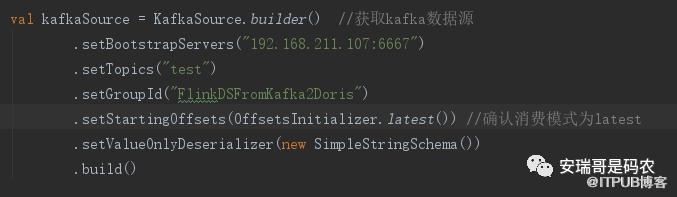
那根据官方文档对这块的进一步描述:
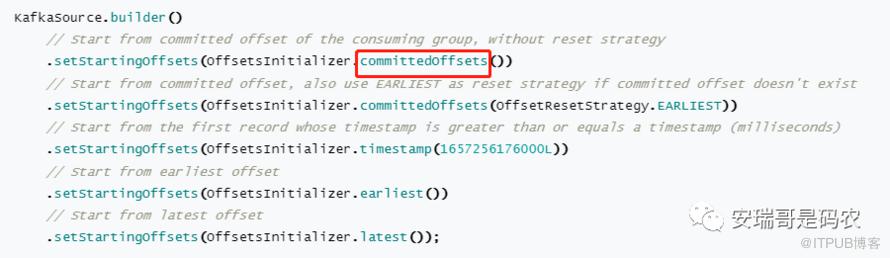
以为问题出在这里,我就把原来的API给做了适当修改。
根据我对官网这段描述的理解,我改成了这样:

然而,一番折腾(测试步骤跟上篇文章一毛一样)过后,情况还是跟之前一样,停掉flink进程之后写入的kafka数据,就是没有办法被再次重新消费(写入Doris表)。
正所谓:一顿操作猛如虎、回头一看原地杵。
然后,我又把这段offset的设置改成了这样:

接着又这样:
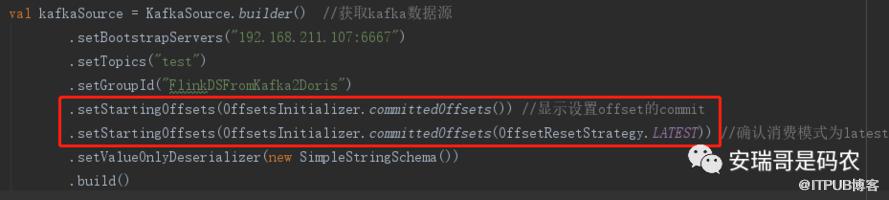
但,就! 是! 不! 行!
事实证明,跟这个设置一点关系都没有,之前的设置其实是没有问题的(经后面多次亲自验证),这个用latest模式去消费kafka的数据存在丢数据的情况,就是Flink暴露出的bug。
以上测试的详细过程,这里就不贴出来了,跟上一篇步骤是一样的,有兴趣的同学可以去回顾上一篇的内容。
2. latest与earliest区别对待
就在今天下午的时候,又有一位热心小伙伴私信我关于这个问题,让我把checkpoint目录下的metadata文件发给他。
然后他帮我分析了下这个文件的内容(二进制的),告诉我,这个文件里面是包含有commit的offset信息的。
接着跟我确认是不是真的根据checkpoint来恢复的数据,我说:是,我没有必要唬你。
然后他告诉我,他也模拟了一遍我测试的这个场景,但他没丢数据。
我问:条件都一模一样吗?
他回:用的是earliest消费模式。
我说,大哥,我用的可是latest消费模式,我也知道earliest模式没有问题(经过我后续的验证,测试顺序跟用latest模式一毛一样的情况下,确实不丢数据)。
但关键,为毛latest模式就会丢数据呢?不是说好的flink的checkpoint会记录数据处理的状态吗?
咋地,歧视latest模式呀?
要知道,同等条件下,spark可不会这样哦(直播的时候,也演示过了)。
最后
测试到这里,老实说,反反复复地进行这些重复动作,对比、操作,我都快吐了。
事实证明,通过用flink去消费kafka数据时,如果用latest模式,在程序停止的间隙,如果kafka持续有数据写入,等程序再次恢复后,是极有可能会漏掉这部分数据的(已经实锤,写HDFS以及写Doris都会漏)。
不信,你可以去试试...
而想保证kafka的数据不丢,目前通过验证出来的有效手段有2个:
1. 别用Flink的latest消费模式,改用earliest模式会更保险;
2. 如果非要用latest模式消费,需要确保程序别挂,或者用spark structured streaming来代替,别用flink。
当然,也不排除另一个可能,那就是我当前的版本组合有问题:
我的对应组件版本为:Flink1.15.3,Hadoop3.1,kafka2.0.0,Doris1.2.3
希望可以帮你避坑.
原文作者:安瑞哥是码农;如有侵权,请联系管理员删除。

