上篇文章列举了,在针对我的那份用户上网日志数据给的5个查询需求中, Doris 跟 Clickhouse(以下称CK) 在查询时,针对相同的查询场景,SQL语句以及执行效率的差异。
可能有的同学会觉得才5个案例对比,不过瘾,那今天咱继续挖掘这两个数据库在使用时,其他方面的差异。
0. 交代基础环境
由于上次着急测试对比,同一份数据源,Doris表因为写入效率更高些,所以很快就写入了完整的数据 ,总条数为:

Doris表总数据量
而CK因为JDBC的入库方式比较拉跨,所以写的比较慢,在写入的后半程,为了进一步加速写入效率,我又启动了另一个进程,这样一来,虽然最后把这份数据源都写到CK表了。
但是,因为存在重复写入的原因(没有用去重表引擎,所以表本身不会去重),导致CK表的总数据量要比Doris的多(下文会演示如何找出,并删除这部分重复的数据):

CK表总数据量
从查询这个表的总数据量速度来看,Doris因为是天然的分布式数据库,所以它的效率要比CK的高。
要注意:虽然两表都分布在3台机器上,但是,Doris所在集群的硬件,要高出CK所在集群的硬件不止一个等级。
1. 表列名修改
因为上次一时着急,在建表的时候,把其中一个表示ip地址所属国家的字段给写错了,应该是「nation」,我给错写成了「nature」,着实有点不应该。
于是我就想着要把它给改过来,对于Doris和CK来说呢,这个常见的功能肯定都是支持的。
先看Doris的修改方式:
ALTER TABLE logs_from_spark01
RENAME COLUMN nature nation;
看执行情况:

报错说需要设置什么属性,于是呢,打开对应的说明:

官网解释说,1.2.0版本之前不能修改列名,1.2.0之后的版本是可以修改的(我当前的Doris版本为1.2.3),但是呢,说它是个非常重的操作,会涉及到数据的重写,这就非常坑了。
但我还是想试一下,它这个所谓的「重」,到底有多重。
先打开这个属性功能:

又报错了,说没有这个属性,可我就是按照官网来操作的呀,问题出在哪呢?
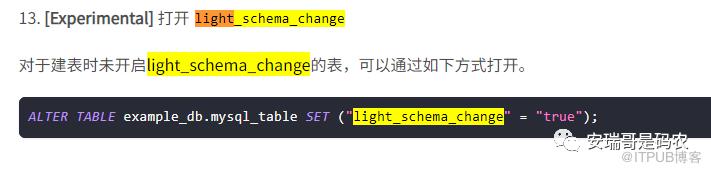
这不逗我玩的吗。
再看CK的修改方式:
ALTER TABLE logs_from_spark_cluster
    RENAME COLUMN nature TO nation
看执行情况:
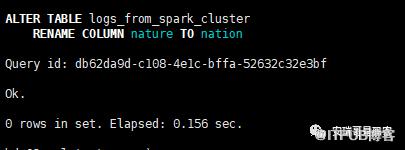
好像很丝滑,瞬间就执行完了。
但是,因为我这里用的是分布式表,当前只是把分布式表的表名给修改了过来,查看一下发现,对应的本地表还没有,于是还得执行一遍本地表的修改操作。
修改所有相关本地表的字段:
ALTER TABLE logs_from_spark_cluster_local ON CLUSTER template_3shard_2replica
    RENAME COLUMN nature TO nation
看执行结果:
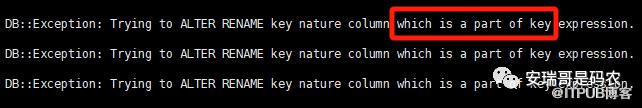
也报错了,原因在于当初建表的时候,这个字段它是一个排序字段,也就是key字段,其实官网也有说明:

从这一点上来看,Doris跟CK的限制是一样的,都不能修改key字段。
小结一下:因为是key列,都改不了,但如果可以改的话(非key列,或者非排序列),Doris实现起来更复杂,CK要简单一些。
2. 找出去重数据
开始说了,由于CK表在写入数据的时候,用了2个进程同时写一份数据,并且没有明显区隔各自写入数据的范围,所以就产生了写重复的情况。
于是,我们就需要通过SQL来判断到底重复了多少,并考虑将重复数据删除。
怎么通过查询来证明?
先看CK的SQL:
SELECT count(distinct(*))
FROM cluster_db.logs_from_spark_cluster
查看结果:
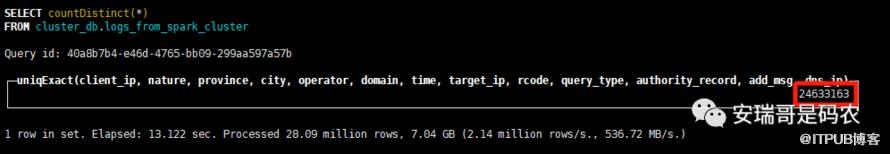
用时13秒左右,通过一开始知道的该表的数据总量(28085784),减去现在去重后的数据总量(24633163),得到重复的数据量为: 3452621。
但是,当我用相同的SQL来查询Doris表时:
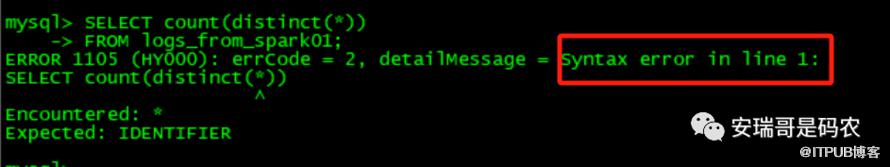
很明显,Doris并不支持这种简洁的写法。
那怎么办呢?
只能修改SQL语法,尝试了几种方式,于是就改成了这样:
SELECT
count(*)
FROM
(
SELECT
*,
row_number() over (partition by client_ip, nature, province, city, operator, domain, time, target_ip, rcode, query_type, authority_record, add_msg, dns_ip) as row_num
FROM
logs_from_spark01
)t
WHERE t.row_num =1;
查询结果:
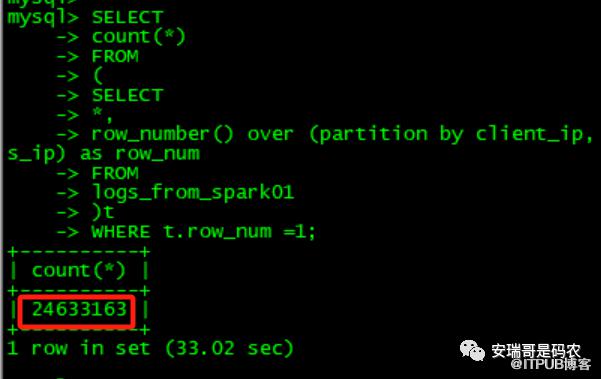
用时33秒,查出了Doris表去重后的数据总量。
同样,用刚开始查询出来的数据总量,减去现在去重后的数据总量,发现,Doris表的重复数据量为:0.
小结一下:无论是对于去重查询SQL语句的简洁度,还是该语句的执行效率,CK都要优于Doris。
3. 对重复数据进行删除
为了同时演示在Doris以及CK上删除记录完全重复的数据,我这里特地给Doris表又新推入了一百多万条重复记录。

Doris包含重复记录的数据量
本来想着用这两个数据库,来对比其各自用 DML 删除这些重复数据的,但找了一圈发现,这种整行数据重复的情况,Doris跟CK好像都没有办法简单通过传统的 DELETE 方式删除的。
于是,就只能用最笨的办法:重新分别创建去重引擎表,然后将原来的表数据全部 insert 到新表,以此达到去重的目的。
说干就干,先建Doris的去重表:
CREATE TABLE `logs_from_spark02` (
 `client_ip` varchar(200) ,
 `nation` varchar(20) ,
 `province` varchar(30) ,
 `city` varchar(30) ,
 `operator` varchar(20) ,
 `domain` varchar(200) ,
 `time` varchar(200) DEFAULT "99999",
 `target_ip` varchar(200),
 `rcode` int(11) DEFAULT "99",
 `query_type` int(11) DEFAULT "99",
 `authority_record` varchar(500),
 `add_msg` varchar(200),
 `dns_ip` varchar(200)
) ENGINE=OLAP
UNIQUE  KEY(`client_ip`, `nation`, `province`, `city`, `operator`, `domain`, `time`, `target_ip`)
COMMENT 'dns logs'
DISTRIBUTED BY HASH(`client_ip`) BUCKETS AUTO;
然后,写数据:
INSERT INTO logs_from_spark02
SELECT * FROM logs_from_spark01;
看运行结果:
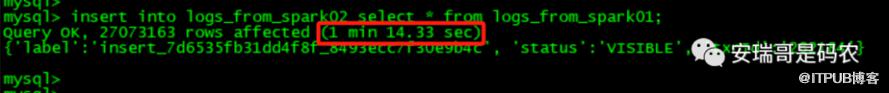
写完所有数据,花了74秒多。
再看新表的数据量:
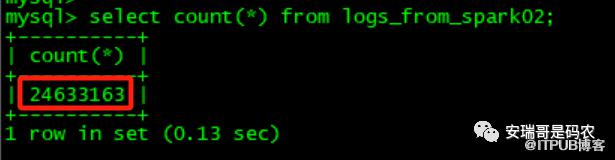
可以看到新表已经将重复记录完全去重了。
再看CK的。
CK要麻烦一些,先建新的分布式表:
CREATE TABLE cluster_db.logs_from_spark_cluster01 ON CLUSTER template_3shard_2replica
(
    `client_ip` String,
    `nation` String,
    `province` String,
    `city` String,
    `operator` String,
    `domain` String,
    `time` String,
    `target_ip` String,
    `rcode` Int32,
    `query_type` Int32,
    `authority_record` String,
    `add_msg` String,
    `dns_ip` String
)
ENGINE = Distributed('template_3shard_2replica', 'cluster_db', 'logs_from_spark_cluster_local01', cityHash64(client_ip))
再建对应的本地表:
CREATE TABLE cluster_db.logs_from_spark_cluster_local01 ON CLUSTER template_3shard_2replica
(
    `client_ip` String,
    `nation` String,
    `province` String,
    `city` String,
    `operator` String,
    `domain` String,
    `time` String,
    `target_ip` String,
    `rcode` Int32,
    `query_type` Int32,
    `authority_record` String,
    `add_msg` String,
    `dns_ip` String
)
ENGINE = ReplacingMergeTree
ORDER BY (client_ip, nation, province, city, operator, domain, time, target_ip)
然后执行一毛一样的 insert 语句:
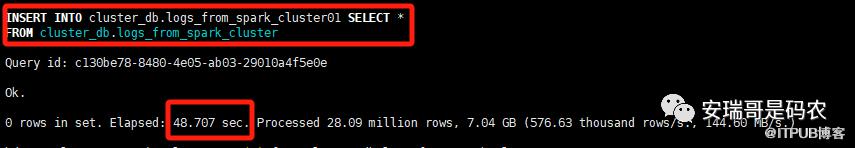
可以看到,将原表的数据写入去重引擎表时候,整个写入过程花了不到49秒(要知道此时原表CK的数据量是比Doris多的)。
瞅一眼去重后的表数据量:

可以看到,跟开始的表记录相比,已经去重了3百多万条重复记录(可能排序的原因,导致没有完全去干净)。
小结一下:CK跟Doris都有办法做到直接用delete的方式对当前场景下重复数据去重,只能用最笨的办法来。
从实现方式来看,Doris比CK更简洁,但是从新数据的写入速度来看,CK的效率要比Doris更高。
4. 其他方面的对比
这几天除了对比同一个查询场景的SQL语句差异,以及查询效率的差异之外,其实还发现一些其他在使用体验上的不同:
1. 一些实用的函数目前Doris还不支持,比如跟IP相关的类型,或者函数,而CK这方面则支持的很好;
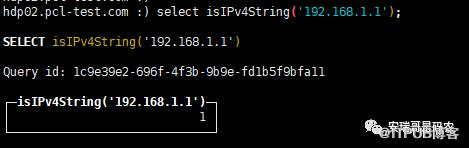
判断IP的函数,目前只有CK支持
2. 客户端在进行SQL提交时,CK会自动将其进行格式的美化,让人看上去非常舒服,增加了SQL的可读性,这个Doris的自带客户端目前不具备;
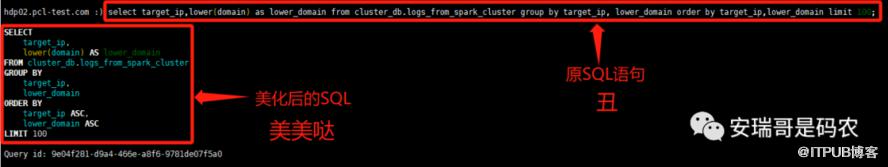
3. SQL在执行时,CK有执行进度条,能显示执行进度,以及读取的数据量、数据条数等,资源消耗情况等,比较人性化,而Doris不具备:

4. 在创建分布式表方面,Doris 则要比CK简单很多,Doris只要一个建表步骤,而CK则要分多步:先配置分布式表的机器分布情况;再利用分布式引擎创建分布式表;最后再创建分布式引擎表依赖的本地表。光CK的这个繁琐的建表过程,估计就能劝退很多人。
最后
Doris跟CK的对比,目前写的这两篇文章,只能呈现出它们的冰山一角,更多这两者的差异,还需在往后的各个项目实践中,不断去发掘。
对比技术的好坏,从来都不是简单的去看看其中的理论,背背对应的八股文,而是要真正把它「跑」起来,这有这样,你才知道它「行」还是「不行」。
下一篇,咱继续聊 Doris 跟 CK 在多表 join 上的性能差异。
原文作者:安瑞哥是码农;如有侵权,请联系管理员删除。

