上两篇文章对比了单表(分布式表)场景下,Doris 跟 Clickhouse(下称CK) 在查询上的对比,一番较量下来,从查询效率来看,Doris貌似在大部分情况下都处于下风。
之前一直都耳闻CK在多表join场景下效率不行,那么它是真的不行,还是被谣传误解了,咱们这篇文章就来实地检验一下,CK在多表join的场景下,跟Doris比有哪些差异。
顺便也看看,Doris能不能在这次对比中,实现逆势翻盘。
PS:由于数据源的限制,本次验证只能测试2表join的情况,还请各位看官理解,但即便如此,也能说明一些问题,你觉得呢。
0. 环境准备
对于我的这份数据集来说,想要实现多表join的功能,最容易想到的,就是将表中的地理位置相关信息这个维度给拆分出来,形成跟地理位置维度表,然后再通过join关联上网的事实表,形成完整的记录。
0.1 从原表中提取出ip的地位置维度信息
先创建ip与地理位置维度信息表(为防止数据重复,用去重表模型):
Doris表结构:
CREATE TABLE dim.`ip_area01` (
 `client_ip` varchar(100) NOT NULL,
 `nation` varchar(20),
 `province` varchar(30),
 `city` varchar(30),
 `operator` varchar(20)
) ENGINE=OLAP
UNIQUE  KEY(`client_ip`, `nation`, `province`, `city`, `operator`)
COMMENT 'area_dim'
DISTRIBUTED BY HASH(`client_ip`) BUCKETS AUTO;
CK表结构(为了对比公平,也创建分布式表):
先建分布式表:
CREATE TABLE dim.ip_area_cluster01 on cluster template_3shard_2replica
(
    `client_ip` String,
    `nation` String,
    `province` String,
    `city` String,
    `operator` String
)
ENGINE = Distributed('template_3shard_2replica', 'dim', 'ip_area_cluster_local01', cityHash64(client_ip))
再建对应的本地表:
CREATE TABLE dim.ip_area_cluster_local01 on cluster template_3shard_2replica
(
    `client_ip` String,
    `nation` String,
    `province` String,
    `city` String,
    `operator` String
)
ENGINE = ReplacingMergeTree
ORDER BY (client_ip, nation, province, city, operator)
Doris 和 CK 都可用同一个insert语句,来将维度信息提取出来写入到这个维度表里:
INSERT INTO ${dim_table} SELECT
    client_ip,
    nation,
    province,
    city,
    operator
FROM ${source_table}
GROUP BY
    client_ip,
    nation,
    province,
    city,
    operator
写入之后,对应的维度表数据量是一样的,都接近20万条:
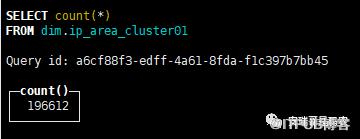
CK的维度表数量
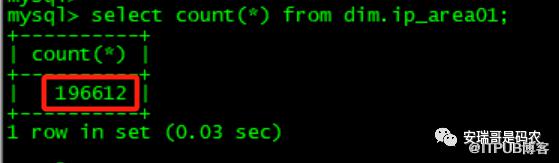
Doris的维度表数量
0.2 从原表中抽取事实数据形成事实表
具体的创建语句就不写了,除了抹去位置信息那几个字段外,跟上面的创建方式一样,直接从写入数据开始。
CK表的抽取方式为:
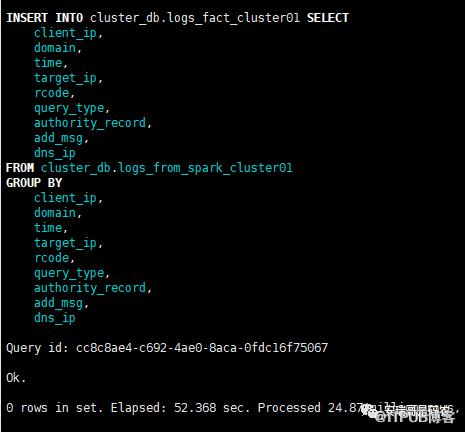
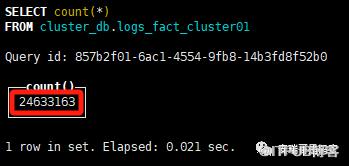
抽取的事实记录为:
Doris的抽取方式为:
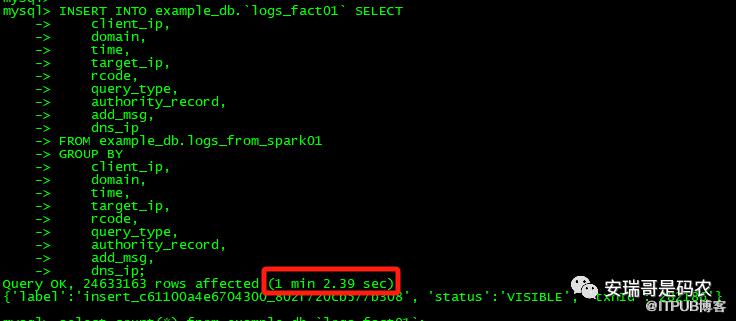
抽取到记录数一样的实时数据:
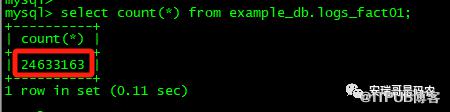
这样一来呢,Doris 跟 CK 的事实表和维度表数据量就一毛一样了,接下来,咱的对比正式开始。
1. 对比开始
因为已经将地理位置信息和上网的事实信息拆分成了两张表,所以后续只要涉及到位置信息的查询,都必须使用join。
1.1 查询上网次数最多的前100个client_ip,以及他们分别的归属地是哪里
对于这个关联查询,Doris跟CK可以共用同一个SQL,开心:
SELECT
    a.client_ip,
    b.nation,
    b.province,
    b.city,
    b.operator,
    a.count
FROM
(
    SELECT
        client_ip,
        count(client_ip) AS count
    FROM cluster_db.logs_fact_cluster01
    GROUP BY client_ip
    ORDER BY count DESC
    LIMIT 100
) AS a
LEFT JOIN dim.ip_area_cluster01 AS b ON a.client_ip = b.client_ip
ORDER BY a.count DESC
这里用到了left join将两表进行关联。
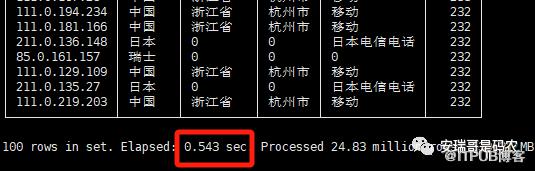
先看CK的查询结果:
再看 Doris 的查询结果:
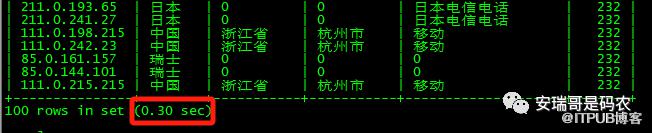
从查询效率上来看,都还算挺快的,Doris的查询效率要比CK更快一点,但是要知道Doris所在集群的CPU要更强大一些。
1.2 以分钟为标准,找出连续上网次数最多的前100个client_ip,以及对应的地理位置
对于这个稍微有点复杂的SQL,Doris跟CK的写法就不一样了,同样也用的left join。
CK的SQL写法(更简洁一点):
SELECT
    D.client_ip,
    E.nation,
    E.province,
    E.city,
    E.operator,
    max(D.row_num2) AS max
FROM
(
    SELECT
        client_ip,
        row_num2,
        date_min
    FROM
    (
        SELECT
            client_ip,
            sub_date,
            row_number() OVER (PARTITION BY client_ip, sub_date) AS row_num2,
            date_min
        FROM
        (
            SELECT
                client_ip,
                date_min,
                row_number() OVER (PARTITION BY client_ip ORDER BY date_min ASC) AS row_num,
                subtractMinutes(date_min, row_num) AS sub_date
            FROM
            (
                SELECT
                    client_ip,
                    toStartOfMinute(parseDateTimeBestEffort(time)) AS date_min,
                    row_number() OVER (PARTITION BY client_ip, date_min ORDER BY date_min ASC) AS row_num
                FROM cluster_db.logs_fact_cluster01
                WHERE (isIPv4String(client_ip) = 1) AND (length(time) = 14)
            ) AS A
            WHERE A.row_num = 1
        ) AS B
    ) AS C
) AS D
LEFT JOIN dim.ip_area_cluster01 AS E ON D.client_ip = E.client_ip
GROUP BY
    D.client_ip,
    E.nation,
    E.province,
    E.city,
    E.operator
ORDER BY max DESC
LIMIT 100
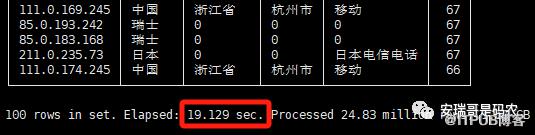
查询结果:
再看Doris的SQL语句:
select
    D.client_ip,
    E.nation,
    E.province,
    E.city,
    E.operator,
    max(D.row_num2) AS max
from
(
select
client_ip,
row_num2,
date_min
from
(
select
client_ip,
sub_date,
row_number() over (partition by client_ip,sub_date) as row_num2,
date_min
from
(
select
client_ip,
date_min,
row_number() over (partition by client_ip order by date_min) as row_num,
minutes_sub(to_date(date_min), row_num) as sub_date
from
(
select client_ip,
date_min,
row_number() over (partition by client_ip,date_min order by date_min) as row_num
from
(
select
client_ip,
minute_floor(time) AS date_min
from
example_db.logs_fact01
where
length(time)=14
)t
) A
where A.row_num=1
) B
) C
)D
left join dim.ip_area01 E
on D.client_ip=E.client_ip
group by
D.client_ip,E.nation,E.province,E.city,E.operator
order by max desc
limit 200;
查询结果:
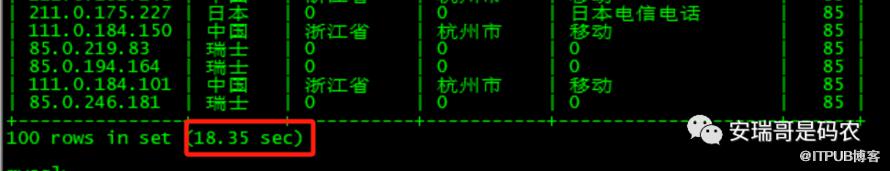
可以看到,这两个查询用时也接近,Doris比CK更快一点。
但是,不知道细心的你有没有发现,在上上篇文章中(),类似的查询结果,Doris用时在17秒左右,但是CK只用了不到10秒钟。
而这次采用join,CK的查询效率下降很明显,Doris的变化则不大。
2. 相关限制
这个限制主要是针对CK来说的,谁叫它的使用成本更高呢。
1. 如果两表进行join操作,那么这两表的性质必须一致,比如A表为分布式表,那么被join的B表也必须是分布式表,如果A表为分布式表,而被join的B表是本地表,则会抛出如下异常:

而且从验证中可以看出来,A表跟表的分布方式还必须一样,否则也会抛出找不到被 join 表的错误。
对于这一点来说,确实比较尴尬。
2. 第一次用CK的join查询时,如果用常规的join语法书写SQL,会抛出如下的异常:

解决办法是:在join的关键字前面再加上「GLOBAL」关键字。
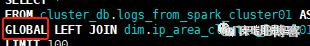
而且,从实践来看,这个「GLOBAL」关键字只需要在第一次关联查询时加上,后续就不需要了。
最后
受数据源的丰富性所限,虽然这次关于 join 的对比场景有些狭窄,但也能从中一窥 Doris 跟 CK 在关联查询中的使用差异,以及性能差异。
对于Doris来说:使用join与否,查询效率虽然有所下降,但是并不明显;
而对于CK来说:使用 join 后,查询速度下降明显;
但是,从这次测试结果来看,虽然CK的查询效率跟自己比,下降严重,但是跟Doris比,貌似也差不多(关键Doris集群所在硬件比CK高很多)。
那么通过这次对比,你觉得 Doris 逆袭了吗?
原文作者:安瑞哥是码农;如有侵权,请联系管理员删除。

