前言
乍一看,好像挺简单的,甚至很多同学在实践中都没有把这个当成一个问题,随便给个数就完了。
01
—
kafka的技术架构
虽然是分布式的存储系统,但是kafka却是一个[去中心化的]技术组件,它没有一般分布式系统的master和slaver的角色之分,因此不存在说哪个节点挂掉了,导致整个集群不可用。
因为没有master这个老大,所有的broker都是独立而平等的,他们之间属于一种合作共赢的关系,任何一个kafka集群可以由任意个broker实例组成。
虽然不是一般的master和slaver这种有中心化的架构,但是kafka也并非完全没有中心,只不过它的中心是以partition为单位,每个partition由一个leader和0或多个follower组成,其中这个leader就是中心,是数据写入的入口,这个一旦挂掉,那么这个partition的数据就暂时不可用,需要等待新的leader被选举出来。
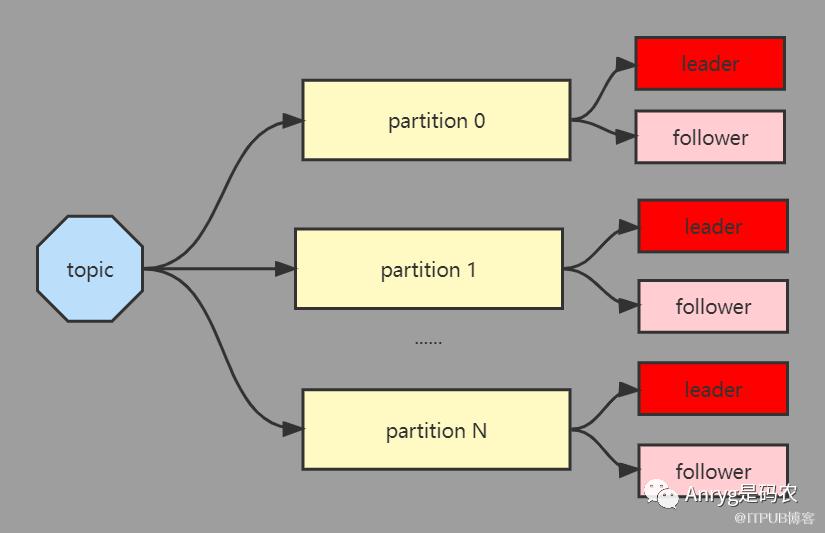
每个topic通过若干个partition来分治,核心目的除了分摊单个broker的压力(IO压力、存储压力、连接压力等)外,还有一个很重要的原因是给后续的计算引擎提供一个很好的[并行度],让数据处理的效率更高。
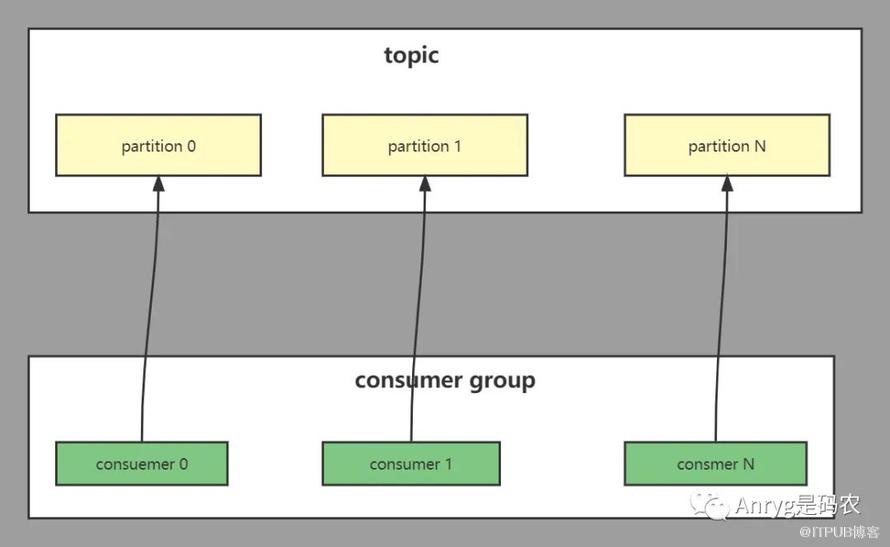
我们都知道在用分布式计算引擎消费kafka的数据时,都会指定一个[Consumer Group],那为什么不是单个Consumer,而是Group呢?原因就是在消费Topic数据时(一个或者多个),一般都有多个partition组成,而我们需要一个partition对应一个consumer,因此消费多个partition的consumer就构成了一个Group。
02
—
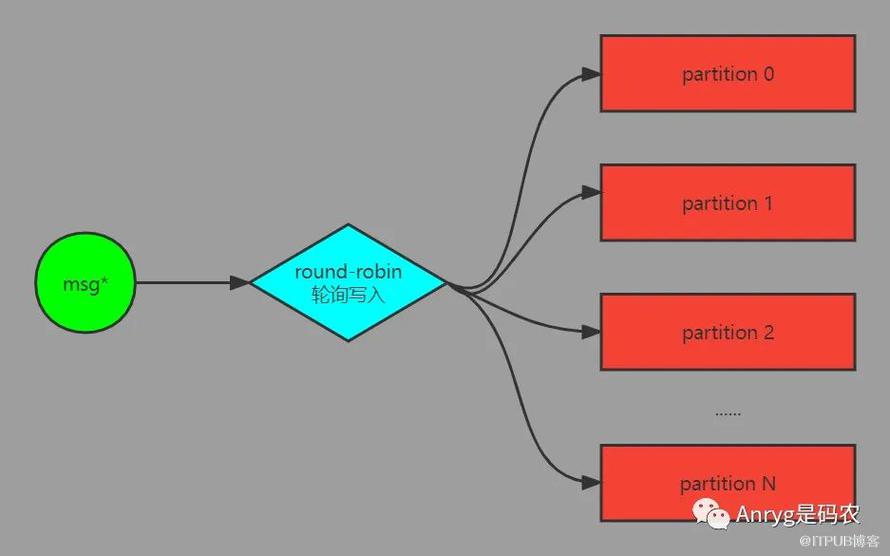
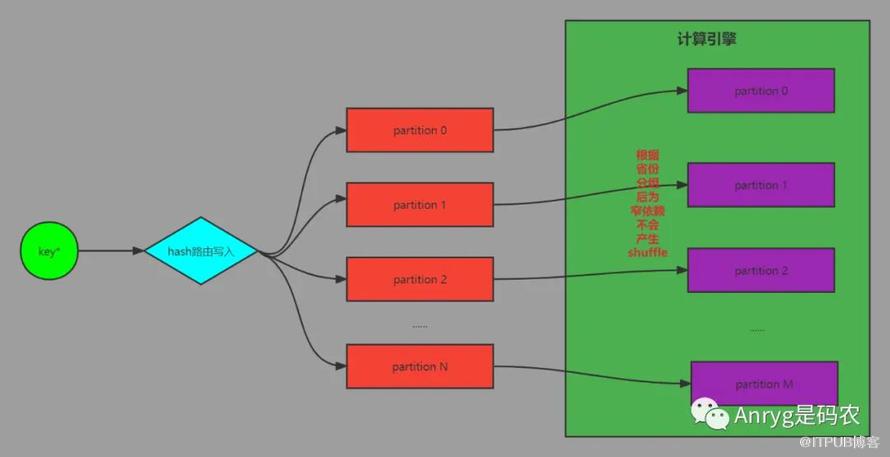
根据业务特点确定partition数量

key: hubei value: msg/**如果添加key,相同key的数据只会推送到同一个partition*/
ProducerRecord record = new ProducerRecord<>(topic, "hubei", msg);
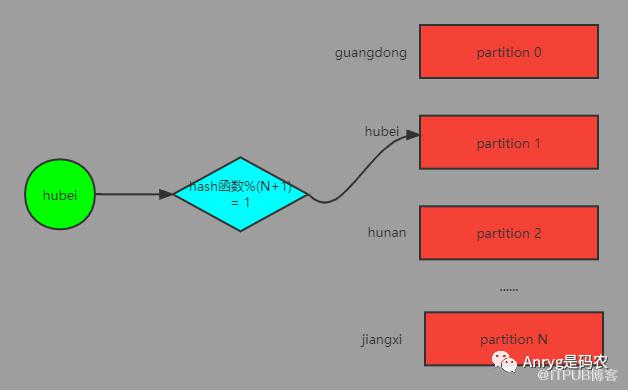
通过key路由写入
03
—
根据并行度确定partition数量
如果说你的业务处理并没有像上面那样对数据有分组统计的要求,单纯的只需要对数据进行分布式处理就好了。
那么就可以根据你后续数据要处理的并行度来定partition个数,为了防止单个节点负载过高,可以定为跟broker数量一样,或者跟后续计算引擎要并行的数量一致。
这个时候有同学会说,何必那么麻烦,我的partition随便定一个比较小的值就可以了,不用考虑后续数据处理的并行度,因为这个并行度我可以随时改的。
确实可以改,比如拿spark举例,你可以通过reparation和coalesce这两个函数来修改你要想的并行度。但是,你知道这样带来了什么代价吗?
来看下源码的解释:
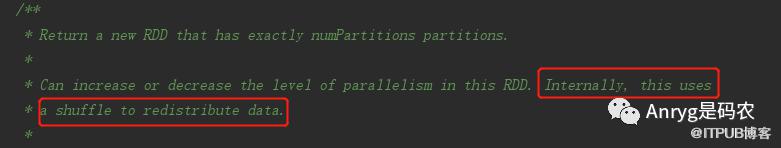
将原本小的partition数改大,必定会导致宽依赖的产生,而宽依赖则一定会产生shuffle,既然产生shuffle,那数据处理效率也就必然下降。

partition由小变多,必定产生宽依赖
因此,并不是像一些同学所说的没有关系,只是看这个关系会对你产生多大的影响罢了。
04
—
说说分区数与并行度
发现有些同学搞不清楚这两种的区别,这里说说我的理解。
分区数(partition数量):由数据源决定,是个相对静态的概念,一旦这个数据源决定了,那么你用计算引擎读取数据时候的初始分区数量也就定了,反映的是数据源的划分多少;
并行度:由消费数据源的计算引擎决定,是通过任务提交参数来定义的,是一个相对可调整的数值,是相对动态的,反映的是可以并行同时处理多少数据源的数据;
两者关系: 并行度 <= 分区数。
举个栗子,如果你kafka的某个topic有10个partition,那么你的计算引擎并行度就只能小于等于10个,以spark为例,可以这么设置:
//方式1:
--executor-cores 1 --num-executors 10
//方式2:
--executor-cores 2 --num-executors 5
这样设置就可以一次性将你有10个partition的分布式任务处理完成,但是如果你当前机器资源不够,一次性不足以处理完所有的分区,那么也可以这样设置:
//方式3:一次处理不完,分2次的情况
--executor-cores 1 --num-executors 5
//一次处理不完,分5次的情况
--executor-cores 1 --num-executors 2
注意,即便一次处理不完,你对并行度设置的数值最好能被总分区数整除,即10个分区,并行度最好设置为:10、5、2。
避免因为其他数值可能导致在最后一次并行处理时,某些计算节点没有数据造成资源浪费。怎么理解?
假如你将并行度设置为3,那么这个任务就得分4批执行,而到第4批的时候,因为你的并行度还是3,会占用3个计算节点的资源,但是此时你只有1个节点有数据,其他2个是空的。
在群中讨论时,还有同学说并行度是由计算节点的核数来定,这个说法你稍微想一下就会觉得不可能。
试想,如果并行度跟计算节点核数保持一致,那一个分布式计算集群,如果同时运行了几百上千个任务,每个任务都占满了CPU的核心,那CPU的抢占得多么的激烈,上下文切换得多么频繁,效率得多低。
因此,并行度多少,一定是根据数据源分布情况,以及当前集群资源可用情况,外加业务需求情况3者来综合考虑确定。
结语
——
原文作者:安瑞哥是码农;如有侵权,请联系管理员删除。

