这个是一个星球球友提出的问题,大致的问题描述如下:
我们当前有个大数据项目,目前已经完成了数据源接入、落地、存储、计算等一系列数据操作,算是把这个项目的基础部分已经完成了。
那么接下来,我被要求写一个关于这个项目的数据治理保障方案,不知道可以提供哪些思路?
其实类似问题,我在之前写过一篇关于数据治理的文章,只不过那篇文章篇幅比较长,很多人可能都没有耐心读完,如果你有兴趣,可以回顾一下().
对于一个完善、成熟的数据系统来说,建立必要的数据质量保障确实是非常重要的,尤其是当你的业务数据涉及到很敏感、重要的信息时。
有的同学看到,要对一个大数据系统做数据质量保障,顿时就懵逼了,想着,这么大的一个系统工程,我该如何下手呢。
其实,越是看似大的东西,越不要怕,因为都是可以拆解的,只要你能掌握一定的方法论,将其合理的拆解为多个部分,然后各个击破,问题就很容易解决。
我们知道,对于一个大数据系统来说,是可以将其分解成几个固定的模块的,这个我在之前的文章和视频中有多次提及,如下图所示:
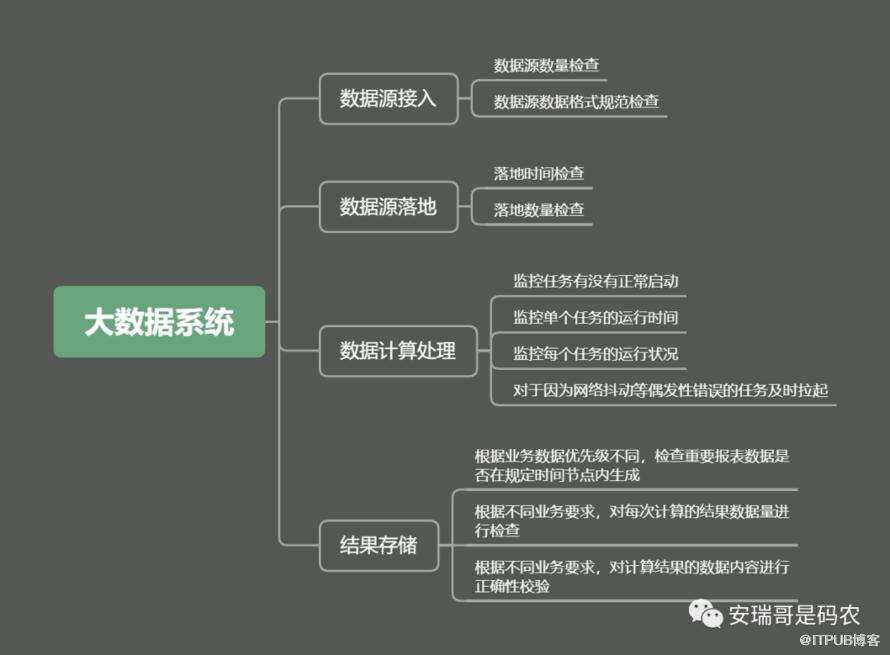
针对这几个部分的数据质量保障,下面咱展开来说说:
1. 数据源数据质量保障
对于任何一个数据系统来说,数据源是一个系统的生命源泉,是构建一个完整系统的第一步。
那么这一步的数据质量管理如何做?
-
估算数据流量:一般对于固定的数据源,业务方是可以提供该数据源每天,或者每次提供的数据量的,比如每秒多少条、每小时多少条、或者每天多少条?
大致确定数据条数之后,就可以针对不同的数据源,在数据接入的时候,设置基于数据量的阈值,超出该阈值,则进行对应的告警。 确定数据源的格式与规范:在数据源确定之后,除了大致确定数据流量之外,还应该跟数据源方约定好其他一些规范,比如每个数据源的字段数量、字段类型,关键字段的值校验等等。
同样,在数据接入的时候,加入判断逻辑看数据源格式是否符合该要求,如果不符合约定要求,则进行告警。
以上,便是我觉得比较通用的,对数据源数据质量进行保障的一些可行的方法。
优点:可以第一时间发现问题,并把它扼杀在摇篮里,避免扩散到后续流程中,产生糟糕的业务结果。
数据落地时间:就是看数据存储到大数据系统的时间,跟该数据的业务时间的时间间隔,如果因为网络延迟或者接入程序问题,导致相差太远,对于实时性要求高的场景来说,是不可以接受的。
那么加入这个检查,就可以提早发现数据延迟的原因,尽快解决问题。-
数据落地数量:对于一些定义并不十分合理的数据源(比如重复数据、数据分隔符界定不清晰等),可能在数据落地的时候,导致接入的数据量跟落地存储之后的数量不一致。
通过这种检查机制,提前发现数据量不一致问题,力争把问题在第一时间内解决。
监控任务是否正常启动:一般任务分为常驻任务,和通过计划任务启动的定时任务,对于前者,监控其是否挂掉,而后者则监控其是否按时跑起来。 监控任务运行时间:一般对于特定业务,单个任务(非常驻任务)的运行时间基本上围绕在一个确定的时间范围内,如果运行时间太长或者太短,则需要对其告警,说明要么是代码逻辑存在问题,要么就是数据本身有问题。 监控任务状态:这里主要是监控运行失败的任务,一旦发现任务运行失败,需要将失败类型和失败原因,通过告警给发出来,是OOM还是空指针异常还是别的什么原因,第一时间通知运维人员介入。 设置任务自动拉起机制:在一个大数据集群中,众多任务一起运行,难免存在各种偶发的任务失败情况,比如网络超时、突然的资源申请失败等,遇到这种情况,就可以通过监控脚本将其自动拉起,现实中能解决很多任务失败问题。
检查数据结果的生成时间:对于很多重要报表数据来说,一般都有严苛的SLA,比如必须在某个时间点出数据,那么针对不同的报表数据,根据其要求不同,需要对其生成时间进行检查,对于有 Miss SLA 风险的报表,需要提前预警,提前干涉。 检查每次报表生成的数据量:一般而言,对于特定业务,每次任务处理后的结果数据量,也是基本围绕在一个相对固定的值上下波动。
比如报表A,每跑一次,生成的结果在1w条左右,每次上下波动的幅度不超过10%,那么你就可以设置告警阈值为9k-1.1w,超过该范围则告警。检查结果的数据质量:这个一般需要根据业务经验来判断,比如某个计算结果的值(如某网站的浏览量),为了确保其正确性,一般可以采用同比、环比的方式进行对比,并设置一个阈值范围,超出,则证明该结果可能不正确。
还有就是一些特定字段的值,比如该值只可能出现A、B、C,但是你计算出来冒出个D,那也证明结果肯定不对。

原文作者:安瑞哥是码农;如有侵权,请联系管理员删除。

