这个是球友群里,一个球友提出来的面试题,老实说,要想回答好这个问题,需要你具备比较强的技术视野,以及同时兼具传统数仓开发经验和大数据数仓的开发经验。
否则那种八股文背诵式的回答,多少有点不能让人信服。
作为一个经历了传统数仓到大数据数仓技术变革的亲历者,来谈谈我对这个问题的看法。
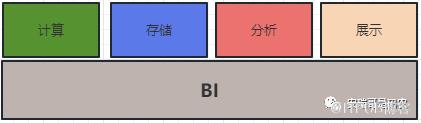
严格来说,不论是传统的数仓也好,还是用现在的大数据数仓也罢,其实现目的没有改变,都是通过汇集企业的各种来路数据,构建一套集中式的,集数据计算、分析、存储、展示于一身的企业级商业智能系统,俗称BI。
先看传统数仓
在以Hadoop为首的大数据技术出现之前,RDBMS几乎扛起了所有的数据解决方案的大旗。
大数据技术普及之前,普通的业务系统用RDBMS,数据仓库解决方案也用RDBMS,只不过后者,用了更多的机器,更多的数据库实例给组成了一个集群,来承载更多的数据分析和存储需要。
一般对于企业级的解决方案来说,用的最多的有Teradata、DB2、Oracle、SQL server,当然有些还有用MySQL、PG这样的开源方案搞定的,但据我所知,不多。
先说优点:
1. 架构简单:传统数仓受限于当时的技术掣肘,可供选择的数据解决方案挑来挑去就那么几个,企业把各个业务线的数据接过来后,就一股脑扔到一个数据库中,然后就是启动各个调度,对数据做ETL和各个层级的倒腾,最终的分析结果也在这个数据库里。
架构简单的同时,就意味着运维难度相对较低,因为大部分企业用的都是商业解决方案,且这些技术已经非常的成熟,因此软件底座出现问题的概率非常的低,对运维友好。
那个时候,最吃香的一个职业就叫DBA,他们需要掌握的技能就是在熟悉这个数据怎么玩的同时,懂得如何对你写的SQL进行各种优化和挑刺;
2. 技术栈简单:架构的简单就意味着技术栈不会复杂,传统数仓几乎可以说是一招SQL走天下,无论是数据接入,还是ETL,还是后面的建模分析,SQL统统都能给你包揽了;
3. 对数据的CRUD友好:因为是RDBMS基因,所以你要想对存储中其中的数据进行各种CRUD操作,那也是简单一个SQL就能轻松搞定的事,但是反观现在的大数据数仓,想要对数据进行修改或者删除,则需要大动干戈。
再看缺点:
1. 使用成本高:对于企业级的数仓建设来说,软件和硬件都收费,而且还相互绑定,很多数据库只能跑在小型机(上百万一台的那种)上面,光一年的软件维护费用,就要薅掉企业不少钱。

所以当年能用得起这种企业级解决方案的,都是些不差钱的单位,比如电信运营商、银行、政府机构这种;
2. 数据处理规模有瓶颈:因为使用成本高,据我所知,增加一个企业级节点(一台机器),就需要上百万的投入,而且还装不了多少数据。
因此,再怎么不差钱的单位,也不太可能这么无脑一直扩展下去,所以当时的普遍做法就是规定一个数据仓库,只保存一定时间范围的数据(比如1-2年),超出的部分,有的直接删掉了,有的则用更廉价的存储设备给备份起来。
总之,传统数仓受到当时的成本和技术所限,能够处理的数据上限是很低的。
3. 只兼容结构化数据:传统数仓受限于RDBMS强schema的特性,只能处理和存储结构化数据,那些半结构化和非结构化数据,虽然你想想办法也能搞定,但是解决过程会让你非常的难受;
4. 只能处理离线数据:受限于当时的技术条件,流式计算的概念还没有兴起,所有的数据都只能是先给存起来,然后再给挖起来计算,然后再保存计算结果,这一套流程下来,就注定这个计算结果实时不了。
大数据数仓
印象中应该是从2012年之后,随着Hadoop的逐步稳定,以及周边生态的丰富,很多苦传统数仓解决方案久已的公司,纷纷转投Hadoop生态的怀抱。
因为100%开放源代码,且天然支持分布式的分治思想,再加上这一套软件可以部署在普通的PC服务器上就能轻松跑起来,这一下子给企业不知道节省了多少真金白银。
于是各大建设传统数仓的公司,一个个都趋之若鹜,上马自己的大数据项目,来逐步取代之前的方案。
先说优点:
1. 软件不要钱、硬件不绑定:很多公司直接用的社区版Hadoop方案,一分钱不用花,然后额外购买普通的服务器就可以部署了,再也不用受制于那些传统数据库厂商建立的技术壁垒,强买强卖了;
2. 技术架构解耦:我们知道传统数仓的存储和计算是一体的、强耦合的,而大数据技术数仓的存储和计算分别隶属于两个不同的技术栈,由两个不同的技术组件来担任。
这样的好处就在于,咱可以把他们拆开了根据功能特点,各取所需,比如同一个计算引擎,我除了可以把计算结果存储到hive,我还可以存储到HBASE、Elasticsearch等其他数据库,只要我愿意。
3. 数据计算分析的自由度更高:传统数仓受限RDBMS绑定引擎的特性,只能用SQL来处理数据,而大数据技术背景下的数据计算,则灵活便捷太多。
分布式计算引擎不仅可能提供强大的算子能力,还能同时兼容各种编程语言的API、算法模型、机器学习框架等,几乎可以这么来说,只有你想不到,没有它做不到。
4. 兼容各种数据格式:传统数仓只能玩结构化数据,而大数据数仓因为丰富的数据处理能力,和各种NoSQL数据库加持,不管你有什么样的数据源,都能找到对应适合的计算方式和存储目标。
5. 支持实时计算:传统数仓几乎做不到的,大数据数仓可以,因为技术支持了,出现了功能强大的分布式消息队列,以及分布式流计算引擎,这两个组件一旦耍起来,近乎无敌;

6. 支持海量的数据计算与存储:因为软件免费(某些商业版会收取一定的licence费用),且硬件便宜,又支持动态横向扩展,所以理论上只要你愿意,你的集群规模可以就这么一直扩展下去,现在一些大公司的集群机器数量动不动就上万;
再说缺点
优点那么多,大数据数仓的缺点自然也少不了。
1. 架构复杂:存储与计算解耦的同时,也就意味着架构变得复杂,现在任何一个基于大数据技术的后端架构,基本上都需要分为这几大部分:数据接入+数据落地+数据计算+结果存储。

架构复杂就意味着稳定性的降低,以及运维成本的增加,你想,那么多组件一起配合工作,偶尔人家掉掉链子也正常;
2. 对使用者要求更高:这里指的是系统的开发人员或者运维、测试人员,架构复杂带来的是诸多不同软件的堆砌,要完成一个具体的业务功能,数据就需要经历一系列的处理链路,不同的链路需要不同的软件,那么使用者就都得熟练使用。
以前一个SQL能搞定所有事,但现在,一份数据想完成一个生命周期的闭环,它得经历数据源读取、计算引擎计算、计算结果保存,这最小的3个步骤,每一个步骤都要熟悉,否则你都不好意思说自己是个合格的大数据开发。
可能有人会说,我明明就是在大数据数仓下写SQL啊,不也能完成工作吗?
那是因为前期有人把路给你铺好了,基础设施给你建了,你的岁月静好,是因为有人已经为你做了负重前行。
3. 系统稳定性差:大数据开发相关的人员之所普通薪资较高,根本原因在于,企业在软件上的投入跟之前相比变少了,因为软件免费,那么随之带来的就是软件在使用上没有那么友好,且蕴含有很多潜在的bug,再加上那么多组件需要一起配合使用,那系统出问题的概率就更高了。
能够搞定那些在大数据量冲击下,让系统陷入各种不稳定的能力,是非常值钱的。
4. 使用不当反而适得其反:见过很多那种明明一个MySQL就能搞定的事情,非得上一套Hadoop系统,本来就不具备这样的技术实力,导致系统各种问题不断,天天檫屁股修bug,让得自己狼狈不堪。
----------------------
以上,就是我对经历过的传统数仓和大数据数仓,这两种技术背景的总结与思考,希望对你有用。

原文作者:安瑞哥是码农;如有侵权,请联系管理员删除。

