上篇文章,跟大家聊了我的Doris集群从1.2.3升级到最新版2.0.2的故事,虽然没能实现真正的“滚动式”,但整个过程都还比较顺利,好评。
但升级集群还只是第一步,接下来,咱要做的,就是把它给跑起来看看,相比于旧版本(1.2.3),它在查询上到底有没有效率上的提升,以及提升了多少?
从之前Doris官方发布的文章标题来看,说新版本「盲测10倍性能提升」,一开始吓我一跳,但点开一看,原来这个10倍,对比的是 0.15 版本。

但我这没有0.15版本的Doris集群,所以暂时无法去对这个结论进行证伪。
至于对比1.2版本,有多少性能提升,文章中没有详细说明,但是从它给出的对比结果图来看,2.0版本的查询效率是要更高的。
但至于能快多少,或者说是不是真的就一定快?
咱还是老规矩,跑起来试试看。
0. 准备
因为之前之前在 Doris1.2.3 的时候,我们其实已经做了很多次对 Doris 的查询性能测试(有兴趣可以去查看历史文章),那么这次,咱们就可以简单点,直接沿用之前用过的查询SQL语句,面对数据量一模一样的表,再次发起查询,看效率到底有什么变化。
注意:这里数据量一模一样,可能并一定代表里面的数据完全一样,因为在此期间,有的表数据内容发生过一些更改,但是不影响查询效率对比的结论。
由于当前这个 Doris 集群暂时就我一个人在用,几乎不存在外部一些因素的干扰,因此,这个测试对比很公平。
由于表以及表中的数据都是现成的,所以,其实没什么可准备的,只需要将之前1.2.3版本时测试的结果,找出来跟现在升级后的做个对比,就可以了。
废话不多说,咱直接开始。
1. PK开始
1.1 找出target_ip为空时(实际数据为双引号),此时每个不同domain的个数(要求domain统一小写)
查询SQL为:
select
domain,
count(domain) as count
from
(
select
lower(domain) as domain
from
logs_from_spark01
where target_ip='""'
)t
group by
t.domain;
之前1.2.3的测试结果:

耗时0.21秒。
升级到2.0.2后:
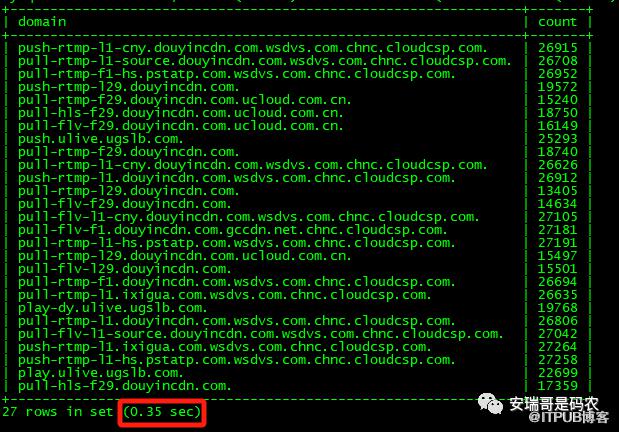
经过多次测试,取平均成绩,为0.35秒。
结论:虽然相差不大,但升级后,针对该查询,效率变慢了一丢丢。
注意:两次查询的结果不完全一样,是因为表数据量一样,但是部分数据发生了更换导致(下同)。
1.2 查询上网次数最多的前100个client_ip,以及他们分别的归属地是哪里
查询SQL如下:
select
t1.client_ip,
t2.nature,
t2.province,
t2.city,
t1.count
from
(
select
client_ip,
count(client_ip) as count
from
logs_from_spark01
group by
client_ip
order by
count desc
limit 100
)t1
inner join
logs_from_spark01 t2
on
t1.client_ip=t2.client_ip
group by
client_ip,
nature,
province,
city,
count
1.2.3版本查询结果:
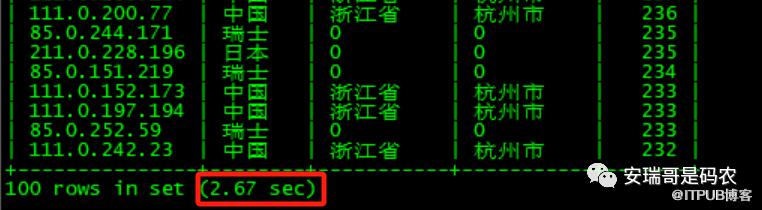
耗时2.67秒。
升级后的2.0.2,查询结果:
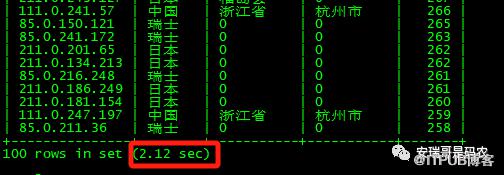
运行多次,取效率最差的结果,耗时2.12秒。
结论:升级后,针对该查询,效率有所提升,但不多。
1.3 count distinct的效率对比
低基列的查询场景:查询 client_ip 字段的count distinct。
1.2.3版本的查询结果:
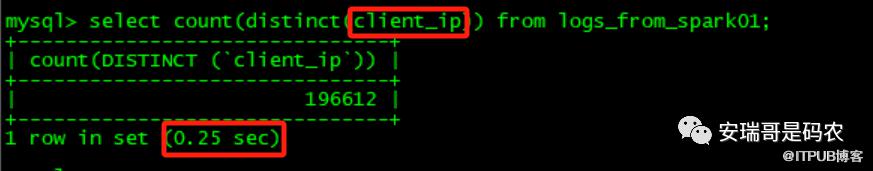
耗时0.25秒。
升级到2.0.2版本的结果:

耗时0.24秒。
结论1:针对低基列的查询,升级前后,几乎没有差别,打平。
高基字段的查询场景:查询 domain(区分大小写情况下) 字段的 count distinct。
1.2.3版本的查询结果:

耗时3.4秒。
升级到2.0.2之后的结果:
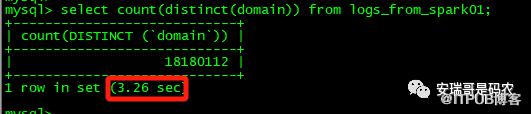
多次查询,取最差成绩,耗时3.26秒。
结论2:针对高基列,升级后,查询效率快了一丢丢。
1.4 以分钟为标准,找出连续上网次数最多的前100个client_ip
查询SQL:
select
client_ip,
max(row_num2) as max
from
(
select
client_ip,
row_num2,
date_min
from
(
select
client_ip,
sub_date,
row_number() over (partition by client_ip,sub_date) as row_num2,
date_min
from
(
select
client_ip,
date_min,
row_number() over (partition by client_ip order by date_min) as row_num,
minutes_sub(to_date(date_min), row_num) as sub_date
from
(
select client_ip,
date_min,
row_number() over (partition by client_ip,date_min order by date_min) as row_num
from
(
select
client_ip,
minute_floor(time) AS date_min
from
logs_from_spark01
where
length(time)=14
and
time like '20220730%'
)t
) A
where A.row_num=1
) B
) C
)D
group by
D.client_ip
order by max desc
limit 100
1.2.3版本的查询结果:

耗时17.57秒。
升级到2.0.2之后的结果:

多次测试,取最差成绩,耗时13.26秒。
结论:升级后,针对该查询,效率有所提升。
1.5 查询出 client_ip 中包含的所有国家、省份、城市,以及运营商
查询SQL:
select
nature,
province,
city,
operator
from
logs_from_spark01
group by
nature,
province,
city,
operator;
1.2.3版本的查询结果:

耗时0.68秒。
升级到2.0.2之后的查询结果:

多次查询,取平均成绩,耗时0.81秒。
结论:升级后,查询效率反而降低了那么一丢丢。
1.6 查询表中不重复数据的数据总条数
因为用的是duplicate表模型,所以没有去重功能,而这里的不重复,指的是整行内容都不重复(个人认为这个查询在某些场景下还是有必要的)。
还记得上次对比Clickhouse的时候,CK是可以支持一种非常简洁写法(distinct(*))的,当时Doris的1.2.3不支持,但即便升级到现在的2.0.2,Doris依然不支持这种简洁的写法。
于是升级后的Doris,SQL依然只能这么写:
SELECT
count(*)
FROM
(
SELECT
*,
row_number() over (partition by client_ip, nature, province, city, operator, domain, time, target_ip, rcode, query_type, authority_record, add_msg, dns_ip) as row_num
FROM
logs_from_spark01
)t
WHERE t.row_num =1;
1.2.3版本的查询结果:

耗时33秒。
升级到2.0.2版本的结果:

测试多次,取平均成绩,耗时40秒多。
结论:升级后,针对该查询,效率反而变低了。
最后
这次对比测试,用我能想到的办法,在尽可能排除外部干扰的情况下,用多次测试的结果,来尽量保证测试的公平性。
你可以从文中看到,凡是升级后效率变高的,我取的都是成绩最差的,以此来证明升级后,查询效率确实提升了。
而如果升级后效率变低了的,我则取的测试平均值(相对平均),以此来反映升级前后真实的差距。
从这次的6个场景,一共7个查询SQL对比结果来看,新版本PK老版本的结论是:一平、三胜、三负。
所以,单纯从这次的查询效率对比来看,升级后的Doris2.0.2跟升级前的Doris1.2.3,打了个平手。
对于这个测试结论,你同意吗?
原文作者:安瑞哥是码农;如有侵权,请联系管理员删除。

