这些天,一直都折腾,看可以通过哪些手段来导mysql表的数据源到各个目标数据库中,为了摸清楚当下大概有哪些导入方式,找出我认为最靠谱,最方便的,可谓煞费苦心。
前两篇文章分别介绍了用dataX和CK外部表的玩法,通过基于我的应用场景实践,详细说明了这两种数据导入方式谁更靠谱。
那么今天咱再来试试用Flink的CDC方案,用它来读取mysql表,并把数据写入到Doris,看整个过程有哪些坑,以及是否方便、靠谱。
其实从Flink官网来看,flink读取mysql,还有一种jdbc的方式,只不过CDC这个概念被Flink宣传的过于火热,咱还是决定从它先开始。
0. 环境准备
既然要用Flink CDC这个功能(至于啥是CDC,网上遍地的资料,这里暂不解释),那高低得看一眼CDC的官网,看看我们在使用这玩意时,需要注意哪些内容。
Flink CDC官网地址(注意:它跟Flink官网是分开的):https://ververica.github.io/flink-cdc-connectors/master/content/about.html
这个官网最大的优点就是:可以不用梯子。
由于我当前开发环境Flink用的1.15版本,所以我第一个关心的问题就是,CDC作为一个额外的flink生态组件,我该选哪个版本?
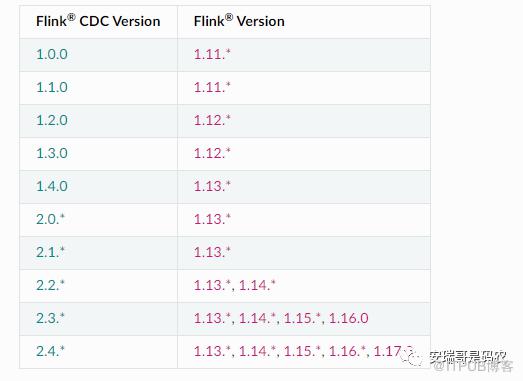
不出所料,官网给出了详细的版本兼容性列表,因此我的1.15可以选择的CDC版本有两个:2.3跟2.4,既然是测试,这里我选择最新的2.4版本。
于是,我需要在我的IDE开发环境里,引入对应的pom依赖:
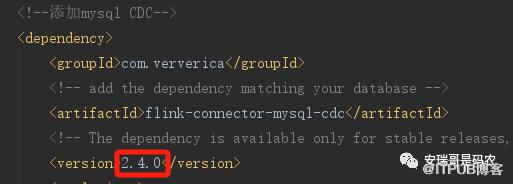
关于本次测试需要的所有组件版本,如下表所示:
| 组件名称 |
版本 |
| Flink |
1.15.3 |
| Flink CDC |
2.4.0 |
| mysql |
5.5、8.0 |
| Doris |
2.0 |
1. 创建mysql数据源
本来我的集群有台机器已经部署了mysql,这个mysql是CentOS7官方默认源自带的,版本为5.5,一开始想着直接就在这个mysql上做测试得了。
但是,我简单写了个demo跑一下发现,当前版本的mysql对于Flink的CDC来说,太低了,抛出了如下的异常:
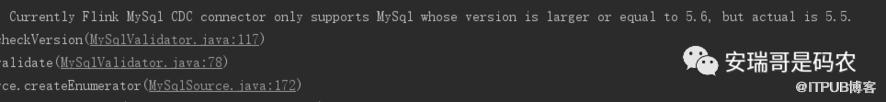
果然,想使用这玩意,也不是谁都配的,回头再去确认了一下官方文档,需要mysql版本不能低于5.6(那低版本的数据想用Flink同步咋整呢?可能需要试试JDBC方案)。
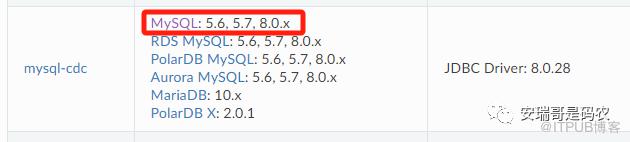
于是就只能去部署一个更高版本的mysql实例,于是我就果断下了个mysql8给部署起来了。
还是拿我之前的上网日志数据,根据数据特点先建表:
CREATE TABLE `test02` (
  `client_ip` varchar(50) NOT NULL,
  `domain` varchar(100) NOT NULL,
  `time` varchar(20) NOT NULL,
  `target_ip` varchar(50) NOT NULL,
  `rcode` int NOT NULL,
  `query_type` int NOT NULL,
  `authority_record` text,
  `add_msg` text,
  `dns_ip` varchar(50) DEFAULT NULL,
  PRIMARY KEY (`client_ip`,`domain`,`time`,`target_ip`,`rcode`,`query_type`)
至于为什么这个Primary key是这么多的字段组合,原因在于如果不这样,容易造成因为主键重复导致数据写入失败。
随后,我用load data语法,将一个本地数据文件给导入到该表中,在导入中发现,即便上面这个Primary key的组合实际内容并没有重复,但还是报了一些重复主键的错误,所以我怀疑,它这个组合键判断是否重复的依据,是用的hash值。
为了快速达到测试效果,我只往这张表里先写入了1百多万数据:
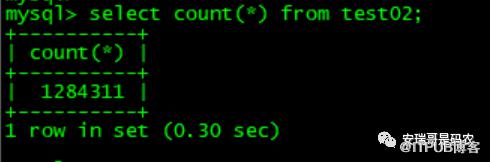
当然,还需要在该数据库创建一个,外部可以连接到该表的一个外部用户,并对其赋予相关的权限,过于简单的内容,这里就不赘述了。
2. 导入有哪些坑
为了让代码更加简洁方便,这里用Flink的SQL API,不得不说,是真香。
package com.anryg.mysql_cdc

import java.time.Duration

import org.apache.flink.contrib.streaming.state.EmbeddedRocksDBStateBackend
import org.apache.flink.streaming.api.CheckpointingMode
import org.apache.flink.streaming.api.environment.CheckpointConfig.ExternalizedCheckpointCleanup
import org.apache.flink.streaming.api.scala.StreamExecutionEnvironment
import org.apache.flink.table.api.bridge.scala.StreamTableEnvironment

/**
  * @DESC: 用Flink CDC读取mysql写Doris表
  * @Auther: Anryg
  * @Date: 2023/11/6 20:02
  */
object FlinkSQLFromMysql2Doris {

    def main(args: Array[String]): Unit = {
        val env = StreamExecutionEnvironment.getExecutionEnvironment

        env.enableCheckpointing(10000L)/**这个必须加上,否则数据入不了库*/
        //env.setParallelism(args(0).toInt)

        env.setStateBackend(new EmbeddedRocksDBStateBackend(true)) //新的设置state backend的方式
        env.getCheckpointConfig.setCheckpointStorage("hdfs://192.168.211.106:8020/tmp/flink_checkpoint/FlinkSQLFromMysql2Doris")
        env.getCheckpointConfig.setExternalizedCheckpointCleanup(ExternalizedCheckpointCleanup.RETAIN_ON_CANCELLATION) //设置checkpoint记录的保留策略
        env.getCheckpointConfig.setAlignedCheckpointTimeout(Duration.ofMinutes(1L))
        env.getCheckpointConfig.setCheckpointingMode(CheckpointingMode.EXACTLY_ONCE)

        val tableEnv = StreamTableEnvironment.create(env)


        /**第一步:读取mysql数据源*/
        tableEnv.executeSql(
            """
             Create table data_from_mysql(
             |`client_ip` STRING,
             |`domain` STRING,
             |`time` STRING,
             |`target_ip` STRING,
             |`rcode` int,
             |`query_type` int,
             |`authority_record` STRING,
             |`add_msg` STRING,
             |`dns_ip` STRING,
             |PRIMARY KEY(`client_ip`,`domain`,`time`,`target_ip`,`rcode`,`query_type`) NOT ENFORCED
             |)
             |with(
             |'connector' = 'mysql-cdc',
             |'hostname' = '192.168.221.173',
             | 'port' = '3306',
             | 'username' = '****',
             | 'password' = '****',
             | 'database-name' = 'test',
             | 'table-name' = 'test02'                      //确定文本数据源的分隔符
             |)
            """.stripMargin)


        /**第二步:创建Doris映射表*/
        tableEnv.executeSql(
            s"""
               |CREATE TABLE data_from_flink01 (
               |`client_ip` STRING,
               |domain STRING,
               |`time` STRING,
               |target_ip STRING,
               |rcode INT,
               |query_type INT,
               |authority_record STRING,
               |add_msg STRING,
               |dns_ip STRING
               |)
               |    WITH (
               |      'connector' = 'doris',
               |      'fenodes' = '192.168.221.173:8030',
               |      'table.identifier' = 'example_db.data_from_flink01',
               |      'username' = '***',
               |      'password' = '***',
               |     'sink.label-prefix' = 'load01'  //导入标签前缀,每次要不一样
               |)
            """.stripMargin)

        /**第三步:数据写入到Doris表中*/
        tableEnv.executeSql(
            """
              |INSERT INTO data_from_flink01
              |select
              |*
              |from
              |data_from_mysql
            """.stripMargin)

    }
}
代码逻辑虽然非常简单,但是这玩意跑起来到底有没有坑呢?
那必须有。
2.1 坑1
从我这些年的开发经验来看,几乎但凡你要往原本已经相对成熟的软件项目中,再次引入新的pom依赖,那势必会将原本宁静祥和的依赖环境,掀起一场血雨腥风。
具体表现就是:新代码各种报错,老代码也可能跑不利索。
先来看引入Flink CDC依赖之后,新代码抛的第一个异常:
Caused by: java.lang.ClassNotFoundException: com.google.common.collect.RangeSet
 at java.net.URLClassLoader.findClass(URLClassLoader.java:382)
 at java.lang.ClassLoader.loadClass(ClassLoader.java:418)
 at sun.misc.Launcher$AppClassLoader.loadClass(Launcher.java:355)
 at java.lang.ClassLoader.loadClass(ClassLoader.java:351)
说没有找到 com.google.common.collect.RangeSet 这个类。
既然这样,那就只能用老办法来排除了。
先利用IDEA的类查找功能,在当前项目瞅一眼,这个类,它到底有没有?
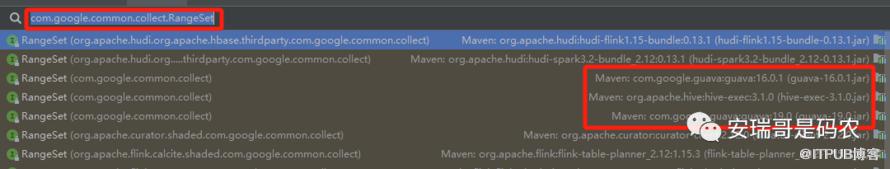
不仅有,而且有3个jar包都包含这个类(1个 hive-exec 包,2个 guava 包),所以你是不是就此判断,是因为这3个jar包冲突导致的这个报错呢?
其实不然,要知道,这里查找出的结果,是当前软件工程中,所有module的,也就是说,咱们的目标module(flink CDC所在的module),是不是真有这些jar包,还不一定,还得进一步确认。
果然一查发现,在flink cdc这个module下,hive-exec 这个包它就没有,而 guava 的包也只有个低版本的。

那根据我的经验判断,应该是当前module缺少高版本的 guava 包导致的报错(毕竟这个破包已经在我的多个项目中留下了案底,所以印象深刻),那既然是需要高版本,自然就想到要把这个低版本的guava给先排除掉。
于是,先排除低版本的guava,再引入一个高版本的guava。

干掉低版本的,添加高版本的
(PS:大家可能会觉得,这看起来挺简单的嘛,但如果要是你在开发时遇到了这个问题,你能做到这么头脑清醒,思维缜密吗)
2.2 坑2
继续启动代码,又抛出下面这个错误:
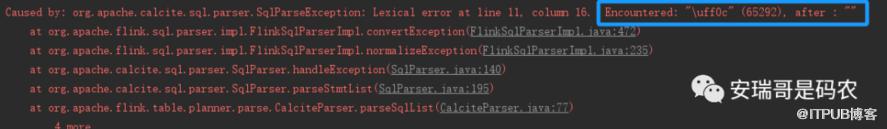
从错误提示来看,好像是某个数据格式不规范而导致的问题。
于是呢,为了确定这一点,我就新建了张表结构一样的空表,再次启动程序发现,还是报这个错。
于是我开始怀疑是表字段问题,就又开始逐个排查,从建一个字段的表,逐渐增加到建包含所有字段的表,居然,又都不报错了。
然后我在新表中写入数据,再次启动程序,发现也正常了。
最后,我再次让程序读取最开始报错的那张表,之前的错误居然消失了,要知道,我期间没有做任何的修改,就离谱。
合着试一圈下来,是在玩我呢!
经过多次反复的尝试,我很怀疑这玩意就是flink CDC的bug,偶发,没有特定规律。
3. CDC的写入逻辑验证
填完上面的坑之后,再次启动程序,就能很顺利将mysql中的数据全部导入到Doris的目标表中了。
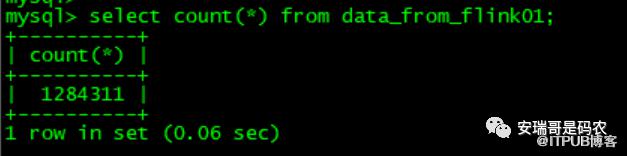
可以看到,已经把之前写入到mysql中的所有数据,一条不落的都导入过来了(对比上面mysql数据量的截图),而且速度很快。
起初,我原本想着,既然是CDC,程序是不是只会捕获变化(新增)的数据才对,至于存量的历史数据(导入程序启动之前就存在的数据),可能不会导入。
但是经过验证,Flink CDC它做到了,通过查看程序运行的日志可以发现,它之所以能做到这一点,跟它读取的是binlog日志密切相关。
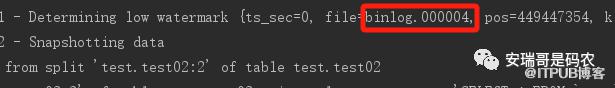
CDC程序运行过程的日志
为了进一步验证这一点,我把mysql的binlog功能给关了试试,于是我在配置文件中加入这个:
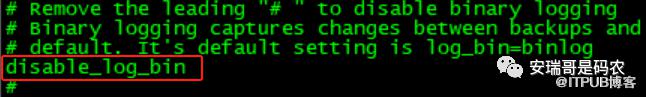
然后重启mysql,结果发现很快,CDC程序就报错了:

所以说明,mysql CDC能使用的前提是:必须要开启binlog功能。
为了进一步验证CDC程序能感知binlog的哪些操作,我又分别对mysql的源表做了update、insert和delete操作,咱分别都来看一下,这些操作会对Doris目的表有哪些影响?
先看update:
用update对mysql源表,其中的两条记录的某个字段值做个修改。

然后再来看Doris目标表的记录数有没有变化:
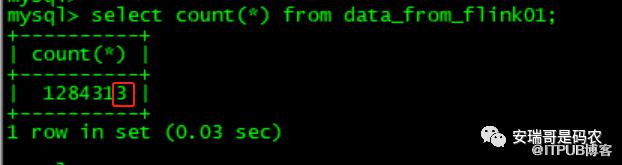
可以看到,数据如期增加了2条(因为Doris这边创建的是Duplicate模型表,所以是新增,不是覆盖)。
再看insert:
接下来测试了新增记录的情况,往mysql表写入若干条记录,程序能如期识别到并写入到Doris目标表中(过于简单,就不截图了)。
最后看delete:
但是有意思的是,当我在源表中尝试把之前修改过的2条记录给删除掉,结果你猜怎么着,Doris目标表依然新增了那两条我想要删除的记录。
也就是说:
对于Flink 的mysql CDC来说,除了对源表的select外,其他的如insert、update、delete 操作,都会触发程序对目标表的新增数据。
所以保险起见,为了防止数据重复,对于承接CDC结果的目的表,最好使用去重表模型。
最后
从测试的结果来看,mysql的CDC能很好的满足我们的数据导入要求,只不过,并不是所有版本的mysql都有这个资格(需要5.6及以上版本)。
而且从实践来看,对Flink mysql CDC的使用也并不没有任何门槛,这里面的一些坑,甚至隐藏的bug,都要求开发者有一定的问题排查和解决能力。
本来还想着基于同样的场景,来对比一下spark的,但限于文章篇幅,今天就到这里。
下一篇,咱接着聊spark structured streaming 在这方面的表现怎么样...
原文作者:安瑞哥是码农;如有侵权,请联系管理员删除。

