上篇文章写到了 streampark 的基础部署,以及简单体验了下通过该工具的页面,来部署和配置一个流式任务的完整过程。
从初次体验来看,给我的感受比较一般,主要体现在对一些配置的操作和反馈上表现不佳,必要的官方文档说明缺失,以及个别地方设置的不合理等。
那经过我接下来的一番稍深入研究使用后,这个工具用起来到底怎么样呢?我们一起来看看。
0. 必要准备
话说既然上一篇已经把 streampark 的基础服务给部署好了,现在要做的,就是通过它提供的页面,各种点点点,来完成对于一个流式任务的开发和部署。
但是,光成功启动了 streampark 的基础服务还远远不够,接下来,你必须得发挥自己聪明的头脑(因为官网压根就没有明确说明),准备下面这两个基础环境:
基础环境1:
当前部署的 streampark 节点必须得是 Flink 的客户端(如果要部署Spark应用,同理),也就是说,你必须你要把Flink的那套安装包拷贝到当前服务器,比如,我把它放到了这个目录下:

至于为什么?因为你要在这台机器上提交Flink任务呀。
基础环境2:
如果你想把 Flink 任务跑在 YARN 上,那就得让 Flink 和 steampark 知道,yarn在哪,所以你先得在 Flink 的环境变量中加入hadoop(因为yarns是hadoop的核心组件之一)相关的配置。
怎么加?可以加在Flink用户的个人概要文件里(也可以设置为全局的),如下图所示:

其次,用同样的办法把 hadoop 的安装包拷贝到这台机器上,让这台机器也成为 hadoop 的客户端,同时确保 /etc/hadoop/conf/ 目录下要有yarn-site.xml文件,否则提交Flink任务时,找不到yarn地址(踩过坑)。
好了,做好以上这两步,接下来的故事,才有发生的可能。
1. 基础配置
进入 streampark 的页面,首先映入眼帘的,就是这个系统设置:

跟平时你用 IEDA 开发一样,需要设置对应的Maven配置、私服地址、相应的用户名、密码,方便第三方引用 jar 包的下载,后面你创建任务时,要下载的jar包就根据这个设置来。
因为这个 streampark 的核心目的,就是用来部署和管理 Flink 任务,所以接下来需要配置Flink的相关属性。
第1个:设置Flink Home
根据图示,把刚才部署Flink客户端时,相关的目录填写到下面对应的内容里:
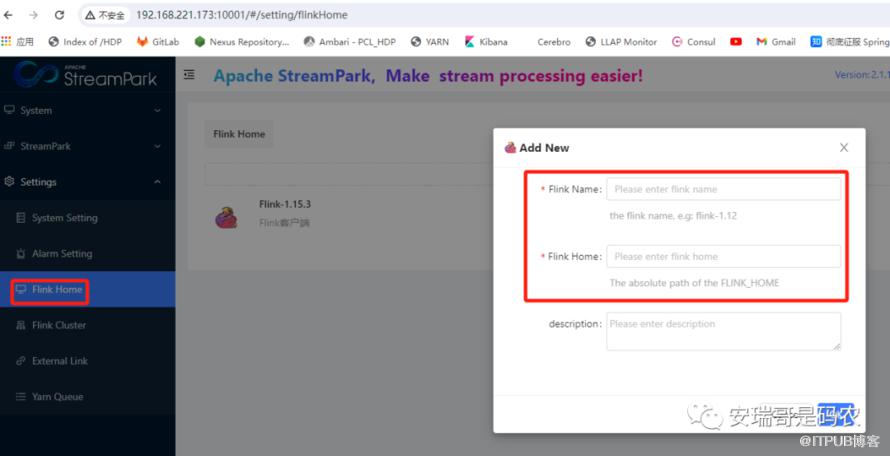
然后点击一下下面这个小按钮,可以查看到对应的 Flink 配置文件内容:

确认无误后,这步就结束了。
第2个:设置Flink Cluster
理论上这一步的设置其实不是必须,设置它的目的在于,我们一会要通过「yarn session」的方式来部署 Flink 任务(当然,你也可以选择普通的 yarn application 方式部署,那这一步就可以省去)。
我们知道,「yarn session」的部署方式特点在于,它是可以多个任务共用 jobmanager 的,所以就需要你提前在yarn上,把这个共用的 jobmanager 启动起来。
设置很简单,如下图:

给它先取个名字,然后选择yarn session,再选择刚才设置的 Flink home 地址,把这3个必填项填好,理论上就可以了(想更进一步设置更多内容,自行研究,这里不展开)。
但这里有个坑!
那就是当你配置好之后,需要启动它,当你点击下图按钮,去部署这个Flink cluster 后,

后台会自动根据你前面配置的HADOOP_CONF目录,找到对应的yarn地址,去启动一个基础的 yarn 任务。
但是,这里有个问题,那就是对于这个yarn任务启动的超时时间,非常短,默认估计也就20秒不到(猜的),然后就因为超时报错了。
但是我们知道,对于yarn任务的启动,如果当前集群比较繁忙,是需要等待一段时间的,正常30-60秒都有可能。
这就导致实际后台任务一段时间后,虽然启动成功了,但是因为默认的这个超时时间太短,提示超时报错后,导致 streampark 也感知不到。
也就是说,虽然后台的 jobmanager 启动成功了(超时之后),但是这个Flink cluster 依然部署失败。
所以你只能期待在启动这个yarn session 的时候,当前yarn环境很给力,很快就能申请到资源,否则就不行。
就还挺蠢的。
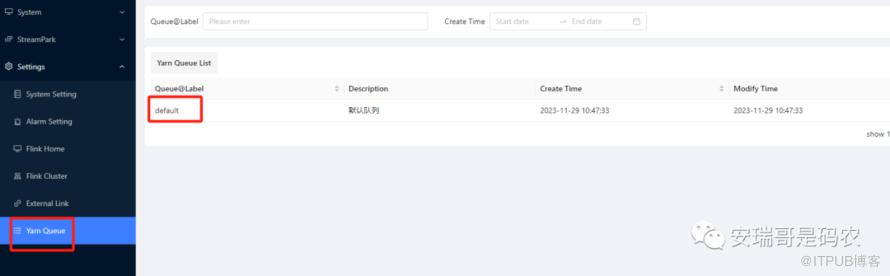
第3个:设置资源队列
用来指定你的 Flink 任务提交的 yarn 资源队列,这个不是必须,如果不设置,会默认提交到 default 队列:
2. 正式开始
以上配置完毕后,就可以正儿八经部署 Flink 任务了。
那咱就先部署一个简单的 Flink SQL 任务,部署方式呢,其实有两种:
第1种:以单独应用的方式部署
这种方式最为简单,适合部署独立的小应用,步骤如下图:
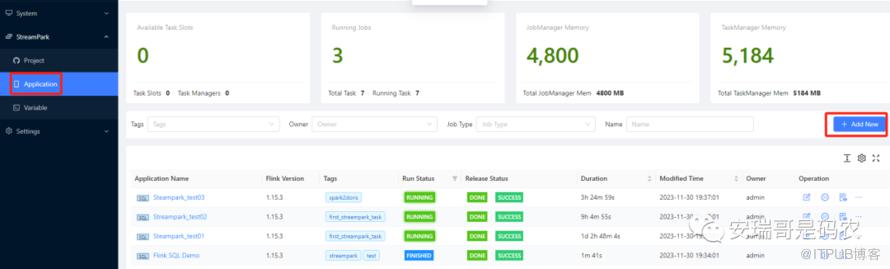
点击添加新应用。
然后填写其中的必填项:
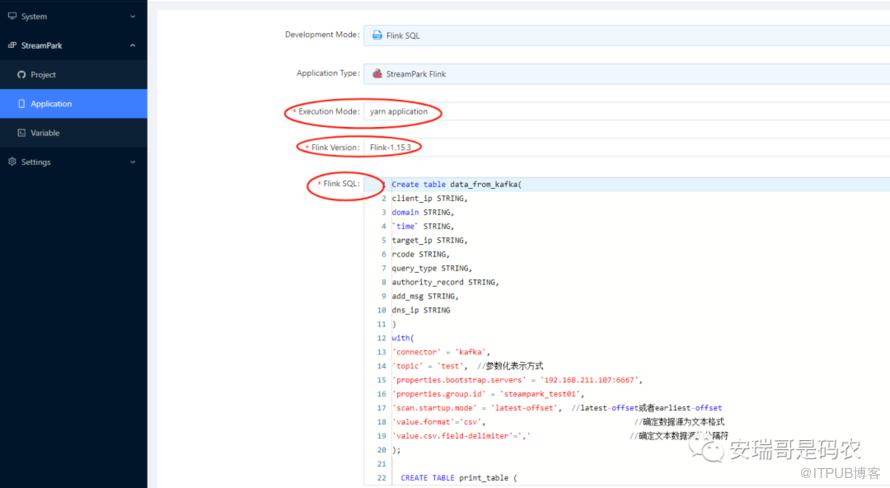
往下拉:
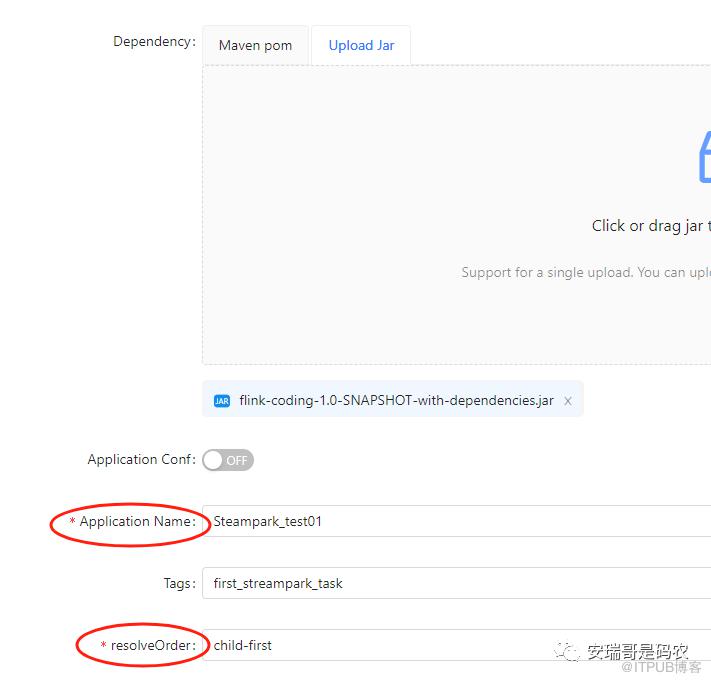
这里需要注意的,虽然这个 Dependency 看上去不是必填项,但你要是敢忽略它,程序一定跑不起来,因为它需要你要么填写当前程序需要的pom依赖,要么直接把依赖的jar包上传上来。
为了方便,我选择了后者(因为我本地的IDEA开发环境已经有打好的依赖包了)。
点击Submit提交保存。
然后,点击发布应用:
待应用发布成功(按钮直接就变成下面的),再点击启动运行按钮:
点击后,就运行起来了:
到了这里,你是不是以为还挺简单的?
我只能告诉你,顺利的部分,到此结束!
接下来就是踩坑的时刻,比如这种部署方式,实际上貌似不允许我通过配置 pom 来解决 jar 包的依赖问题。
比如,我根据官网要求添加如下依赖配置:
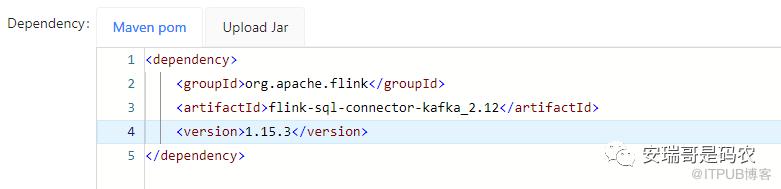
结果当我点击发布时,直接就报错了:

说我的私服找不到这个包。
这不开玩笑嘛,这个私服我天天用,有没有这个包我难道不知道吗?
开始我以为是私服地址填写的有问题,又换个写法,然后还检查了一遍对应的用户名和密码,确认没有毛病后,还是一样的错误。
我只能暂时判定,这玩意太难用。
第2种:以项目方式进行部署
这个就类似于我们在 IDEA 创建一个软件工程,然后在其中进行编码和部署。
具体创建方式就是填写下面的配置:
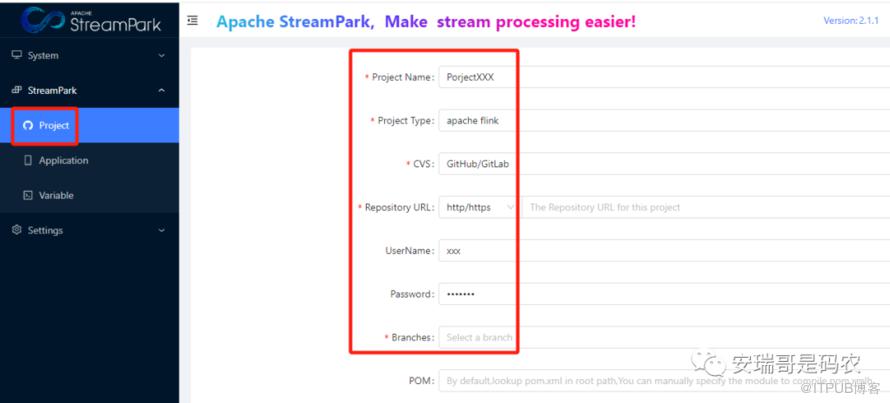
这里目前只支持通过 git 拉取项目。
创建好之后,需要进行编译,点击编译按钮:

但是很快,就报错了:
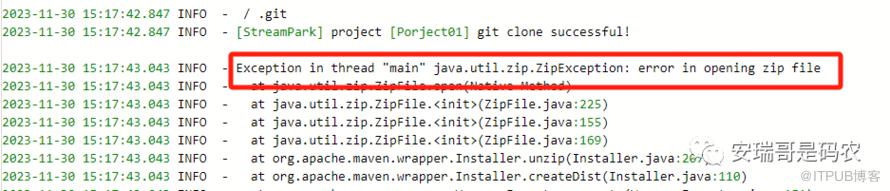
日志虽然显示代码已经拉下来了,但是却出现了一个打开zip文件的报错。
我在想,我这个项目里也没有zip文件啊,你丫打开个锤子啊。
(PS:其实在此之前,还报了一个运行编译脚本的错,被我改源码解决了)
关键是,我换成另一个代码结构更简单的项目后,结果还是一样的,一时半会实在是不知道原因在哪,折腾一会之后就放弃了。
想想,还是我的IDEA靠谱,或者如果我想实现快速的自动化部署,我也有专门的CICD工具(Jenkins),人家同样是从git拉代码下来编译,然后打包,怎么就没这么多破事呢?
3. 其他吐槽
从我的这两天使用体验来看,这个 streampark 的目标,虽然是想构建一个集开发、部署、运维自动化于一体的综合性工具。
虽然也能在某个狭窄的角度,确实可以完成某些 Flink 任务的开发和部署。
但是,它的槽点,至少目前来看,是非常多的。
比如还有:
1. savepoint 的问题
明明我在启动任务前,是设置了savepoint目录的,而且是它让我设置的:

但就是没有生效:

而是在没有经过我本人同意的情况下,给我安排了另一个目录:
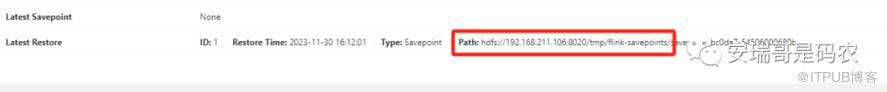
我就想问:人与人之间的尊重去哪了、信任去哪了?
2. 链接的跳转问题
比如,我一个任务提交运行之后,可能失败了,也可能正在运行,点击到它的 detail 页面之后,对应的的状态那里会有相应的链接,按理来说是可以跳转到对应的任务页面的。
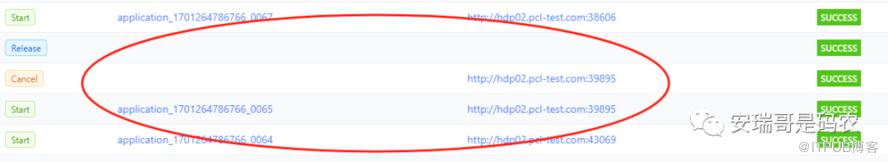
但是,图中你看到的所有这些链接,你可以点,但就它喵的全是空的,主打一个逗你玩。
当然还有其他的,这里竟一时想不起来了...
最后
事实证明,这玩意至少现阶段,个人认为还不够成熟,诸如官方文档描述过于简单、寒酸,以及使用过程中各种明显的bug,明显的瑕已掩瑜。
反正我现在肯定不用,还是IEDA更香一些。
对于 streampark 你怎么看?
原文作者:安瑞哥是码农;如有侵权,请联系管理员删除。

