就在上篇关于 Dinky 部署的文章发布几个小时后,Dinky 社区的小伙伴就找到了我,针对我指出来的,关于目前他们官方文档书写的一些问题,以及没有提供直接的安装包问题做了回应和解释。

首先呢,他们意识到了,并承认官方文档在描述上面存在不足这个事实,然后解释了具体原因;
其次,对于文档中为什么没有给出直接可使用的安装包(目前只能根据源码编译),也说明了他们的难处,原因在于新的文档还没有完成相关部门的审核,导致把对应的链接给隐藏了,然后他私发了我。
既然官网现在不能放安装包的链接地址,那我就把它放到我文章这里:
https://gitee.com/DataLinkDC/Dinky/tags 有兴趣的同学可以去自行下载
从这个回应来看,对方是带着满满的诚意以及解决问题的态度来的,个人觉得这,这才是开源生态应该秉持的精神。
既然人家对我如此信任,那咱自然也不能辜负这份信任对不对(当然,该批评还是得批评),于是,我第一时间就把这个安装包给下载了下来。
那么今天这篇文章,咱就根据这位 Dinky 社区同学提供的地址,下载最新版的 Dinky(0.75),再次把它给“玩”起来,看看它的表现到底如何?
0. 为啥不建议用Docker
因为确实不好用,核心原因在于,目前官方提供的可以下载的镜像,虽然可以很方便让你把 Dinky 服务启动起来。
但是,如果你想要正常跑起来一个流式任务,就需要额外配置很多东西,比如:
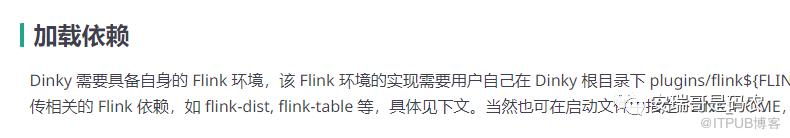
以及对相关配置文件内容的修改,这个时候,Docker的一些不便利性就凸显了出来。
一般针对这种情况,我们有2个解决办法:
1. 用 docker exec 进入到容器内部,用相关的命令对其内容进行操作,但是呢,这个容器对于一些必要的命令工具,居然没有:

于是我就想,那我用 yum 装一个吧,也不行,因为 yum 也没有。
2. 既然这样,那我一般还有一招,就是把对应的目录给映射出来到我的宿主机(用 -v 参数),然后在我的宿主机上修改是不是也可以?按理说是行的,但是,容器却启动不起来。
鉴于以上2个原因,决定放弃用 Docker 的方式。
1. 安装包部署
从社区同学给我提供的安装包链接来看,最新版本的 Dinky 以及支持到了0.75:

于是我就下载了这个 0.75 版本。
下载到目标服务器之后,通过解压之后,目录结构长这样:

1. auto.sh:Dinky 服务的启动/停止脚本;
2. config:用来放置所有的配置文件;
3. jar:针对不同的 Flink 版本,跟Dinky整合的jar包;
4. lib:Dinky运行时需要依赖的核心jar包,比如Springboot、tomcat等;
5. plugins:存方Dinky支持的外部catalog,以及部署流式任务时,需要依赖的额外jar包(后续添加的依赖包,都建议放这里);
6. run:存放服务运行时的pid文件;
7. sql:在 mysql 上的建表语句,或者升级dinky时,需要运行的升级 SQL;
搞清楚了各个目录的作用之后,接下来就是要修改必要的配置了。
首先,修改元数据存储的相关配置,毕竟,服务启动的第一步,就需要记录元数据信息:
vi config/application.yml (注意修改的方式)
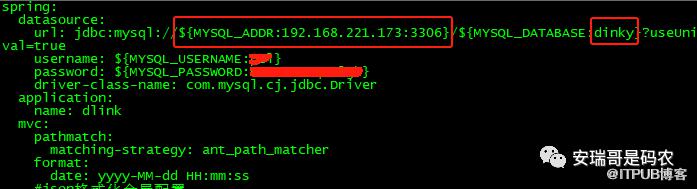
核心就是修改图中我框出来的地方,至于后面其他的配置,除非你有更高的追求,否则暂时可以不用动。
按理说,根据部署一般软件的思路,修改好必要配置之后,就可以通过启动脚本(命令),来启动服务了。
但是...
第一个坑(JDK版本不能过高):
根据文档要求 ,执行启动脚本:

从这个返回信息来看,好像启动成功了。
但是,对应页面的 8888 端口无法打开,且从对应的日志配置文件中来看:
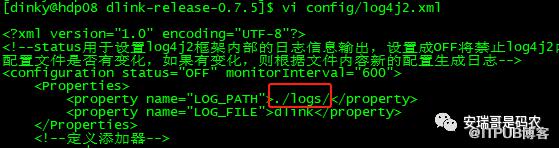
应该在当前目录下生成一个logs文件夹,然后写日志才对,但是,它没有。
当然,通过 jps 命令 或者 ps -ef 命令也找不到对应的任务。
程序没有启动,日志没有生成,且对应的程序也找不到,那接下来就只有一招了。
看源脚本:
打开 auto.sh,然后找到启动该脚本时调用的 start 函数:

可以看到,这里是通过启动一个 Java 任务来启动服务的。
那既然是这样,咱是不是可以自己手动来启动这个服务试试看呢?
说试就试,虽然这个命令中涉及到了几个变量,但通看一眼整个脚本的内容,其实都有定义。
于是,咱可以这么干,先给这个必要变量赋值:

然后,再启动那个Java命令:

从这个报错来看,似乎原因找到了,居然是启动参数有问题。
然后我又瞅了一眼当前服务器的JDK,发现居然是17的:
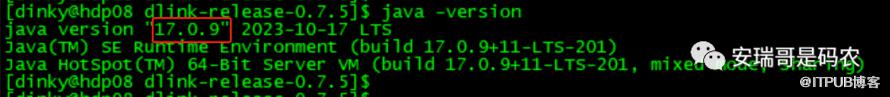
好嘛,既然官网要求8,那咱就给它回退回来再试。
于是,通过命令就把之前部署的 JDK8 替掉现在默认的(一个服务器可以部署多个JDK版本),再次启动命令。
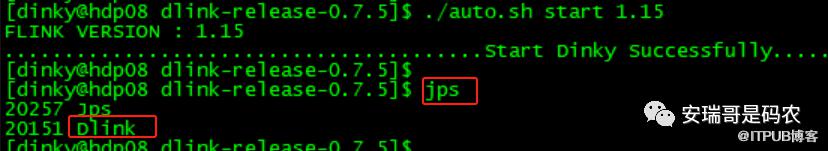
貌似可以了,但是,保险起见,得瞅一眼日志(这个时候logs目录也正常生成了)。

日志显示没有问题.
再打开网页,当然也就没有问题。
2. 添加必要依赖
顺利部署完基础服务,接下来,才是能否把这玩意“耍”起来的重头戏。
刚进入这个页面,就可以刚看到右手边有这么个配置向导:
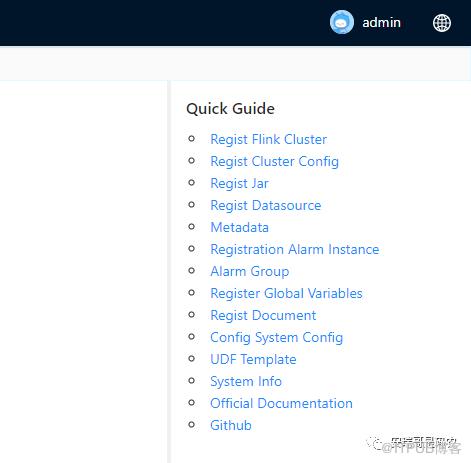
这块内容其实跟之前用的 streampark 很像,都是要你配置Flink home 以及 yarn 相关的设置(因为需要flink on yarn)。
到这一步的时候,我突然想到文档中有提到需要添加一个额外的依赖包:

而其中一个文中特意提到的包是 flink-shade-hadoop-3 ,刚好我的Hadoop环境正好的3.x。

于是根据它的说明,我就把这个包下载下来,并放到了指定的位置。
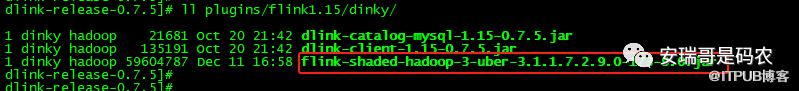
至于它能发挥多大的作用,暂时还不清楚(可能可以避免一些坑吧)。
为了让刚才添加的jar生效,需要重启服务。
3. 添加集群配置
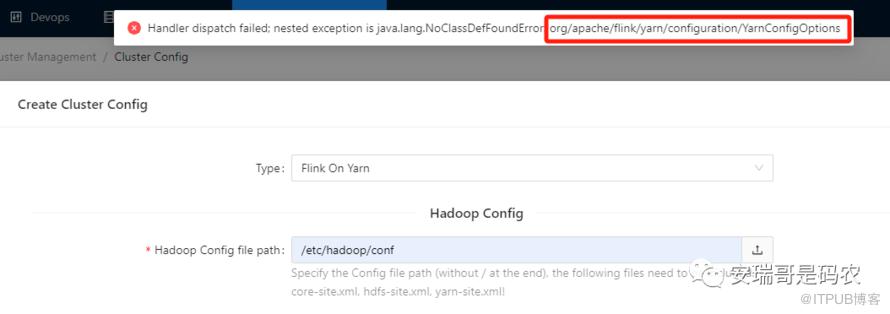
接下来,我开始添加 Flink on yarn 的配置,可是当我配置到这一步,涉及到 Hadoop 以及 Flink 的配置文件时(点击测试按钮),抛出了这个异常。
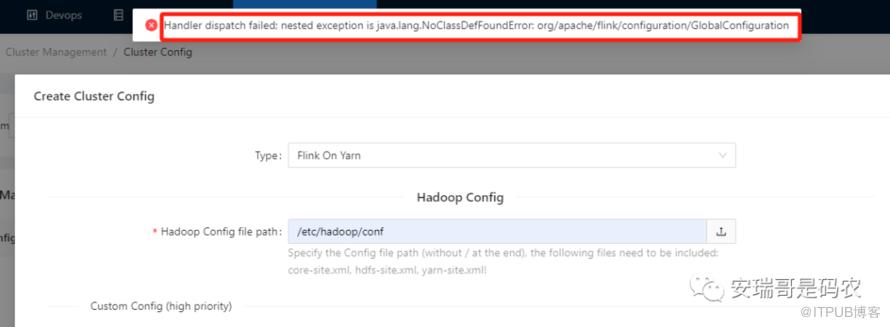
从报错来看,好像是缺包。
通过在中央仓库的查找发现,应该是缺少 flink-core 这个包导致,于是就把这个包下载下来,再次放到刚才那个plugins 目录下。
再次重启 Dinky 服务让其生效。
然后,再次回到这个配置页面,再点击右下角的 Test 按钮时发现,又出现了个新的报错:
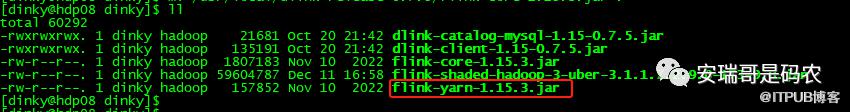
于是呢,用同样的办法找到了缺的包 flink-yarn,手动下载之后再次放到 plugins 目录下:
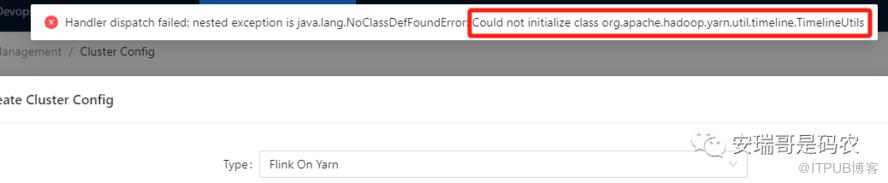
重复相同的操作,发现还是缺包:

最后,用类似的重复操作需要添加如下3个jar包:
javax.ws.rs-api-2.1.1.jar
jersey-common-2.38.jar
jersey-core-1.19.jar
这才让当前这个flink cluster 的配置正常(如果报错,无法保存),而这部分的具体解决办法,官网是缺失的,确实比较坑。
4. 添加Flink Cluster
这一步其实跟之前的 streampark 类似,我的本意是用来创建 yarn session 集群的。
但是,从这个创建时弹出的对话框,就让人有些迷惑:
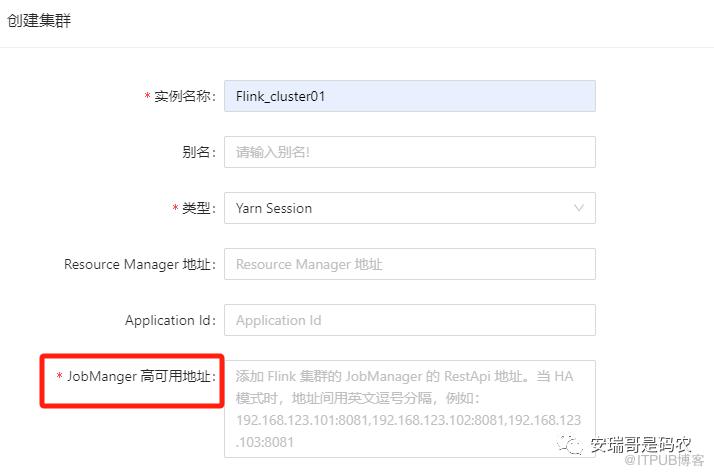
我创建 yarn session 的目的,不就是让你在yarn上给我启动一个 jobmanager 的吗?为毛要我现在指定呢?
就算我在 yarn 上面已经启动了 一个 yarn session,给你指定ResourceManager 以及对应的 Application ID 不就够了吗?为啥还必须要 JobManager 的地址(关键这个还是必填项)?
实在理解不了!
5. 流任务开发体验
根据文档的说明,照着写了个demo:
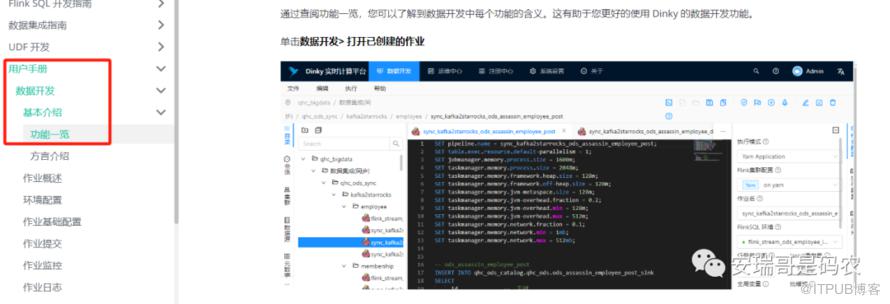
但是,除了local模式能运行外(暂时没有 standalone 的环境,所以没试)。
yarn 的集群方式提交,死活都不行。
yarn session模式,以及yarn application模式都试了,
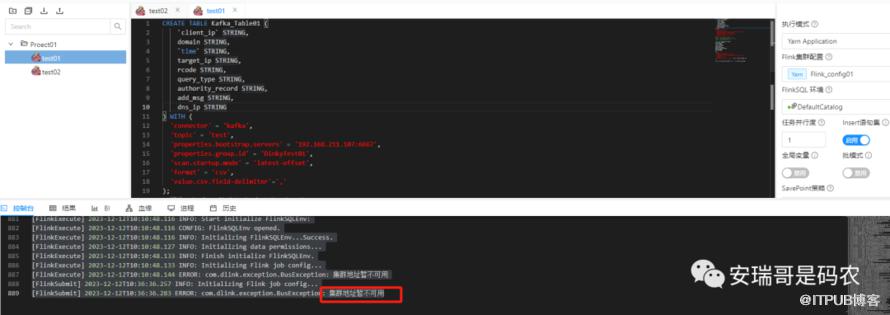
都告诉你集群地址不可用。
可我明明都配置了,关键也验证通过了呀。

就很离谱。
最后
一番折腾下来,对现有版本 Dinky 总的体验感受是:不好!
文档描述潦草,必要信息缺失,很多坑需要使用者自己根据运维和开发经验来填补。
期间有小伙伴私信我,说自己最近也在研究 Dinky,但是目前只跑通了 standalone 和 local 模式,希望我能分享 yarn 模式下的部署。
很遗憾,我也没搞定。
根据我的经验,无论是上次试用的 streampark 还是这次的 Dinky,作为一款「锦上添花」式的工具属性软件,如果做不到部署容易,使用简单,那么它存在的价值就不大。
毕竟,论开发,我们有如此强大的IDEA,论自动化,我们也有成熟的 CICD 体系,论监控,现有的监控手段简直不要太丰富。
想要在这个“高手如云”的市场分一杯羹,如果不能给用户超出预期的产品体验,恐怕很难得到青睐。
希望 Dinky 的1.0版本尽快推出,能弥补上面提到的那些不足。
原文作者:安瑞哥是码农;如有侵权,请联系管理员删除。

