继上次体验过 Hudi 之后,又一款所谓的数据湖产品引起了我的兴趣,它叫 Paimon。
跟 Hudi 主要面向 Spark 派系不同的是,Paimon 则主要面向 Flink,但是从这两者的官网描述来看,虽然面向的派系不一样,但对于这两款主流的计算引擎,也都是支持的。
从之前对 Hudi 的使用体验来看,个人的感觉一般,不觉得这玩意有多惊艳,尤其跟 Flink 配合使用的时候,遇到的坑着实有些多(对 Spark 确实要更友好一些),至少基于当时测试的版本,比较难说服我在生产上去使用它。
那么对于有着相同功能属性的 Paimon,它的表现如何呢,跟Hudi相比,有没有什么过人之处?
那么从这篇文章开始,咱就一起把它给“玩”起来看看。
特别说明:本文基于 Hadoop3.1、Flink1.15 进行体验。
0. 官网初体验
对于 Paimon 的介绍,这里就不多说了,跟 Hudi 是同一个性质的东西,这里还是贴出我之前为这种性质的技术给下的一个定义:
介于分布式文件系统与普通数据库之间的,同时继承了文件系统中数据对使用者直接可见的优点,以及数据库对数据的schema,metadata和事务管理能力的优点。
但同时,又摒弃了文件系统存储松散,数据库技术又过于厚重缺点的,这么一个数据管理中间件。
不一定完全对,但这就是我对这类软件使用后的直观感受,供你参考。
既然之前已经测试过 Hudi 了,那么这次再来使用 Paimon,会发现学习成本就低了不少。
Paimon 作为 Flink 的一个子项目,Flink 的官网早早就推出了中文页面,但是作为小老弟,在这一点上,它却没有紧跟它大哥的步伐,差!。

Flink官网提供的中文版页面

Paimon官网没有中文页面
另外,从官网开篇的演示 demo 来看,是要求你把 paimon 跟 flink 的联合 jar 包给放到 Flink (客户端)的 lib 目录下,然后通过启动 Flink 的 SQL client 来满足它的功能验证。
但是,对于一个正式的开发环境来说,显然不能这么来玩,咱用 IDEA 来构建开发环境才是主流。
1. 开发环境准备
跟 Hudi 一样,Paimon 作为一个数据写入(或读取)“插件”,想要使用它,最直接的方式,就是在你的开发环境的pom文件中引入。
虽然从官网提供的 jar 直接下载链接来看,该“插件”最新版本已经更新到了0.7。

但是,在maven中央仓库搜索关键字「paimon-flink-1.15」,却只能找到如下结果:
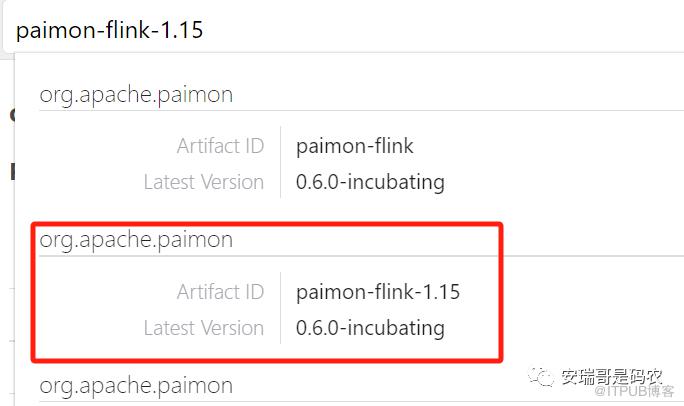
你会发现,通过中央仓库能够引入的最高版本,只到0.6,但是看更新日期,其实还挺新的:
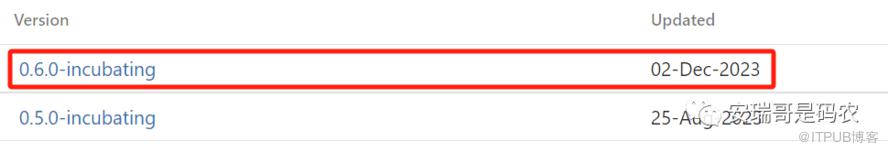
既然这样,就先凑合用吧。
于是,在我的 IDEA 中加入如下依赖:

从引入的依赖来看,你就知道这玩意现在还处在孵化阶段,所以得提前有心理准备。
2. 一个完整的案例
官网文档继续往后翻,你会找到2个用纯 Java 语言实现的,一个非Flink 框架的API,以及一个基于 Flink 框架的API。

通过对代码的观察对比,我会认为利用 Flink API 一定是使用 paimon 的主流。
我决定实现一个从 kafka 读取数据,然后写入到一个以 HDFS 为底座的 paimon 数据湖中。
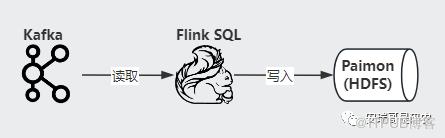
来,经过我奋战好几个小时之后,成功跑通的样例代码(附详细注释)如下:
package com.anryg.bigdata.paimon;


import org.apache.flink.api.common.eventtime.WatermarkStrategy;
import org.apache.flink.api.common.functions.FilterFunction;
import org.apache.flink.api.common.functions.MapFunction;
import org.apache.flink.api.common.serialization.SimpleStringSchema;
import org.apache.flink.api.common.typeinfo.Types;
import org.apache.flink.connector.kafka.source.KafkaSource;
import org.apache.flink.connector.kafka.source.KafkaSourceBuilder;
import org.apache.flink.connector.kafka.source.enumerator.initializer.OffsetsInitializer;
import org.apache.flink.streaming.api.CheckpointingMode;
import org.apache.flink.streaming.api.datastream.DataStreamSource;
import org.apache.flink.streaming.api.datastream.SingleOutputStreamOperator;
import org.apache.flink.streaming.api.environment.CheckpointConfig;
import org.apache.flink.streaming.api.environment.StreamExecutionEnvironment;
import org.apache.flink.table.api.Table;
import org.apache.flink.table.api.bridge.java.StreamTableEnvironment;
import org.apache.flink.types.Row;
import org.apache.flink.types.RowKind;

/**
 * @DESC: 通过 Flink DS 跟 SQL 混合模式读取 kafka 数据写入 Paimon 数据湖
 * @Auther: Anryg
 * @Date: 2023/12/19 20:36
 */
public class FlinkFromKafka2Paimon {

    public static void main(String[] args) {
        //获取流任务的环境变量
        StreamExecutionEnvironment env = StreamExecutionEnvironment.getExecutionEnvironment()
                .enableCheckpointing(10000, CheckpointingMode.EXACTLY_ONCE); //打开checkpoint功能
        //env.setRuntimeMode(RuntimeExecutionMode.BATCH)

        env.getCheckpointConfig().setCheckpointStorage("hdfs://192.168.211.106:8020/tmp/flink_checkpoint/FlinkDSFromKafka2Paimon"); //设置checkpoint的hdfs目录
        env.getCheckpointConfig().setExternalizedCheckpointCleanup(CheckpointConfig.ExternalizedCheckpointCleanup.RETAIN_ON_CANCELLATION); //设置checkpoint记录的保留策略

        /**创建flink table环境对象*/
        StreamTableEnvironment tableEnv = StreamTableEnvironment.create(env);

        /**添加 Kafka 数据源*/
        KafkaSourceBuilder<String> kafkaSourceBuilder = KafkaSource.<String>builder() //一定注意这里的<String>类型指定,否则后面的new SimpleStringSchema()会报错
                                                                    .setBootstrapServers("192.168.211.107:6667")
                                                                    .setTopics("test")
                                                                    .setGroupId("FlinkFromKafka2Paimon")
                                                                    .setStartingOffsets(OffsetsInitializer.earliest()) //确认消费模式为latest
                                                                    .setValueOnlyDeserializer(new SimpleStringSchema());


        /**将数据源生成DataStream对象*/
        DataStreamSource<String> kafkaDS = env.fromSource(kafkaSourceBuilder.build(), WatermarkStrategy.noWatermarks(), "kafka-data");

        /**将原始DS经过处理后,再添加schema*/
        SingleOutputStreamOperator<Row> targetDS = kafkaDS.map((MapFunction<String, String[]>) line -> {
                                                            String[] array = line.split("\\|");
                                                            return array;
                                                        }).filter((FilterFunction<String[]>) array -> {
                                                            if (array.length == 9) return true;
                                                            else return false;
                                                        }).map((MapFunction<String[], Row>) array -> Row.ofKind(RowKind.INSERT, array[0], array[1], array[2], array[3], array[4], array[5], array[6], array[7], array[8]))
                                                                .returns(
                                                                        Types.ROW_NAMED(
                                                                                new String[]{"client_ip", "domain", "time", "target_ip", "rcode", "query_type", "authority_record", "add_msg", "dns_ip"},
                                                                                Types.STRING, Types.STRING, Types.STRING, Types.STRING, Types.STRING, Types.STRING, Types.STRING, Types.STRING, Types.STRING)
                                                                );
        /**将目标DS转化成Table对象*/
        Table table = tableEnv.fromDataStream(targetDS);

        /**创建属于paimon类型的catalog*/
        tableEnv.executeSql("CREATE CATALOG hdfs_catalog WITH ('type' = 'paimon', 'warehouse' = 'hdfs://192.168.211.106:8020/tmp/paimon')");

        /**使用创建的catalog*/
        tableEnv.executeSql("USE CATALOG hdfs_catalog");

        /**建paimon表*/
        tableEnv.executeSql("CREATE TABLE if not exists data_from_flink2paimon (`client_ip` STRING ,domain STRING,`time` STRING,target_ip STRING,rcode STRING,query_type STRING,authority_record STRING,add_msg STRING,dns_ip STRING,PRIMARY KEY(client_ip,domain) NOT ENFORCED)");

        /**将 Kafka 数据源登记为当前catalog下的表*/
        tableEnv.createTemporaryView("kafka_table", table);

        /**将Kafka数据写入到 paimon 表中*/
        tableEnv.executeSql("INSERT INTO data_from_flink2paimon SELECT * FROM kafka_table");

    }
}
不知道看到完整代码后,你有没有感到一丝好奇,那就是为啥这次我一反常态,是用的 Java 语言来写的,而不是语句更简洁的 Scala ?
来,告诉你原因。
3. 几个让你难受的地方
虽然在我看来,本来挺简单的一个需求,但想要把整个代码逻辑跑通,其实并非易事,接下来就告诉你,这过程我遇到了哪些让人坑爹和难受的经历。
3.1 难受一
其实官方文档已经做了说明,那就是想要实现通过 Flink 操作 Paimon,既不能用纯粹的 DataStream API,也不能用 SQL API,而是需要这两者「混用」。

官网对这两者需要混用的说明
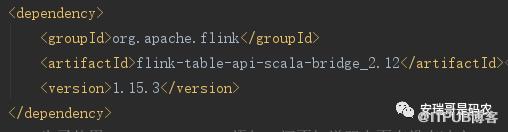
这也是为什么,在你开发环境的 pom 文件中,除了要引入必要的flink-paimon 联合jar包外,还需要额外加入下面这个依赖的原因(两者选其一即可,但只有前者才能让你跑通):

基于 Java api 的两者互转依赖
基于 Scala api 的两者互转依赖
这样一来,写出来的代码就会风格不统一,导致缺乏美感,不喜欢。
3.2 坑二
之所以用 Java API 来实现上面的代码,是因为不能用 Scala,相同的代码,如果用 Scala 来实现,个别关键函数会缺失,导致程序运行失败。
具体是哪个函数呢?看这里:
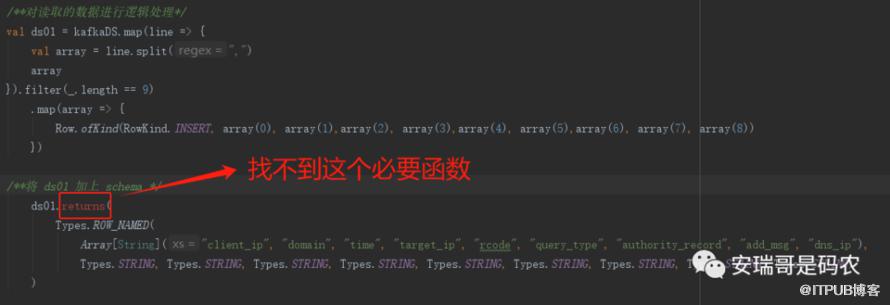
基于 Scala api 实现的代码
就是这个坑爹、但同时又是必须的 returns 函数在Scala API 里面没有。
按常理来说,这个用来设置 DataSream schema 的函数找不到就找不到吧,咱用另一种设置 schema 的方法是不是应该也可行,刚好官网示例中就提供了2种添加schema的方法:
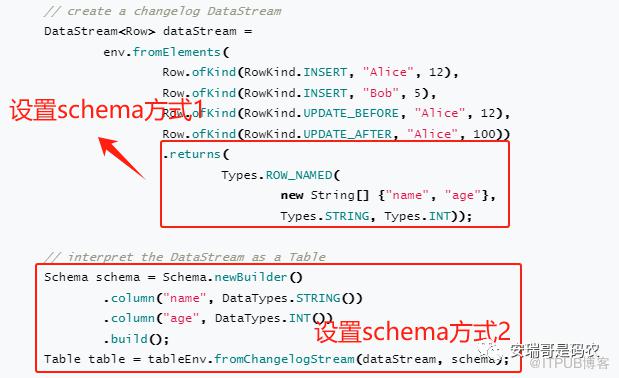
官网提供的2种设置schema方式
既然用 Scala API,用方式1设置 schema 的方式行不通(没有那个函数),那咱用方式2是不是应该也可以。
诶... 它偏不,你要是不服的话,把方式1的设置方式略去,只用方式2来设置,就会给你抛出下面的异常:
Exception in thread "main" org.apache.flink.table.api.ValidationException: Unable to find a field named 'client_ip' in the physical data type derived from the given type information for schema declaration. Make sure that the type information is not a generic raw type. Currently available fields are: [f0]
 at org.apache.flink.table.catalog.SchemaTranslator.patchDataTypeFromColumn(SchemaTranslator.java:350)
 at org.apache.flink.table.catalog.SchemaTranslator.patchDataTypeFromDeclaredSchema(SchemaTranslator.java:337)
 at org.apache.flink.table.catalog.SchemaTranslator.createConsumingResult(SchemaTranslator.java:235)
 at org.apache.flink.table.catalog.SchemaTranslator.createConsumingResult(SchemaTranslator.java:180)
 at org.apache.flink.table.api.bridge.internal.AbstractStreamTableEnvironmentImpl.fromStreamInternal(AbstractStreamTableEnvironmentImpl.java:140)
 at org.apache.flink.table.api.bridge.scala.internal.StreamTableEnvironmentImpl.fromChangelogStream(StreamTableEnvironmentImpl.scala:92)
 at com.anryg.paimon.FlinkDSFromKafka2Paimon$.main(FlinkDSFromKafka2Paimon.scala:86)
 at com.anryg.paimon.FlinkDSFromKafka2Paimon.main(FlinkDSFromKafka2Paimon.scala)
所以通过实践来证明,方式1必须设置,而方式2则可有可无。
我是觉得,这种傻缺的设计,很能暴露设计者的水平。
3.3 不严谨三
官网给的样例中,说可以通过 pom 文件引入最新的0.7版本:
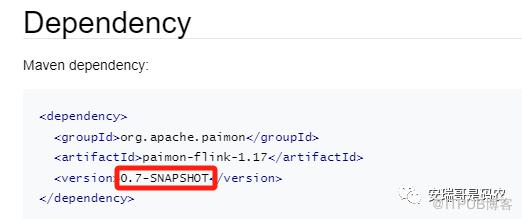
但其实,你在Maven的中央仓库是找不到的,人家最多只有0.6的:
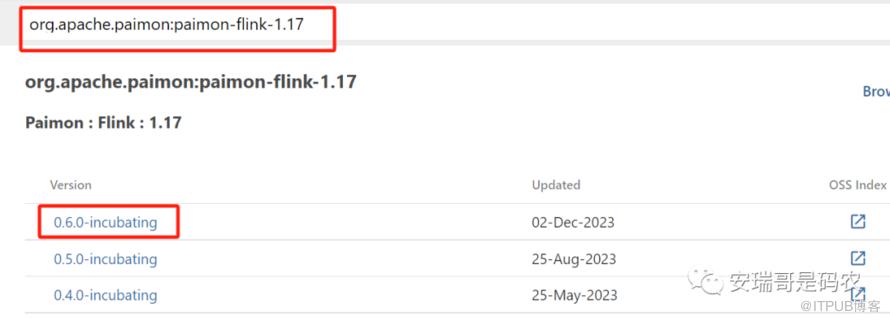
当然,我的Flink 1.15 也只能找到0.6的最高版。
所以,不严谨。
4. 运行状态
在解决了上面那些问题之后,程序就能顺利跑起来了,运行了大概十几个小时,因为上游数据推的比较慢,大概写入了几百万条数据,目前来看还算稳定,没出幺蛾子。
从数据写入 HDFS 的文件数量来看,可能因为上游数据流量不大,所以可以看到很多碎文件。
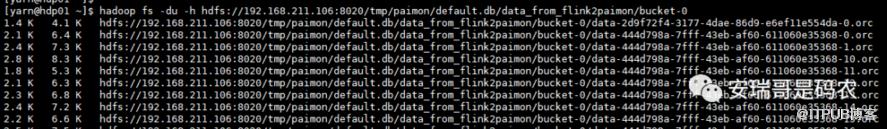
大概观察了一下,经过这么长时间的写入,小文件数量会维持在大概600个左右就不会往上增加太多了(默认设置下),这个合并功能跟 Hudi 是一样的。
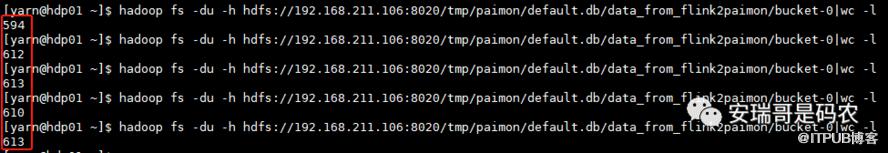
只不过,同样场景的写入,Hudi 的小文件上限好像是100左右。
最后
虽然只是初次体验,但是对 Paimon 的玩法算是有了个基础的认知,跟之前的hudi相比,首先在上手难度上,体验要比 Hudi 差一点,限制有点多。
其次,在使用时,因为涉及到需要对 catalog 进行管理,所以我会先入为主的认为,它的难度可能也要更大一点,当然,这一点还需要后续的实践来进一步验证。
最后,相比Hudi,它还有一个我认为的优点,那就是在开发环境里,不再跟Hive相关的包发生冲突(之前在 Flink 的开发环境里,hive跟Hudi不能共存),两个组件可以和平相处。
欲知 Paimon 的后续使用进展,咱下一篇继续...
相关推荐阅读:

原文作者:安瑞哥是码农;如有侵权,请联系管理员删除。

