在之前的历史文章中,分别测试和体验了 Hudi 跟 Paimon 的一些常规用法。
就在上周,星球的一位球友向我呼吁,说能不能也测试一下咱们国产的数据湖产品,我问叫啥啊,他说:LakeSoul。
然后又告诉我,这是他们公司推出的,最近开源的一款产品,(据说)老牛逼了,让我这个「中立的第三方」来一探虚实,看这里面到底有没有水分。
光从名字上来判断呢,咋一看,确实还挺唬人的,毕竟,在我的刻板印象里,一般敢跟「soul」这个词扯上关系的,都不怎么简单。
怀着既期待,又充满狐疑的心态,今天,咱就正式开启对这款国产数据湖的测试之旅。
PS:本文将以 Spark3.2 读取 Kafka2.0 数据写 LakeSoul2.4 为例作为说明。
0. 初识真面目
正因为是纯国产软件,所以跟它相关的文档资料,都能找到全中文的,对于这款软件的启蒙入口,我是从这里开始的:
https://gitee.com/meta-soul/LakeSoul
这里有对 LakeSoul 基础的一些介绍,以及使用文档的跳转连接:
跳转到它的正式官方使用说明文档之后,第一感觉就是,内容还不少,尤其是提供的示例代码很多。
但是呢,在描述上,从我的角度来看,有点抓不住重点,比如这款数据湖软件最大的特点就是,相比之前测试过的Hudi 跟 Paimon,它多了个元数据管理。
而且这个元数据管理的工具,从文档的描述来看,只能是 postgresql 数据库,关键对于这一点,文档在描述上很明显没有着重突出,这会让我一个习惯了 Hudi 跟 Paimon 玩法的人,一下子有些不适应 。
然后就是,对于它提供的各个 demo,想要把它们顺利跑起来,你得有一定的辨别和思考定力,知道一套完整的代码需要具备哪些必要环境依赖,否则很容易让你懵逼。
1. 开发环境准备
1.1 部署元数据管理数据库
对于这一点,可能要颠覆以往数据湖只是作为计算引擎“插件”的使用习惯,因为如果你想要让 Spark 顺利把数据写入 LakeSoul,必须提前准备好它的元数据管理。
而且,从官网来看,这个用来做元数据管理的数据库,必须得是 PostgreSQL 才行。
对于这部分,官网给的示例是通过 docker 的方式来部署:
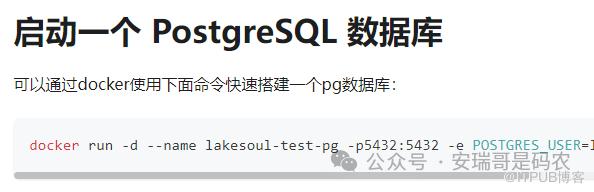
因为只是用来存储元数据,所以即便是生产环境,用 docker 的方式问题也不大,咱也跟它一样。
只不过在对其进行初始化的时候(创建一系列跟LakeSoul相关的基础表),在执行下面这个命令的时候,需要注意几个地方:
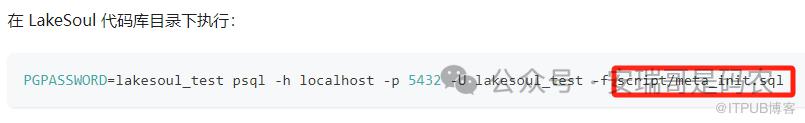
1. 官网中描述的,所谓的代码库目录,其实指的是 LakeSoul 的 GitHub(或者gitgee)软件项目,而这个命令其中需要用到的 SQL 文件,指的是这个:

所以,只需要把这个文件下载下到运行 docker 的那台服务器就可以了;
2. 对于这个命令中的 psql,需要下载 PostgreSQL 客户端,而且,注意客户端的版本必须在10以上才可以,否则会抛出下面的异常。

1.2 代码环境准备
跟之前对待 Hudi 和 Paimon 一样,想要把这个 LakeSoul 在开发环境玩起来,咱就得先准备好必要的 IDEA 依赖。
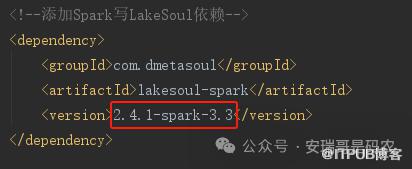
从 maven 中央仓库能查到的,对 Spark 版本的支持着实有点少,关键它支持完spark3.1之后,居然直接跳过了3.2,转而投进了 spark 3.3 的怀抱,这多少让我有点不开心。
因为我当前环境的 spark 版本,就是3.2的。
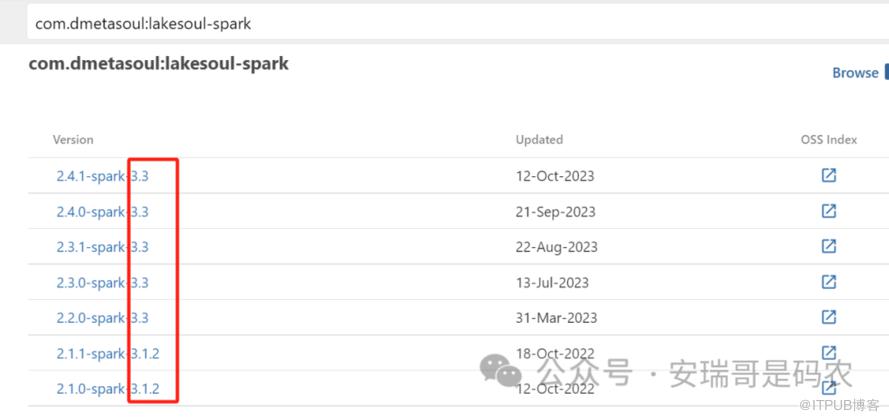
但好在版本之间差距并不大,根据我这些年的趟坑经验,一般来说用高一点的版本基本不会有问题。
于是,我在 IDEA 的软件工程中引入了这个:
2. 开始编码
把以上2步准备工作做好之后,对于Spark 写 LakeSoul 就比较容易了。
但是这里的容易,从我的体验来看,只能说是从代码的简洁程度来而言,因为其实想把这个完整的程序调通,并不太容易。
老规矩,先贴出我经过了一番呕心沥血的调试之后,跑通的代码:
package com.anryg.bigdata.streaming.lakesoul

import com.alibaba.fastjson.JSON
import com.dmetasoul.lakesoul.tables.LakeSoulTable
import org.apache.spark.SparkConf
import org.apache.spark.sql.{DataFrame, SparkSession}
import org.apache.spark.sql.streaming.OutputMode

/**
  * @DESC: 通过Spark Structured streaming 读取 Kafka 写LakeSoul
  * @Auther: Anryg
  * @Date: 2024/1/5 10:39
  */
object SparkReadKafka2LakeSoul {

    def main(args: Array[String]): Unit = {
        val conf = new SparkConf().setAppName("SparkReadKafka2LakeSoul")/*.setMaster("local[1]")*/
        conf.set("spark.sql.catalog.lakesoul", "org.apache.spark.sql.lakesoul.catalog.LakeSoulCatalog") //指定catalog为LakeSoul
        conf.set("spark.sql.extensions", "com.dmetasoul.lakesoul.sql.LakeSoulSparkSessionExtension")
        conf.set("spark.sql.defaultCatalog", "lakesoul")
        /**设置跟PG元数据相关的配置*/
        System.setProperty("lakesoul.pg.driver","com.lakesoul.shaded.org.postgresql.Driver")
        System.setProperty("lakesoul.pg.url","jdbc:postgresql://192.168.221.173:5432/lakesoul_test?stringtype=unspecified")
        System.setProperty("lakesoul.pg.username","lakesoul_test")
        System.setProperty("lakesoul.pg.password","lakesoul_test")

        val spark = SparkSession.builder().config(conf).getOrCreate()

        /**读取Kafka数据源*/
        val rawDF = spark.readStream
            .format("kafka")
            .option("kafka.bootstrap.servers", "192.168.211.107:6667")
            .option("subscribe", "test")
            .option("failOnDataLoss",false)
            .option("fetchOffset.numRetries",3)
            .option("startingOffsets","latest")
            .load()

        import spark.implicits._

        val ds = rawDF.selectExpr("CAST(value AS STRING)")
            .map(row => {
                val line = row.getAs[String]("value")
                val rawJson = JSON.parseObject(line)      //原始string是一个json,对其进行解析
                val message = rawJson.getString("message")  //获取业务数据部分
                val fieldArray = message.split(",")
                fieldArray
            }).filter(_.length == 9).map(array =>(array(0),array(1),array(2),array(3),array(4),array(5),array(6),array(7),array(8)))
            .toDF("client_ip","domain","time","target_ip","rcode","query_type","authority_record","add_msg","dns_ip")

        /**下面这种小文件太多,而且貌似分区没有起作用*/
        ds.writeStream
            .outputMode(OutputMode.Append())
            .format("lakesoul")
            .option("hashPartitions","client_ip") //设置了这个,下面的hashBucketNum也必须同时设置
            .option("hashBucketNum","10")
            .option("checkpointLocation", "hdfs://192.168.211.106:8020/tmp/offset/test/SparkReadKafka2LakeSoul02")
            .start("hdfs://192.168.211.106:8020/tmp/lakesoul/data_from_kafka2lakesoul02")
            .awaitTermination()
    }
}
这里面有几个需要注意的地方。
注意点1:
前面的准备工作说了,这个 LakeSoul 的玩法,需要我们先创建它的元数据管理,为此,我们需要启动一个PG数据库,那上面的代码在运行中怎么跟这个元数据进行交换呢?
官网是这么教你的:
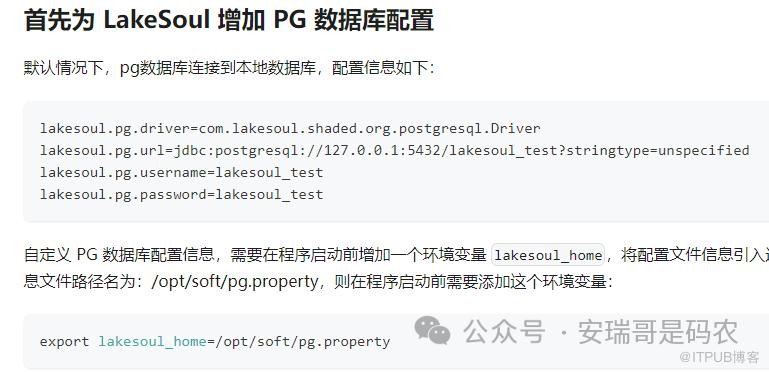
意思是要你把跟这个 PG 相关的连接信息,给写入到一个 spark 客户端服务器的配置文件里(新增一个),然后添加一个新的环境变量 lakesoul_home 指向它,后续程序启动,就能读到这个配置,从而跟PG 建立元数据交互。
但这种方式在我看来有些「不体面」,于是呢,我直接把它配置在了代码的系统环境变量里:

注意点2:
官方文档其实给了几种 spark 流式写 LakeSoul 的 API,但是呢,下面这种我是调试不通的:
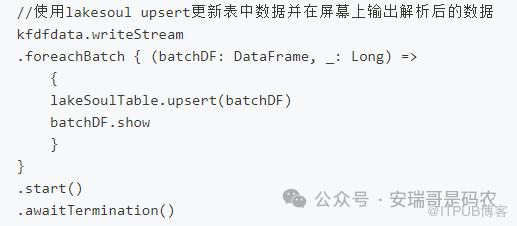
至于它抛出的异常,这里就不贴出来了,看的我是直发懵。
3. 几个槽点
3.1 槽点1
不能在IDEA直接调试运行,这个在我看来是很操蛋的。
对于一个程序员来说,如果我刚写好的一手代码,不能在开发工具上直接见证它成功运行的「处女秀」,着实会让人有些难受,至少对于我来说会这样。
给你看看,当我点击运行按钮时,它给我抛了个什么鬼:

就这种摸不着头脑的 Error,你连 debug 都不知道从哪下嘴。
「找不到指定路径」,那你倒是告诉我你要的路径是啥啊?
可它就不。
但好在咱也算「身经百战」,虽然错误提示如此「含糊其辞」,但大概率是环境问题导致,既然这样,那就换一个呗。
于是,我直接将项目打包给提交到集群,你猜怎么着?它又行了。
3.2 槽点2
写入 LakeSoul 表的数据文件太碎,默认貌似没有合并功能。
上面代码虽然在 IDEA 本地无法调试,但提交到 yarn 集群之后能很顺畅的跑起来。
只是,跑出来的结果,让我不太省心,在没有添加任何额外合并配置的情况下,LakeSoul 貌似不会自己做文件合并,这在我看来多少有点坑爹。

同样的数据量,我测试过 Hudi 跟 Paimon,文件数量最多也就几百个之众,没有这么夸张的。
3.3 槽点3
分区设置没有生效,这个也是我认为体验不好的。
就是你明明在代码中指定了分区规则:
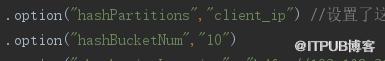
但是呢,hdfs文件系统上的目录结构却是这样的:

根本看不到分区之后的效果在哪,要知道,对比不分区,它们之间的这个目录结构居然是一毛一样的。
有没有可能是我用的不对?我希望是。
最后
从这次对咱们的这款国产数据湖软件 LakeSoul 的体验来看,只能算是「匆匆一瞥」,在其易用性这个层面,有一定的体会。
相比之前测试过的 Hudi 跟 Paimon,单纯从上手难度来看,不如它俩。
至于说它的优点,目前从能体验到的部分来看,虽然没有实测,其写入速度确实还挺快的(目测比前两个都快),但带来的后果就是大量的碎文件。
其他就不多说了,希望 LakeSoul 后续能再接再厉,加油!
原文作者:安瑞哥是码农;如有侵权,请联系管理员删除。

