上篇文章写了我对 Celeborn 的初体验,从它的官网内容、基础服务部署、开发环境准备,这3个维度进行了比较细致的体验和描述。
从前期的体验来看,部署跟开发环境的准备也都还比较顺利,但是对于它最重要的功能——shuffle 计算的优化(提速),由于篇幅关系,在上文中并未得到体现(本地模式运行的程序没啥说服力)。
那么今天这篇内容,咱就专门针对 Celeborn 是否能对 Spark 任务的 shuffle 有优化提速的效果,开展一番「正儿八经」、「轰轰烈烈」的对比测试(Spark on yarn、大数据量、多场景),看这款工具是否值得大家一用。
PS:本文以 hadoop 3.1 + spark 3.2 + Celeborn0.32-incubating 进行测试验证。
0. 测前准备
就在上篇文章发出不久,一个星球球友就找到我,问:能不能在你正经测试的时候,数据量搞大一点?比如50T啥的,没有的话,我可以借你。
听这话,感觉有点瞧不起我呢,赶紧告诉他,咱可是屯了上PB级别的数据量哟,而且都是生产级的真实数据呢。
所以数据量在我这里,从来都不是问题,问题在于如何设计这个测试场景,让它更贴合大多数人在实际工作中的场景要求。
基于这次测试对比,我准备设计「2个定量」跟「2个变量」:
定量1:基于 Spark batch 计算框架,且用 Spark on yarn 模式运行;
定量2:都是基于hadoop3.1、以及3个计算节点来展开,对比组之间,用同样的并行度,同样的内存和CPU配比,公平得厉害;
变量1:单次计算的数据量会逐步递增,但是也不会大到离谱,毕竟我的测试集群计算能力有限,而且其实大部分同学的所谓大数据项目,单个任务也没有几个能达到离谱的数据量,咱就不装那个逼了,控制在 GB 量级即可;
变量2:会采用几个不同的业务计算 SQL 来达到不同计算场景的目的,毕竟理论上,不同的 SQL 语句,会带来不同的 shuffle 过程,而不同的 shuffle 过程,势必就会带来不同的计算效率影响。
至于程序的设计方式,很简单,因为我们的核心是为了测试出 Celeborn 对 shuffle 的影响。
那么一切跟它无关的设计就都不需要,比如 SQL 的计算结果不需要入库,直接打印出来就好了,处理流程拉的越长,理论上对结果的干扰就会越大。
具体的代码在上一篇文章中已经给出,有兴趣的同学可自行查看。
1. 正片开始
PS:为了减少比如网络动荡、集群负载不稳定带来的影响,每个场景下的对比,都执行2次,最后取平均值算成绩。
1.1 基于 SQL01 情况下
SELECT
    target_ip,
    lower(domain) AS lower_domain,
    count(target_ip,lower(domain)) as count
FROM t
where
target_ip != null or target_ip != ''
GROUP BY
    target_ip,
    lower_domain
ORDER BY
    count DESC
LIMIT 100
1.1.1 3G数据量时
第1次测试结论:
不利用 Celeborn 情况下,耗时:58秒
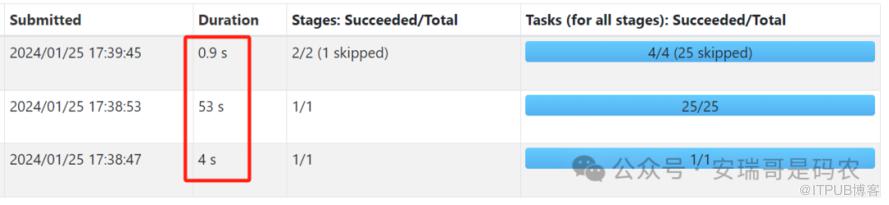
利用 Celeborn 情况下,耗时:46秒
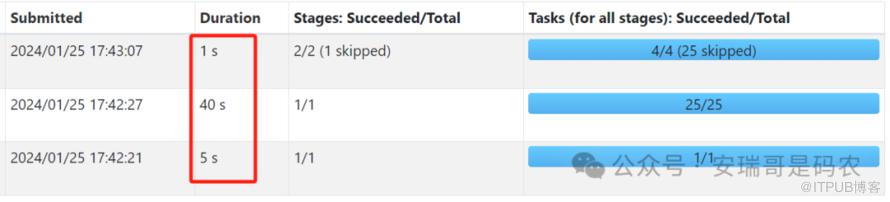
第2次测试结论:
不利用 Celeborn 情况下,耗时:52秒
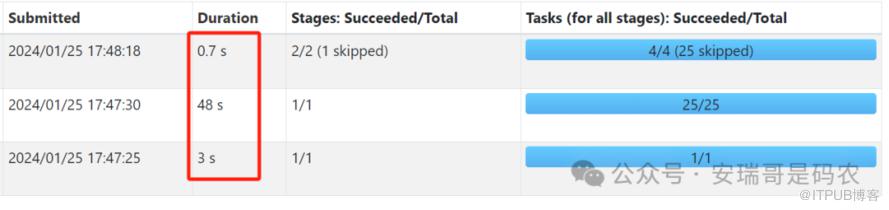
利用 Celeborn 情况下,耗时:44秒
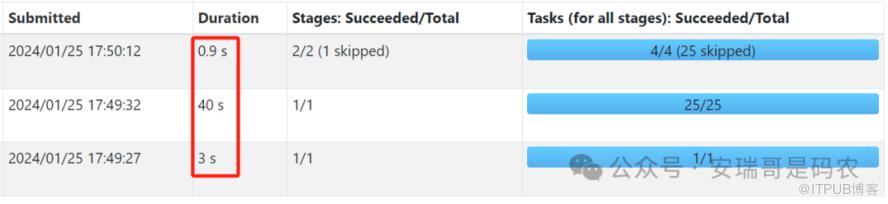
小结:利用 Celeborn 后,执行效率提高8秒。
1.1.2 11.1G 数据量时
第1次测试结论:
不利用 Celeborn 情况下,耗时:142秒。

利用 Celeborn 情况下,耗时:142秒
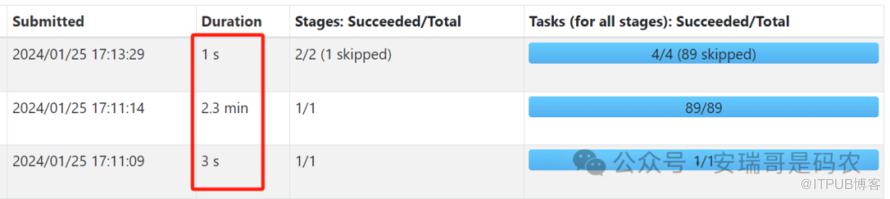
第2次测试结论:
不利用 Celeborn 情况下,耗时:174秒。
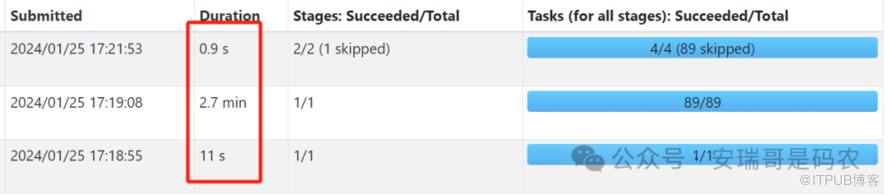
利用 Celeborn 情况下,耗时:109秒。

小结:利用 Celeborn 后,执行效率提高33秒。
1.1.3 88G 数据量时
第1次测试结果:
不利用 Celeborn 情况下,耗时:16分32秒
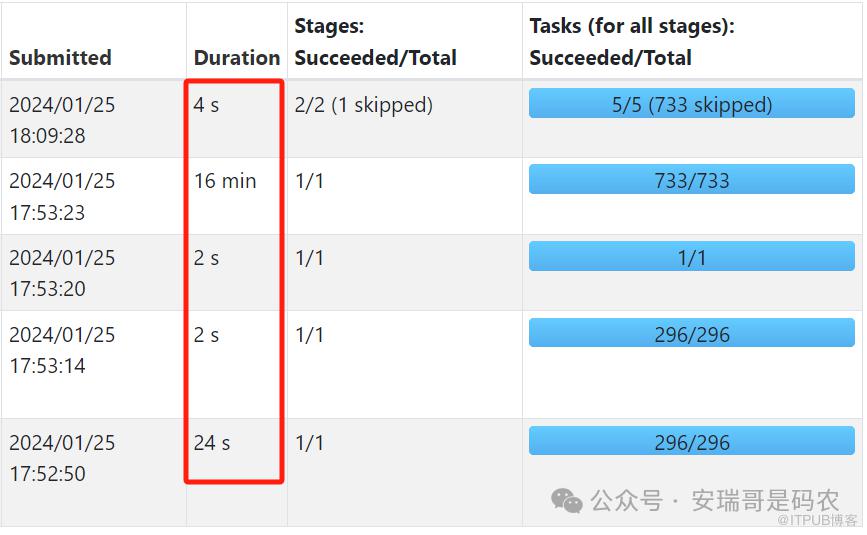
利用 Celeborn 情况下,耗时:14分14秒
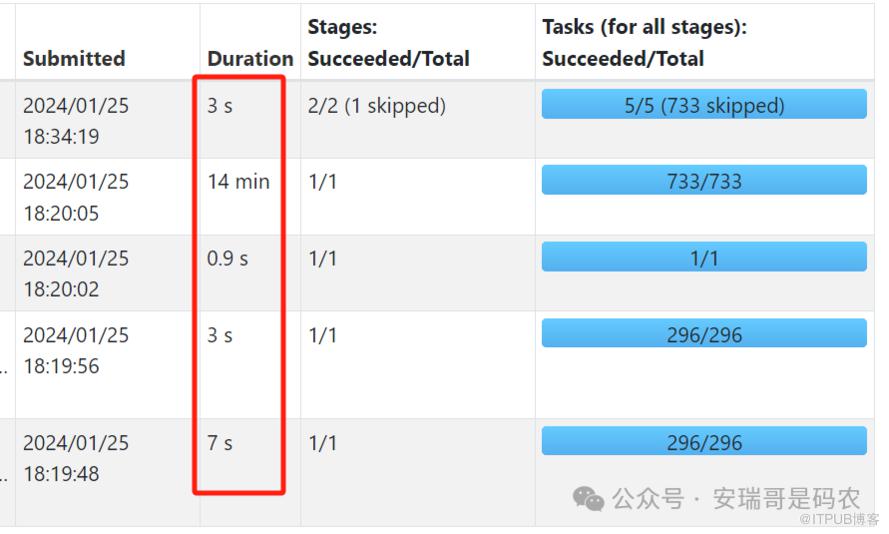
第2次测试结果:
不利用 Celeborn 情况下,耗时:16分16秒
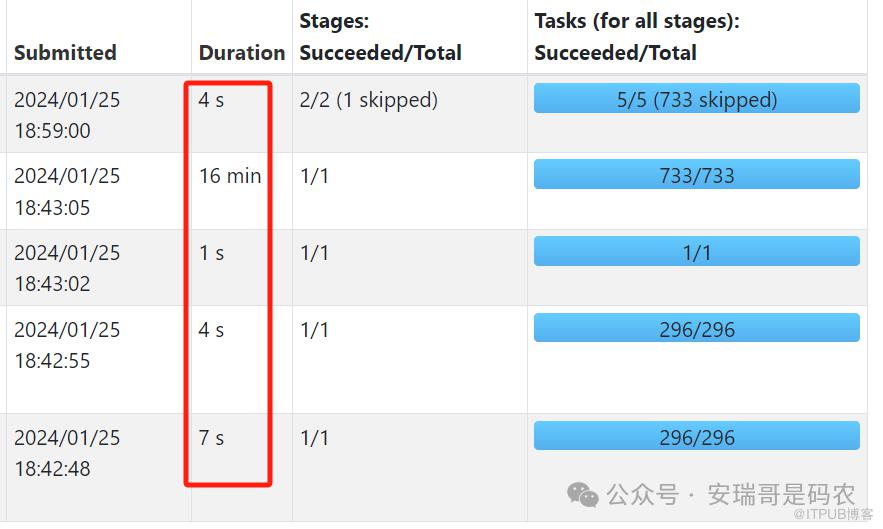
利用 Celeborn 情况下,耗时:14分52秒
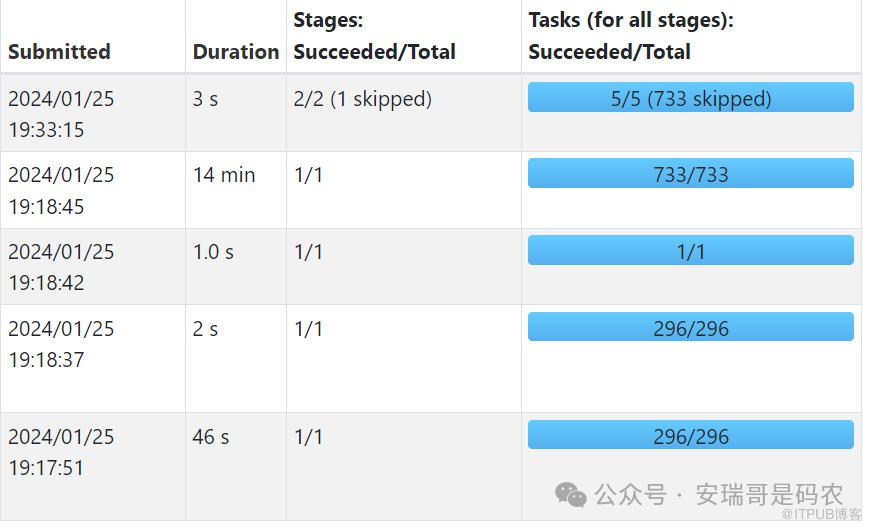
小结:利用 Celeborn 后,执行效率提高84秒。
1.1.4 1017.3G 数据量时
第1次测试结论:
不利用 Celeborn 情况下,耗时:1小时7分05秒
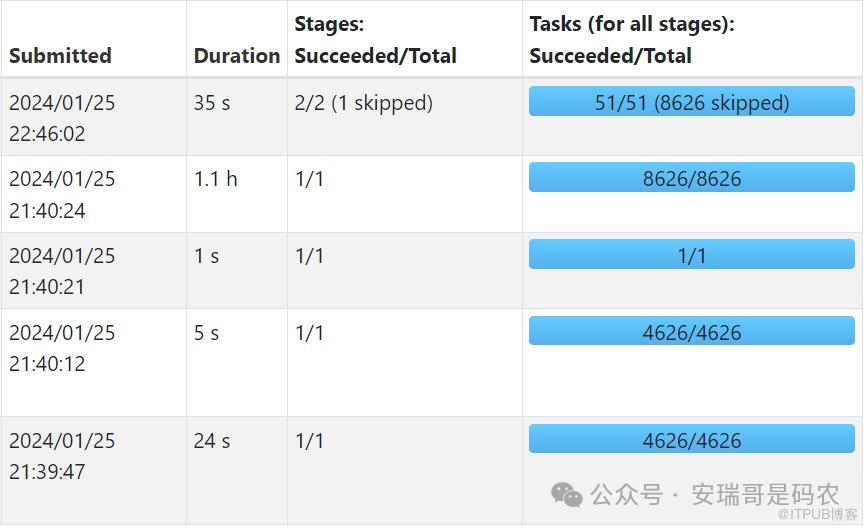
利用 Celeborn 情况下,耗时:54分33秒

第2次测试结论:
不利用 Celeborn 情况下,耗时:44分41秒
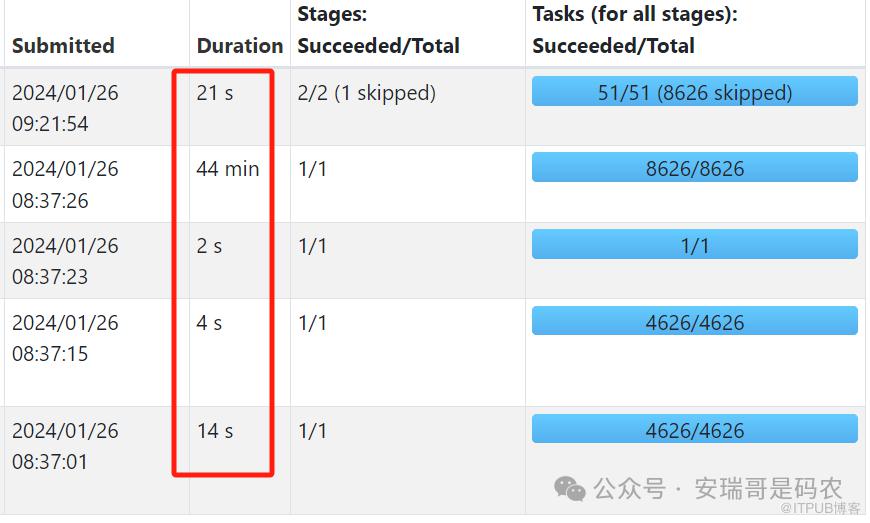
利用 Celeborn 情况下,耗时:56分40秒
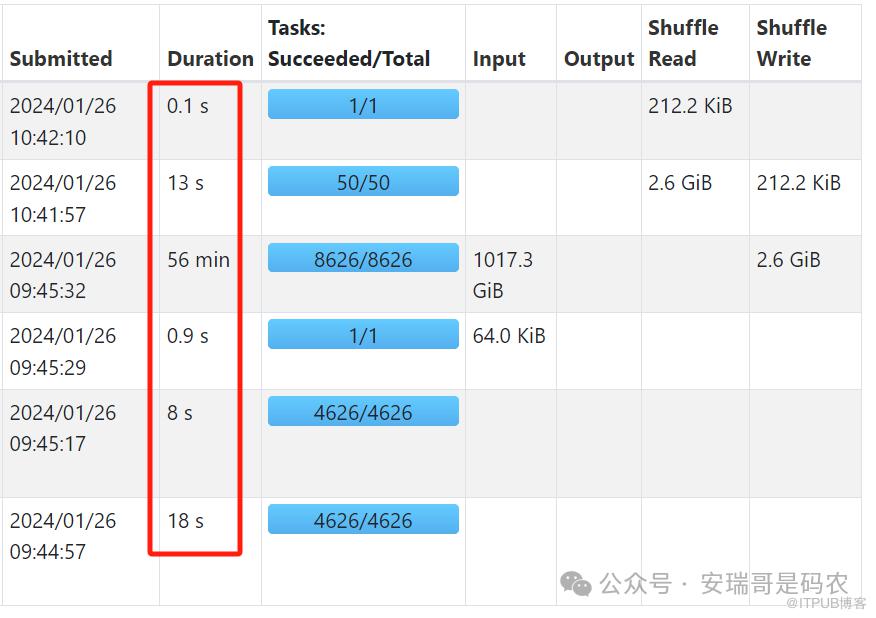
小结:利用 Celeborn 后,执行效率几乎打平。
1.2 基于 SQL02 情况下
select
client_ip,
max(row_num2) as max
from
(
select
client_ip,
row_num2,
date_min
from
(
select
client_ip,
sub_date,
row_number() over (partition by client_ip,sub_date order by client_ip,sub_date) as row_num2,
date_min
from
(
select
client_ip,
date_min,
row_number() over (partition by client_ip order by date_min) as row_num,
try_add(cast(date_min as long), row_num) as sub_date
from
(
select
client_ip,
substring(time,0,12) AS date_min,
row_number() over (partition by client_ip,substring(time,0,12) order by substring(time,0,12)) as row_num
from
t
where
length(time)=14
) A
where A.row_num=1
) B
) C
)D
group by
D.client_ip
order by max desc
limit 100;
1.2.1 3G数据量时
第1次测试结论:
不利用 Celeborn 情况下,耗时:2分59秒
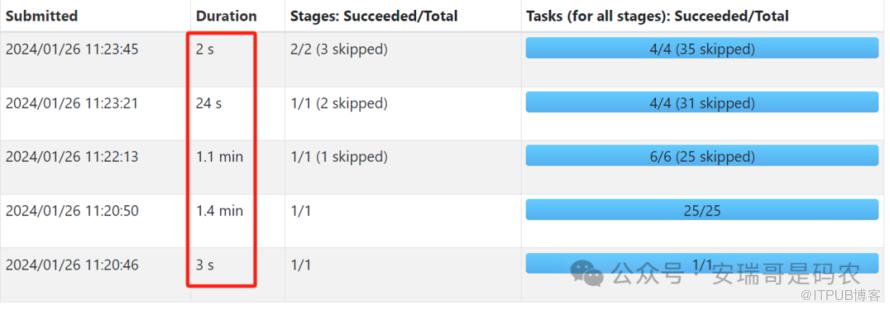
利用 Celeborn 情况下,耗时:1分28秒
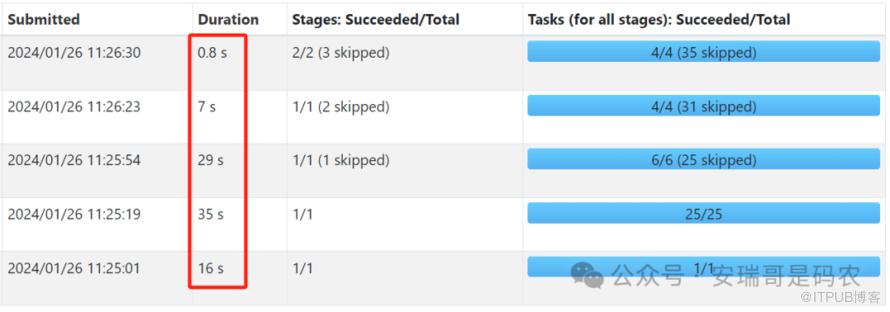
第2次测试结论:
不利用 Celeborn 情况下,耗时:1分36秒
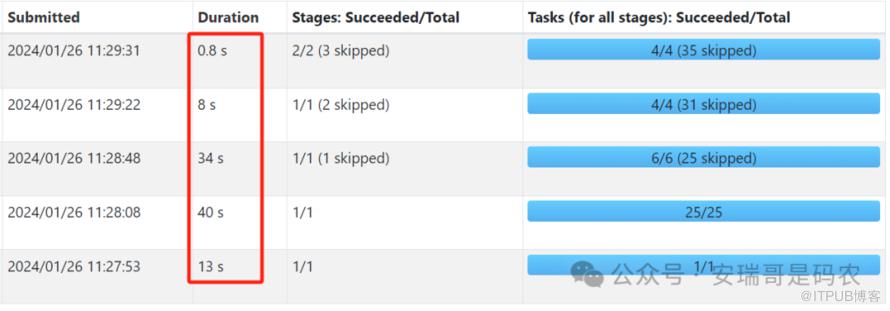
利用 Celeborn 情况下,耗时:1分21秒

小结:利用 Celeborn 后,执行效率提高53秒。
1.2.2 11.1G数据量时
第1次测试结论:
不利用 Celeborn 情况下,耗时:4分26秒

利用 Celeborn 情况下,耗时:3分55秒

第2次测试结论:
不利用 Celeborn 情况下,耗时:4分01秒

利用 Celeborn 情况下,耗时:4分23秒

小结:利用 Celeborn 后,执行效率提高4秒。
1.2.3 88G数据量时
第1次测试结论:
不利用 Celeborn 情况下,耗时:31分钟
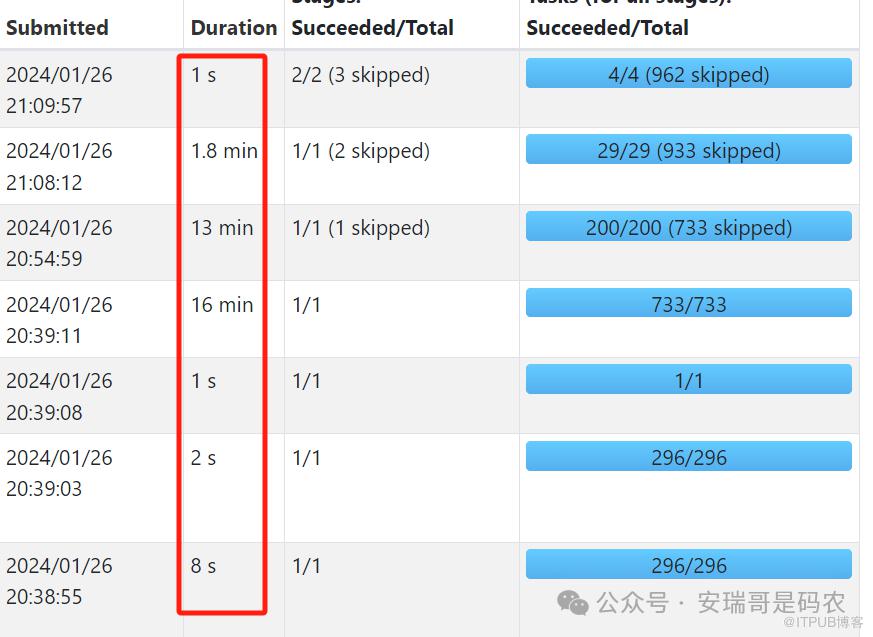
利用 Celeborn 情况下,耗时:29分52秒
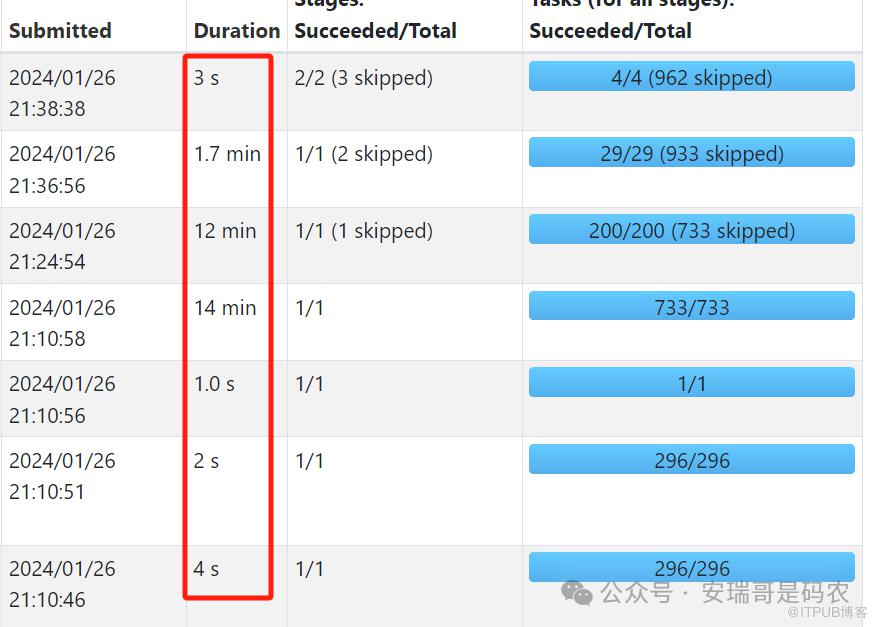
第2次测试结论:
不利用 Celeborn 情况下,耗时:34分15秒
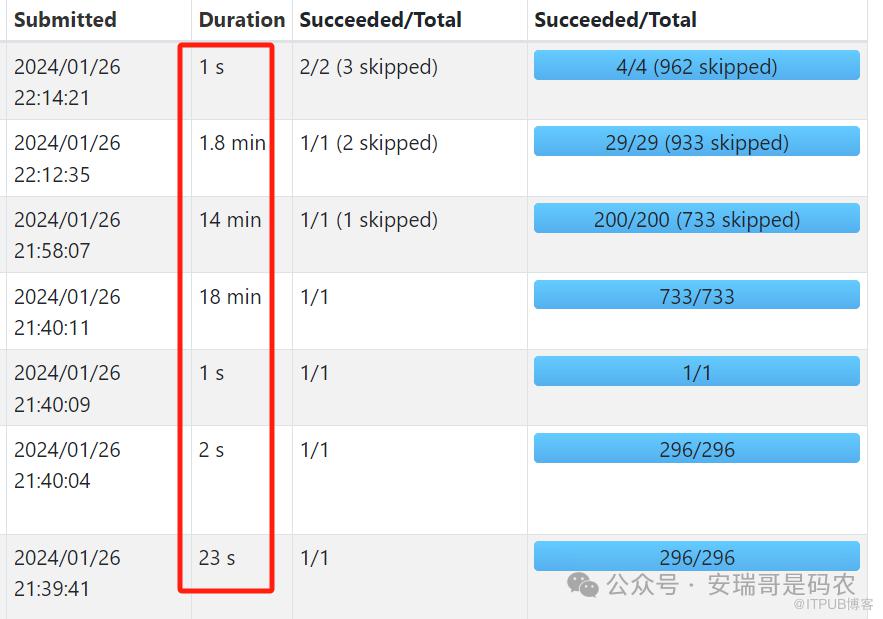
利用 Celeborn 情况下,耗时:29分04秒。
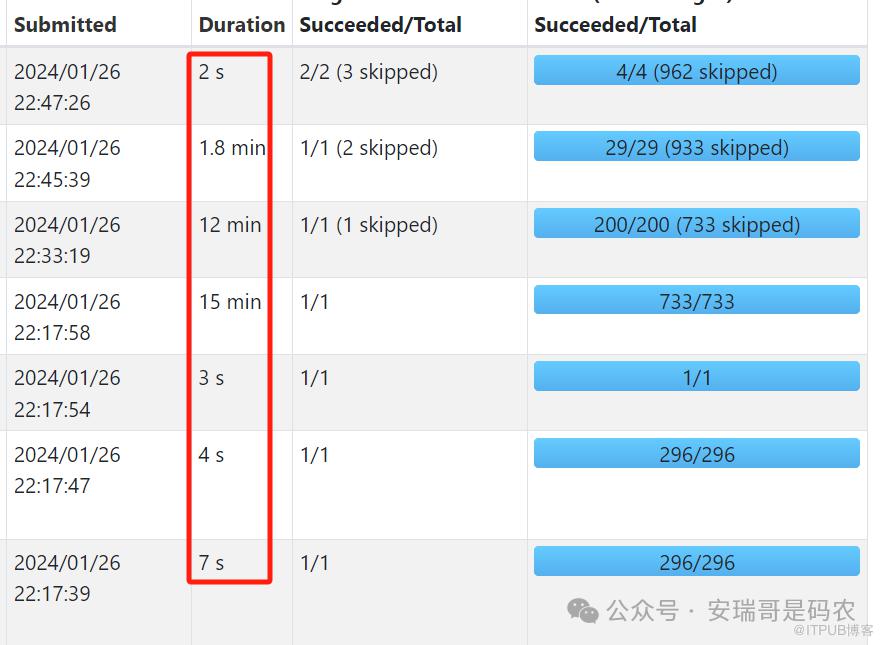
小结:利用 Celeborn 后,执行效率提高3分10秒。
1.2.4 1107.1G数据量时
第1次测试结论:
不利用 Celeborn 情况下,耗时:Null
为啥?因为我跑了3次,都跑失败了,前两次是数据块异常导致的,而这一次又是因为下面这个连接原因:
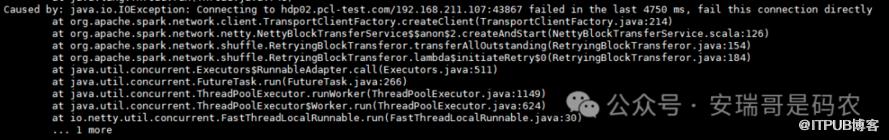
但是,开启了 Celeborn 之后,就这个问题就没有了,好评!
利用 Celeborn 情况下,耗时:1小时34分30秒
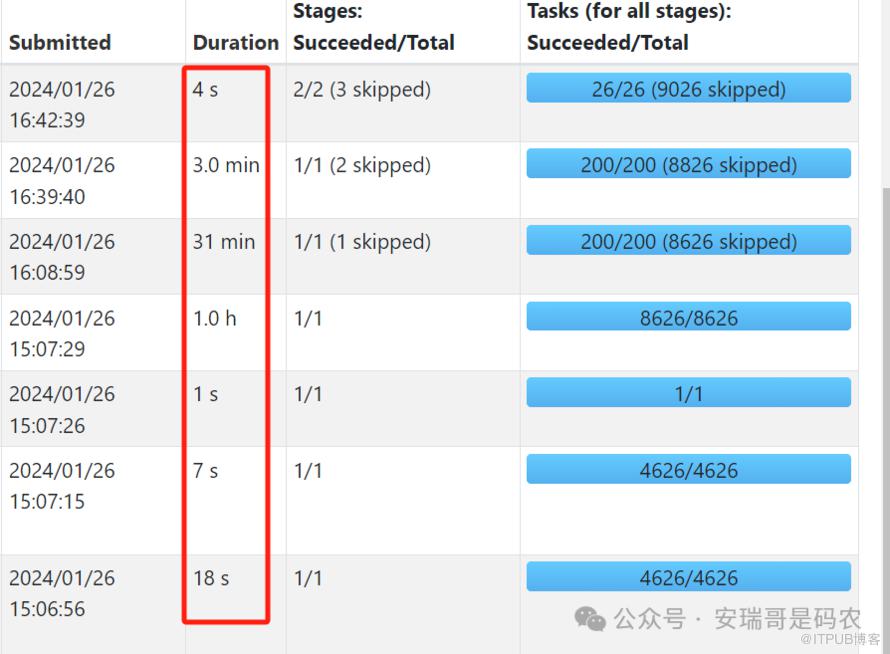
因为这个场景的测试,每跑一次都太耗时了,时间关系,第二趟咱就暂时不测了,行不(为了这趟测试,前后已折腾了两天)。
小结:利用 Celeborn 后,能成功跑完任务,而不开启 Celeborn 情况下,尝试3次都失败。
2. 测试过程说明
在以上测试过程中,为了尽可能减少干扰,在确保集群负载稳定的情况下,通过启用 Celeborn 跟不启用 Celeborn 功能交替串行的方式来执行测试程序。
在执行过程中,也出现过几次因为处理数据量太大,导致内存不足(跟是否开启 Celeborn 无关),或者网络连接异常而执行失败(没有开启 Celeborn 情况下),只能一次次调整参数,重试,每重试一次就得浪费至少1个小时,好好考验了一把我的耐心。
在测试过程中还发现,启用了 Celeborn 功能之后,随着处理数据量的加大和计算复杂度的提高,稳定性能得到很好的保障。
但并不能像某些「广告文」中宣称的那样,可以有效减少「堆外内存」的使用,至少,我这个场景下就不行(如下错误显示,原本设置的堆外内存太小,需要手动增加)。

在测试过程中,我也是一直瞪着眼珠子,密切注视 shuffle 数据目录的变化,生怕这玩意在摸鱼。
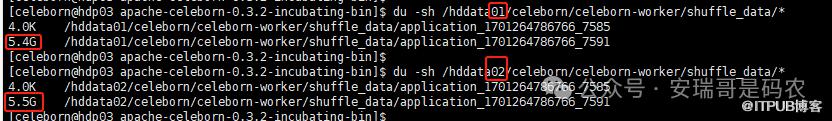
在计算过程中,发现对应目录大小会一直增加,直到整个 Spark 程序运行结束,对应文件跟目录就会很快删除。
最后
针对以上这些真实的测试对比结果,总结如下:
| sql条件 |
数据量 |
平均耗时(大概) |
提速效果 |
| sql01 |
3G |
50秒 |
8秒 |
| sql01 |
11G |
140秒 |
33秒 |
| sql01 |
88G |
15分钟 |
84秒 |
| sql01 |
1017G |
55分钟 |
几乎打平 |
| sql02 | 3G | 100秒 |
53秒 |
| sql02 | 11G | 4分20秒 |
4秒 |
| sql02 | 88G |
32分钟 |
3分10秒 |
| sql02 | 1017G | 1个半小时 |
完胜 |
从以上结果可以看出来,让我比较欣喜的是,启用 Celeborn 之后,能够保证 Spark 任务在处理大数据量,以及比较复杂的计算时,程序的稳定性。
至于它的提速,确实有一定的加速效果,只不过呢,总体来看,提的比较有限,而且偶尔还会「翻个车」,以我的评判标准,算差强人意吧。
那么对于 Celeborn 的表现, 你怎么看?

原文作者:安瑞哥是码农;如有侵权,请联系管理员删除。

