上篇文章体验了一把 Doris 的倒排索引功能,从初步的使用感受来看,是能达到预期的(现在来看,也只能是初步),Doris 在 2.x 的时候引入这个功能,算是一个明智之举。
毕竟,它填补了一般数据库对于一些业务字段「全文检索」能力的需求空白,进一步拓宽了 Doris 的应用场景。
但是,随着我进一步对这个添加了倒排索引的表,进行非匹配查询时,逐渐发现有点不对劲了,这里面或许隐藏了一个「惊天秘密」。
那就是,一旦这个添加了倒排索引功能的字段,如果参与到「聚合查询」时,其查询效率跟没有添加倒排索引前相比,反而降低了。
就问你相不相信吧?
那么今天这篇内容,咱就从聚合查询这个角度出发,看基于我的这个业务场景下,常用的几个聚合查询效率到底是怎么样的?
0. 对比设计
上一次体验 Doris 的倒排索引查询效率时,咱们用了一个近9百万的数据集,那么这一次,为了进一步拉开查询效率的差距,我决定选个大点的数据集。
全字段都添加倒排索引的 Doris 建表语句如下:
CREATE TABLE `dns_logs01` (
  `client_ip` varchar(200) NULL,
  `domain` varchar(200) NULL,
  `time` int(11) NULL DEFAULT "99999",
  `target_ip` text NULL,
  `rcode` int(11) NULL DEFAULT "99",
  `query_type` int(11) NULL DEFAULT "99",
  `authority_record` text NULL,
  `add_msg` text NULL,
  `dns_ip` text NULL,
  INDEX idx_domain (`domain`) USING INVERTED PROPERTIES("parser" = "english") COMMENT 'add inverted index for domain',
  INDEX idx_client_ip (`client_ip`) USING INVERTED PROPERTIES("parser" = "english") COMMENT 'add inverted index for client_ip',
  INDEX idx_authority_record (`authority_record`) USING INVERTED PROPERTIES("parser" = "english") COMMENT 'add inverted index for authority_record',
  INDEX idx_time (`time`) USING INVERTED,
  INDEX idx_target_ip (`target_ip`) USING INVERTED,
  INDEX idx_rcode (`rcode`) USING INVERTED,
  INDEX idx_query_type (`query_type`) USING INVERTED,
  INDEX idx_add_msg (`add_msg`) USING INVERTED,
  INDEX idx_dns_ip (`dns_ip`) USING INVERTED
) ENGINE=OLAP
DUPLICATE KEY(`client_ip`, `domain`)
COMMENT 'dns logs'
DISTRIBUTED BY HASH(`client_ip`) BUCKETS AUTO
PROPERTIES (
"replication_allocation" = "tag.location.default: 1",
"is_being_synced" = "false",
"storage_format" = "V2",
"light_schema_change" = "true",
"disable_auto_compaction" = "false",
"enable_single_replica_compaction" = "false"
);
从建表语句可以看出来,9个字段全都添加了倒排索引,其中3个指定了分词(对字段内容进行切词),而另外6个字段,因为要把内容作为一个整体存储,所以不切词。

这张新建的表用了3个桶,无副本。
而另一张参照表,则用的是没有添加任何额外索引的普通表,表结构如下:

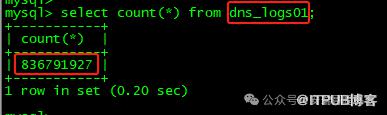
数据量有超过8亿条:

数据源表(参照表)记录数
而这张表所占用的存储为:

由于原表用了3份冗余,那么该表所占用的实际存储大小大概为12G多。
1. 灌数据
最简单的办法,直接用 insert into ... select * from ... 的方式就可以。
insert into dns_logs01 select * from dns_logs_from_kafka;
一小段时间之后,将这张源 Doris 表(dns_logs_from_kafka)的数据就全部灌入到新的 Doris 表(dns_logs01)中,由于新增了多个倒排索引,按理来说,存储空间会变大才对。
但是,你猜怎么着?
全部数据导过来之后,同样的数据量:
所占用的存储空间居然大大减少了:
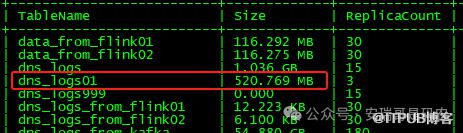
居然连1G都不到(一段时间合并之后查到的),家人们,谁能告诉我一下原因?
这就让我不得不怀疑,添加的这些倒排索引,到底能不能起到查询加速的作用(全文检索除外)?
事实证明,我的怀疑是有根据的。
2. 倒排索引带来的查询副作用
场景1:对索引字段取count distinct
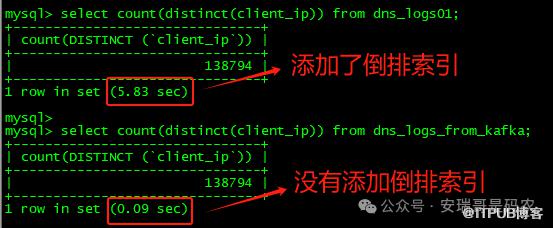
从对比测试来看,client_ip 这个字段在添加了倒排索引之后,查询效率反而大大降低。
继续换其他字段,再次测试:
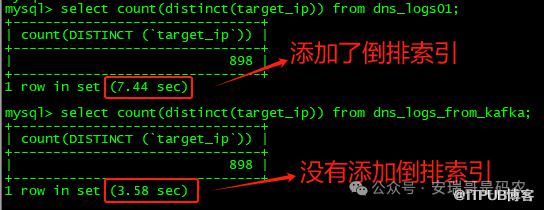
虽然这个字段的查询效率差异没有那么悬殊,但是,对比结果依然反常。
不服?再换个字段:

测试结果还是一样。
场景2:对索引字段进行普通聚合
案例1:

案例2:
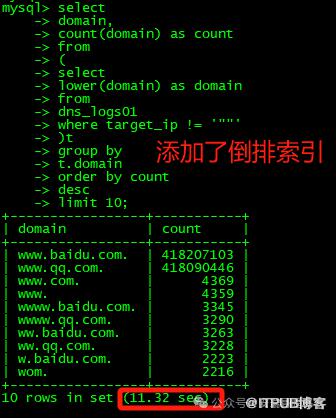

场景2通过实践证明,添加了倒排索引之后,查询效率也会降低。
场景3:
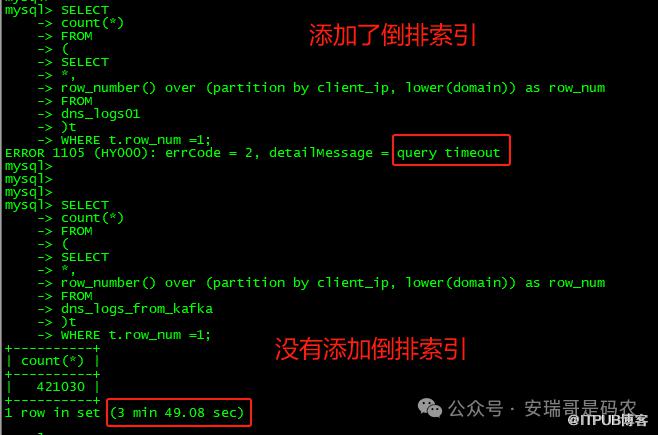
好家伙,针对这个查询,添加了倒排索引后的字段,直接查询超时,而对于没有添加倒排索引字段的表,虽然效率也很差,但好歹人家最后把结果给憋出来了呀。
最后
虽然暂时我没有办法把所有查询场景都一一测一遍,但是,从目前已经验证的事实来看。
Doris 的倒排索引功能有利有弊,其利在于:
1. 能切实增加字段的全文检索能力,其查询效率也能符合预期;
2. 如果全字段都添加倒排索引,能大大减少数据的存储空间。
但其弊在于:
对于已经添加倒排索引的的字段来说,如果对其进行聚合查询,查询效率相较于没有添加任何索引功能的字段来说,不但没有提升,反而会下降。
怎么样,这次的对比测试,有没有颠覆你的预期?
原文作者:安瑞哥是码农;如有侵权,请联系管理员删除。

