这个问题,来自于我跟一位辅导同学的“豪赌”,他说Clickhouse(下称CK)的分区表没啥用,起不到什么查询加速的作用,为了佐证他的说法,告诉我如下官方的对于表分区功能的解释:
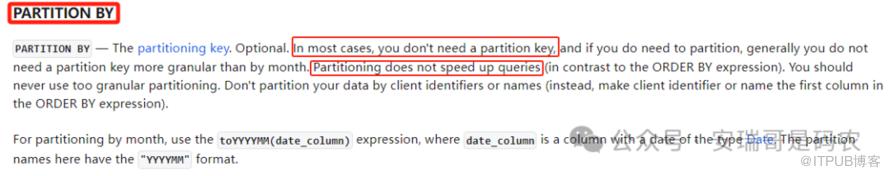
从这个解释来看,官方好像确实不怎么推荐你对 CK 表进行分区,而且它还说,即便你要分区,也希望你的分区粒度不要比「月份」这个粒度更细。
但你们知道,我这个人向来不信邪,官方文档也不是任何时候都靠谱(历史文章多次验证),我们得有自己的判断。
数据库表分区的核心目的,就是在存储的时候,根据分区字段,把数据存储到不同的目录(或者不同服务器)下,以此来区隔不同「分区字段值」的数据。
这样在查询时,如果筛选条件(where条件)中包含该字段,就能直接过滤掉无关的分区,从而加速查询。
所以我认为,分区表如果在查询条件合适(分区字段筛选)的情况下,一定是可以起到加速作用的,于是跟他打赌一顿饭。
至于这顿饭能不能吃上,接下来,咱跑起来试试看。
0. 测试准备
既然官方文档建议,大部分情况下,不要用分区表,而且就算用,也不要用比「月份」更小粒度的分区,那咱偏偏就用一个「天粒度」的分区表来做测试。
看是官方文档的描述不严谨,还是我的经验判断有失误?
简单起见,我们用本地表的方式进行验证。
为了让对比的查询效果更明显,我找到一张近20亿数据量,不带分区的本地表作为被测试对象。
其表结构如下:
CREATE TABLE local_db.dns_logs_no_partition
(
    `client_ip` String,
    `domain` String,
    `time` Date,
    `target_ip` String,
    `rcode` String,
    `query_type` String,
    `authority_record` String,
    `add_msg` String,
    `dns_ip` String
)
ENGINE = MergeTree
ORDER BY client_ip
SETTINGS index_granularity = 8192
另外,为了对比,我再新建一张表结构一样,但是以时间(粒度到天)作为分区的分区表。
分区表建表语句:
CREATE TABLE local_db.dns_logs_with_partition
(
    `client_ip` String,
    `domain` String,
    `time` Date,
    `target_ip` String,
    `rcode` String,
    `query_type` String,
    `authority_record` String,
    `add_msg` String,
    `dns_ip` String
)
ENGINE = MergeTree
PARTITION BY toYYYYMMDD(time)
ORDER BY client_ip
SETTINGS index_granularity = 8192
为了保证测试对比的公平性,现在把非分区表的数据,完全灌入到分区表中:
INSERT INTO local_db.dns_logs_with_partition SELECT * FROM local_db.dns_logs_no_partition;
从这个 insert 语句你应该可以看出来,CK的分区表,默认支持「动态分区」,直接就能根据分区字段,将数据自动写入到分区表里。
1. 数据存储形态
对这两张非分区表,跟分区表,我们来瞅一眼它的后台数据存储布局。
1.1 非分区表存储形态

非分区表有个明显的特征,那就是存储的文件夹都以 all 开头,证明只有一个分区。
因为 CK 特殊的数据结构缘故,导致这里面会有10个文件夹(数据完全合并之后),每个文件夹的存储分布如下:
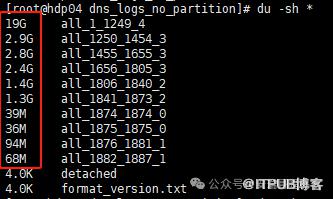
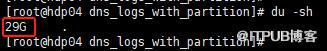
总共占用的存储为29G。

1.2 分区表存储形态
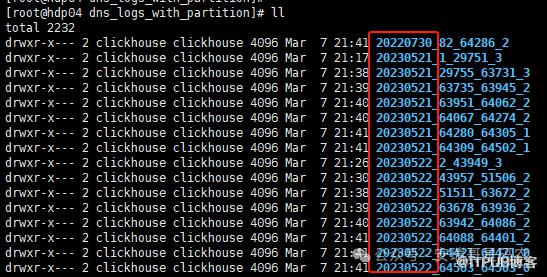
跟非分区表不同的是,分区表的数据存储目录,就是以「分区字段的值」来命名,因为目录比较多,这里没有截取完全,总共有 556 个目录(数据完全合并之后)。

因为有更多的文件夹,所以每个文件夹的大小,相比非分区表来说,会更小:

当然,数据的总大小不变,还是29G。
3. PK 开始
既然两张表的数据都已经准备就绪,那么接下来,咱就开始正式PK。
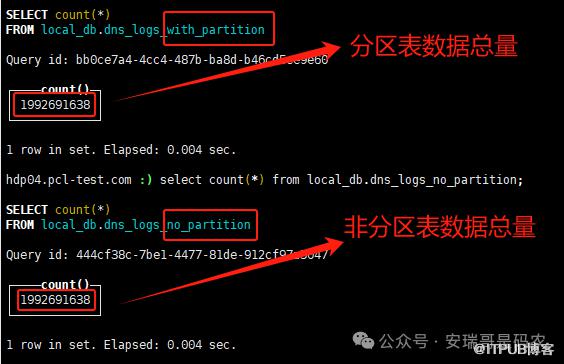
看一眼两表的数据总量:
3.1 第1回合
查询SQL:利用分区字段作为筛选条件时。
SELECT *
FROM table
WHERE (time = '2023-08-31') AND (target_ip = '110.242.68.4') AND (lower(domain) = '') AND (authority_record = '')
非分区表查询结果:
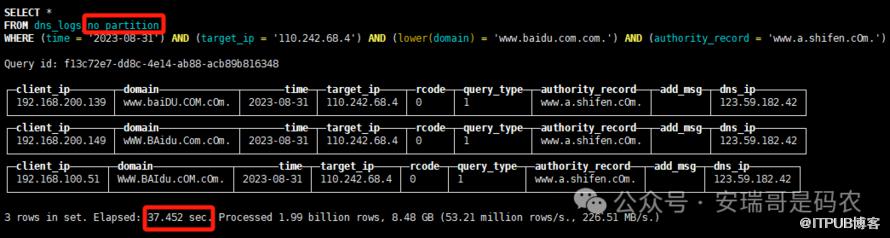
耗时37秒多。
分区表查询结果:
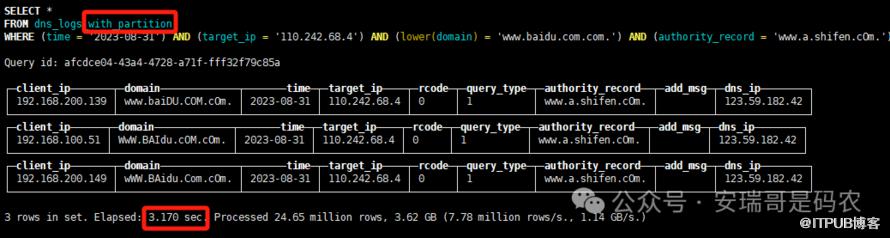
耗时3秒多。
小结:查询条件中带分区字段时,能有效提高查询效率。
3.2 第2回合
查询SQL:利用分区字段进行聚合时。
SELECT
    time,
    count(*) AS count
FROM dns_logs_with_partition
GROUP BY time
ORDER BY count DESC
LIMIT 5
非分区表查询结果:
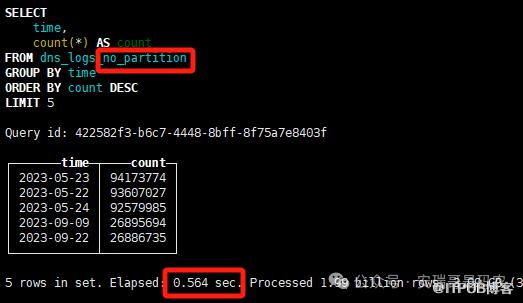
耗时0.564秒。
分区表查询结果:
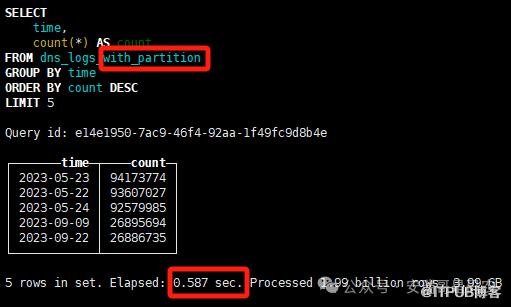
耗时0.587秒。
小结:当对分区字段进行聚合查询时,非分区表跟分区表的查询效率,几乎没有差别。
3.3 第3回合
查询SQL:利用非分区字段聚合时。
SELECT
    client_ip,
    count(*) AS count
FROM table
GROUP BY client_ip
ORDER BY count DESC
LIMIT 5
非分区表查询结果:

耗时2.781秒。
分区表查询结果:
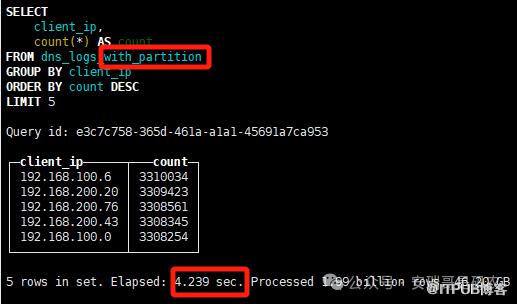
耗时4.239秒。
小结:当对非分区字段进行聚合时,非分区表的查询效率,要高于分区表。
3.4 第4回合
查询SQL:只用非分区字段做条件筛选。
SELECT count(*)
FROM table
WHERE (target_ip = '110.242.68.4') AND (lower(domain) = '') AND (authority_record = '')
非分区表查询结果:

耗时324秒多。
分区表查询结果:
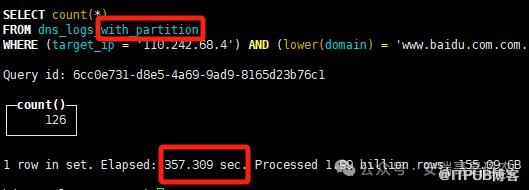
耗时357秒多。
小结:只用非分区字段做条件筛选时,非分区表的查询效率,要略高于分区表。
结论
由于 CK 有非常高效的查询缓存机制,以上所有查询,都是在消除缓存影响的情况下进行,即相同的SQL语句,只取第一次的成绩,而且同一个场景,会用多个不同的SQL进行测试,只不过文中只记录最有代表性的情况。
从这次的实测来看,CK的分区表肯定是可以起到查询加速作用的,只不过,前提是,必须要将分区字段作为筛选条件。
否则,如果查询条件中不包含分区字段,其查询效率,反而不如相同条件下的非分区表(因为此时的分区表,不能快速过滤掉无关数据,且数据分布相比非分区表,更加分散,导致磁盘寻址时,查找的范围更广,因此IO效率更低)。
所以对于CK的表查询效率来说,创建分区,是一把双刃剑(其实所有数据库的分区表都一样),并不能脑子一拍,想怎么来就怎么来,而是需要根据你的查询特点,来判断是否添加。

原文作者:安瑞哥是码农;如有侵权,请联系管理员删除。

