这几天一直在折腾这两款数据库,其存储以及表特性上的原理跟玩法。
上篇文章刚研究完 Clickhouse (下称CK)的存储特性,然后就想着,再深入看看 CK 的聚合表引擎相关的内容,结果看着看着,心想:咦... 要不干脆也对比一下 Doris 的聚合表,看它俩在面对同一个应用场景时,各自的表现会有什么不一样。
于是,就有了这篇文章。
(PS:本次对比,采用的数据库版本分别是:Doris2.02 跟 CK23.4.1)
0. 对比准备
为了快速、且清晰的反映出 CK 跟 Doris 的聚合表引擎(表模型)之间的差异,我们来设计一个非常简单的场景:
统计出每一个 IP (client_ip)),上不同网站(domain)的次数。
因为今天这篇文章只是想做个功能对比,所以只用少数测试数据就可以了。
表数据如下:
| client_ip |
domain |
time |
count |
| 1.2.3.4 |
2024-03-01 |
1 |
|
| 1.2.3.4 |
2024-03-02 | 1 |
|
| 2.3.4.5 |
www.qq.com |
2024-03-03 |
1 |
| 3.4.5.6 |
2024-03-04 |
1 |
|
| 1.2.3.4 |
2024-03-01 |
1 |
|
| 2.3.4.5 |
www.qq.com | 2024-03-03 |
1 |
| 4.5.6.7 |
2024-03-04 | 1 |
|
| 1.2.3.4 |
2024-03-01 | 1 |
对于这份数据,用普通的SQL来满足这个统计需求,应该这么来写:
SELECT
client_ip,
domain,
COUNT(*) as count
FROM table
GROUP BY
client_ip,
domain
看到这个SQL,你会不会有疑问,说:不是有个时间字段吗,怎么这里不用呢?
对于这个问题,后面,咱通过分别创建基于时间的分区表跟非分区表,来展开说明。
就是这么一个简单的统计,下面我们一起来看看,如果用 CK 跟 Doris 的聚合表,分别是怎么实现的?
1. CK聚合引擎表
在我之前的文章里介绍过,CK 的聚合引擎其实有两种,一种叫 SummingMergeTree ,而另一种叫做 AggrateMergeTree。
只不过呢,第一个功能非常弱鸡,只能实现「sum」操作,而第二个则功能要强大很多,一般我们常用的聚合函数都可以,比如像 count、sum、replace、unique、max、min 等。
好,咱闲嗑少唠,现在开始验证。
1.1 用 SummingMergeTree
非分区表模式下
建表语句:
CREATE TABLE local_db.summ_no_partition
(
    `client_ip` String,
    `domain` String,
    `time` Date,
    `count` UInt32
)
ENGINE = SummingMergeTree
ORDER BY (client_ip, domain)
然后,把上面准备的8条数据给 insert 进去(注意这个写入方式,跟下面 AggrateMergeTree 表引擎方式的不同):
insert into local_db.summ_no_partition values('1.2.3.4','','2024-03-01',1);
insert into local_db.summ_no_partition values('1.2.3.4','','2024-03-02',1);
insert into local_db.summ_no_partition values('2.3.4.5','www.qq.com','2024-03-03',1);
insert into local_db.summ_no_partition values('3.4.5.6','','2024-03-04',1);
insert into local_db.summ_no_partition values('1.2.3.4','','2024-03-01',1);
insert into local_db.summ_no_partition values('2.3.4.5','www.qq.com','2024-03-03',1);
insert into local_db.summ_no_partition values('4.5.6.7','','2024-03-04',1);
insert into local_db.summ_no_partition values('1.2.3.4','','2024-03-01',1);
写完之后,看一眼全局的数据情况:
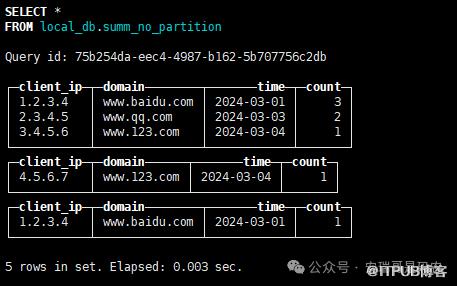
可以看到,8条数据已经全部写了进来,而且部分数据进行了合并。
但是,不知道你有没有发现,这个结果并不是最终合并的,原因在于,CK 的聚合引擎会是在后台「不定期」对数据进行聚合操作的(注意这里跟 Doris 的区别,一会要考)。
那咋整呢?咱可以用纯手动的方式,强行让它完全聚合。
OPTIMIZE TABLE local_db.summ_no_partition FINAL
再看一眼:

发现没有,这个结果就已经是我们需要的最后聚合结果了,只不过呢,多了一个时间列,而这个时间列的值,取的是「第一个不同(client_ip、domain)组合记录时的 time 值」,其中 2024-03-02 这个时间被干掉了。
虽然对于当前这个查询来说,已经能够得到最终的结果了,但是,为了美观和严谨,还是推荐你用下面这种方式来查询,当然,这也是官方推荐的:

接下来,再看看分区表的表现。
分区表建表模式下:
建表语句:
CREATE TABLE local_db.summ_with_partition
(
    `client_ip` String,
    `domain` String,
    `time` Date,
    `count` UInt32
)
ENGINE = SummingMergeTree
PARTITION BY time
ORDER BY (client_ip, domain)
用同样的方式,把刚才那8条数据灌进去,过程略...。
瞅一眼数据:

哎呀我去,这次居然它一丢丢都不合并了呢,写进去几条就是几条。
那再运行一下强行合并(把刚才那个合并语句再运行一遍)。
再看:
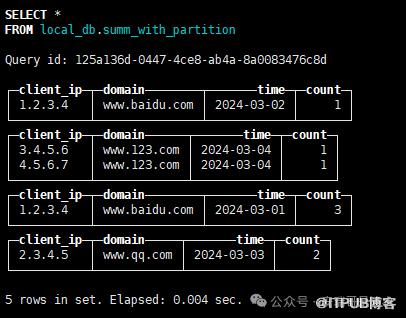
发现了没有,这个根据时间分区合并后的结果,跟上面没有分区的表,合并后的结果,是不一样的。
从这个结果可以看出来,分区表的聚合,是以分区为单位进行的(你可能认为这句是废话,但在实际工作中,有的同学就是会搞错)。
当然,正确的聚合方式,还是用这个标准的聚合SQL:
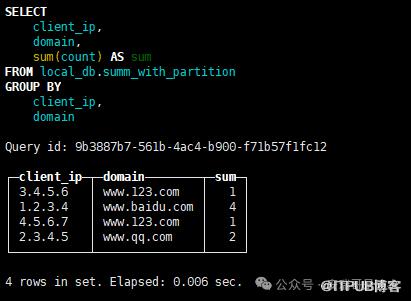
1.2 用 AggrateMergeTree
接下来,咱换一种引擎试试。
非分区表模式下:
建表语句:
CREATE TABLE local_db.agg_no_partition
(
    `client_ip` String,
    `domain` String,
    `time` Date,
    `count` AggregateFunction(count, UInt32)
)
ENGINE = AggregatingMergeTree
ORDER BY (client_ip, domain)
跟上面的 SummingMergeTree 引擎相比,这个引擎在建表的时候,是不是明显感觉破事要更多一点(看 count 字段的类型,必须申明为聚合函数类型)。
开始写数据,注意,必须要用这种特别“膈应人”的方式来写(跟上面的不一样):
insert into local_db.agg_no_partition select '1.2.3.4','','2024-03-01',countState(1);
insert into local_db.agg_no_partition select '1.2.3.4','','2024-03-02',countState(1);
insert into local_db.agg_no_partition select '2.3.4.5','www.qq.com','2024-03-03',countState(1);
insert into local_db.agg_no_partition select '3.4.5.6','','2024-03-04',countState(1);
insert into local_db.agg_no_partition select '1.2.3.4','','2024-03-01',countState(1);
insert into local_db.agg_no_partition select '2.3.4.5','www.qq.com','2024-03-03',countState(1);
insert into local_db.agg_no_partition select '4.5.6.7','','2024-03-04',countState(1);
insert into local_db.agg_no_partition select '1.2.3.4','','2024-03-01',countState(1);;
写进去之后,看一眼全局数据:
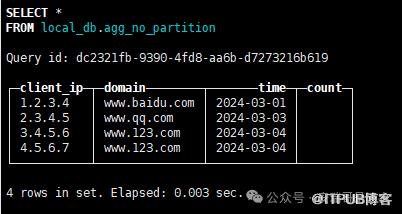
count 列没有值,有点懵逼对不对,懵逼是正常的,因为对于 AggrateMergeTree 引擎表来说,直接查,它就是这个样子的。
但是,这里要注意,这个查询结果里,只有4条数据,其中 2024-03-02 这个日期的数据,被合并掉了(一会对比下面的分区表数据)。
想要看到正常的数据,你得这样:
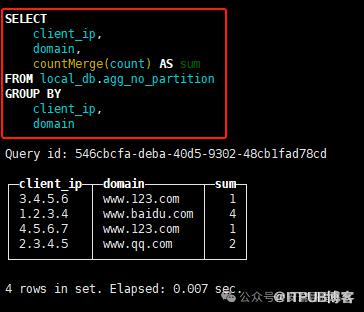
才能得到正确的结果。
分区表模式下:
建表语句:
CREATE TABLE local_db.agg_with_partition
(
    `client_ip` String,
    `domain` String,
    `time` Date,
    `count` AggregateFunction(count, UInt32)
)
ENGINE = AggregatingMergeTree
ORDER BY (client_ip, domain)
PARTITION BY time
接下来,用刚才同样的方法,写入那8条数据,过程略...
再看一眼全局数据:
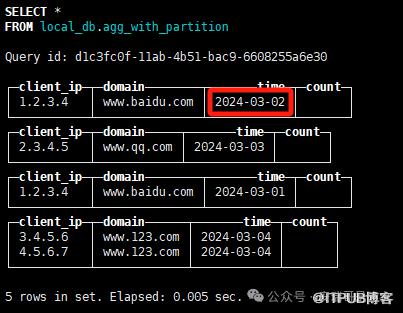
对比上面那个非分区表的数据,发现没有,刚才消失那条 2024-03-02 数据又出现了。
这个,就是分区表,跟非分区表在数据聚合时候的差别。
当然,咱们用正规的聚合查询,还是可以得到正确结论的:

以上,就是利用 CK 的聚合引擎,分别在非分区表和分区表情况下做的测试验证。
2. Doris聚合表模型
CK 叫聚合引擎表,到了 Doris 这里,换了个说法,叫聚合表模型,无妨,它爱叫啥叫啥。
对于 Doris 来说,它不像 CK,只有一种这样的聚合表可以用,根据官方的语法要求,且为了尽可能保持跟上面 CK 表的各方面属性一致,设计对比测试如下。
非分区表:
CREATE TABLE test.agg_no_partition
(
    `client_ip` varchar(20),
    `domain` varchar(20),
    `time` DATE,
    count INT SUM
)
AGGREGATE KEY(client_ip, domain, time)
DISTRIBUTED BY HASH(client_ip,domain) BUCKETS 1
PROPERTIES (
"replication_allocation" = "tag.location.default: 1"
);
仔细跟上面的 CK 表对比一下,发现出差异没?
这里想说明的是,对于这个 Doris 的建表,相比 CK,有以下限制:
限制1:key 指定的所有字段中,必须全部都不能是 String 类型,但 CK 可以;
限制2:建表的所有字段中,必须归为2类,1类为key,另1类只能是value,而且,aggregate key 必须包含全部的 key 字段。
也就是说,如果我想跟上面的 CK 表一样,把 aggregate key 指定为(client_ip, domain),是做不到的,必须是(client_ip, domain,time)。
限制3:必须要指定分桶,CK 则不用。
给我的感觉就是,咦... 耍起来没那么顺溜了。
建表完成,现在写入数据,SQL 如下:
insert into test.agg_no_partition values('1.2.3.4','','2024-03-01',1);
insert into test.agg_no_partition values('1.2.3.4','','2024-03-02',1);
insert into test.agg_no_partition values('2.3.4.5','www.qq.com','2024-03-03',1);
insert into test.agg_no_partition values('3.4.5.6','','2024-03-04',1);
insert into test.agg_no_partition values('1.2.3.4','','2024-03-01',1);
insert into test.agg_no_partition values('2.3.4.5','www.qq.com','2024-03-03',1);
insert into test.agg_no_partition values('4.5.6.7','','2024-03-04',1);
insert into test.agg_no_partition values('1.2.3.4','','2024-03-01',1);
看一眼全局数据:
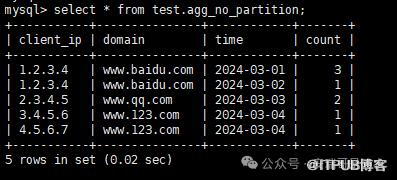
从结果来看,它不像 CK,需要手动触发合并,才能保证完成数据的后台完全合并,Doris 直接查就可以,当即就是聚合后的最终结果,省去了写聚合查询语句的麻烦。
当然,这里默认的是加入了日期的聚合结果,想要得到(client_ip,domain)的聚合结果,得额外写聚合语句:
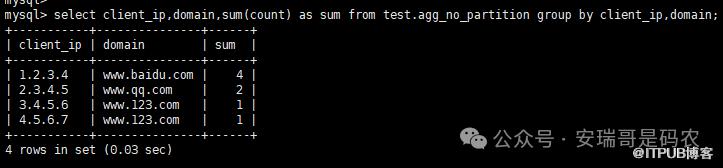
分区表(动态分区):
CREATE TABLE test.agg_with_partition
(
    `client_ip` varchar(20),
    `domain` varchar(20),
    `time` DATE,
    count INT SUM
)
AGGREGATE KEY(client_ip, domain, time)
PARTITION BY RANGE(time) (
 PARTITION p01 VALUES [("2024-03-01"), ("2024-03-02")),
  PARTITION p02 VALUES [("2024-03-02"), ("2024-03-03")),
  PARTITION p03 VALUES [("2024-03-03"), ("2024-03-04")),
  PARTITION p04 VALUES [("2024-03-04"), ("2024-03-05"))
)
DISTRIBUTED BY HASH(client_ip,domain)
PROPERTIES (
 "replication_allocation" = "tag.location.default: 1",
 "dynamic_partition.enable" = "true",
  "dynamic_partition.time_unit" = "DAY",
  "dynamic_partition.end" = "3",
  "dynamic_partition.prefix" = "p",
  "dynamic_partition.buckets" = "1"
);
老实说,为了创建这个所谓的「动态分区表」,趟了不少坑,居然需要这么麻烦(关于 Doris 的分区表,下次我专门写一篇内容)。
写入数据,跟上面方式一样,略...
看一眼全局数据:

既然已经根据时间分好了区,且根据(client_ip, domain, time)进行的聚合,聚合结果自然不会有问题。
只不过,这个分区表直接查询出来的结果,跟它的非分区表相比,没有任何不一样(对比 CK 的分区表跟非分区表,是有差异的)。
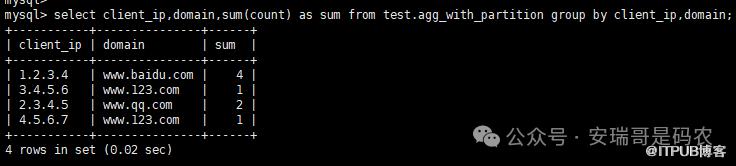
再看我们需要的最终聚合结果:
总结
从这个简单的聚合需求实现来看,CK 跟 Doris 的玩法中,虽然都有各自的聚合表,也都能实现这次的测试目的,但是玩法却各异。
对于 CK 来说:
1. 建表条件更加宽松,灵活,没有过多的各种约束,让人很舒服;
2. 对它的聚合引擎表而言,数据写入时,不能用常规的方式,而且写入的数据并不能做到立刻合并,需要手动执行合并命令,或者采用聚合方式查询,才能得到正确结果,使用复杂程度比较高;
3. 对于分区表来说,能做到真正意义上的「动态分区」,不需要你对分区这件事本身有任何操心,使用起来简单方便。
对于 Doris 来说:
1. 建表条件相比 CK,限制更多一点,个人认为没有 CK 的要求灵活;
2. 对于聚合表模型来说,它的数据合并是可以做到「即写即查」的,不需要用到聚合SQL,就可以查询到最终合并后的结果,使用门槛更低;
3. 对于分区表来说,虽然也提供了所谓的动态分区,但是,从我的体验来看,仍然需要对分区这件事操不少心,多少有点「逗你玩」的感觉,顶多算个「半自动」。
那么对于这次 CK 跟 Doris 的聚合表对比,你怎么看?

原文作者:安瑞哥是码农;如有侵权,请联系管理员删除。

