这段时间不是在倒腾 Flink 跟 Spark 各种场景下的数据读写对比嘛,于是就想着,既然这两款引擎都支持流式计算,那咱就看看,它们在基于「状态计算」下,各自的表现怎么样。
我们都知道,最近这几年, 关于实时计算中,跟状态计算相关的话题,几乎都被 Flink 给包圆了,网络上,关于 Spark 状态计算相关的话题都很少,或者说即便有,也都只是停留在那些老掉牙的,对 updateStateByKey、mapWithState 这两个算子的解读上。
殊不知,人家老大哥 Spark structed streaming 能支持的状态计算,可不止这一点呢。
不信,咱今天就来瞧瞧,在面对流状态计算场景中,常见的聚合计算,Spark 的表现如何?以及对比 Flink,谁更好用?
0. 对比前准备
对比场景很简单,我们先将一份特定的,知道聚合结果的数据用一定的速率,灌入到 Kafka 中。
然后,同时启动 Spark structed streaming 任务,以及 Flink 任务,让它们分别同时消费上面这份 Kafka 数据;
通过 Spark 跟 Flink 的聚合计算,计算出每个ip(client_ip)访问的网站(domain)次数,用 SQL 表示就是:
SELECT
    client_ip,
    lower(domain) AS domain,
    count(*) AS count
FROM data
GROUP BY
    client_ip,
    domain
然后将最终的计算结果写入到 Doris 表里,由于是流方式实时写入,所以写入的结果随时需要被更新,于是需要设计一张去重表:
CREATE TABLE IF NOT EXISTS example_db.data_from_flink01/spark01
(
    `client_ip` VARCHAR(50),
    `domain` VARCHAR(200),
    `count` INT
)
UNIQUE KEY(`client_ip`, `domain`)
DISTRIBUTED BY HASH(`client_ip`) BUCKETS 3
PROPERTIES (
"replication_allocation" = "tag.location.default: 1"
);
过程中,观察 Spark 以及 Flink 的中间输出结果变化,以及存储状态变化。
最后,看最终写入到 Doris 数据库的结果,是否符合预期。
1. Spark 编码方式
经过一番折腾调试之后,能顺利跑通的 Spark API 如下:
package com.anryg.bigdata.streaming.stateful


import com.alibaba.fastjson.JSONObject
import org.apache.log4j.{Level, Logger}
import org.apache.spark.SparkConf
import org.apache.spark.sql.SparkSession
import org.apache.spark.sql.streaming.{OutputMode, Trigger}

/**
  * @DESC: 测试 Spark 在流式计算下的聚合计算,并将结果写入到Doris
  * @Auther: Anryg
  * @Date: 2024/4/2 11:23
  */
object SparkGroupBy01 {

    def main(args: Array[String]): Unit = {
        val conf = new SparkConf().setAppName("SparkGroupBy01").setMaster("local[*]")
        val spark = SparkSession.builder()
            .config("spark.sql.streaming.stateStore.providerClass", "org.apache.spark.sql.execution.streaming.state.RocksDBStateStoreProvider")//指定流计算的状态存储为RocksDB,3.2之后支持
            .config(conf)
            .getOrCreate()

        val rawDF = spark.readStream
            .format("kafka")
            .option("kafka.bootstrap.servers", "192.168.211.107:6667")
            .option("subscribe", "test")
            .option("failOnDataLoss",false)
            .option("fetchOffset.numRetries",3)
            .option("startingOffsets","latest")
            .load()

        import spark.implicits._
        val df1 = rawDF.selectExpr("CAST(value AS string)")
            .map(row =>{
                val line = row.getAs[String]("value")
                val fieldArray:Array[String] = line.split(",")
                fieldArray
            }).filter(_.length == 9)
            .map(array =>(array(0),array(1),array(2),array(3),array(4),array(5),array(6),array(7),array(8)))
            .toDF("client_ip","domain","time","target_ip","rcode","query_type","authority_record","add_msg","dns_ip")

        df1.createOrReplaceTempView("data_from_kafka")

        /**聚合计算逻辑,取出聚合结果*/
        val df2 = spark.sql(
                    """
                      |SELECT
                      |    client_ip,
                      |    lower(domain) AS domain,
                      |    count(*) AS count
                      |FROM data_from_kafka
                      |WHERE client_ip != ''
                      |GROUP BY
                      |    client_ip,
                      |    domain
                    """.stripMargin)

        /**必须要对结果的格式重新定义为json string,否则直接无法写入Doris*/
        val df3 = df2.map(row => {
                    val json = new JSONObject(3)  /**将数据封装为json对象*/
                    val client_ip = row.getString(0)
                    val domain = row.getString(1)
                    val count = row.getLong(2)

                    json.put("client_ip",client_ip)
                    json.put("domain", domain)
                    json.put("count", count)
                    json.toJSONString
                }).toDF()

       df3.writeStream
            .outputMode(OutputMode.Complete()) //确定输出模式,因为是聚合结果,要用complete模式
            .format("doris")
            .option("doris.table.identifier", "example_db.data_from_spark01")
            .option("doris.fenodes","192.168.221.173:8030")
            .option("user","root")
            .option("password","xxx")
            .option("checkpointLocation","hdfs://192.168.211.106:8020/tmp/spark_checkpoint/test/SparkGroupBy01") /**这个必须加上,记录offset以及计算状态*/
            .start()
            .awaitTermination()
    }
}
这里面有几个需要你注意的地方在于:
1. Spark 也可以设置它状态的存储方式,比如,这里用的就是跟 Flink 一样的 RocksDB。

只不过,它是在 Spark 3.2 及之后版本才支持;
2. 因为是对聚合结果进行输出,所以它的输出方式必须为 complete 模式;

3. 也是比较坑爹的,那就是如果输出结果要写 Doris,必须要把 DataFrame 里面的 Row 对象,转行成为 json string 才行,否则就会抛出下面这个让你一脸懵逼的错:

当然,对于这个我认为特傻逼的问题(这个 Dataframe 本身就是带 schema 的数据结构,为毛还要多此一举),之前文章也吐槽过。
2. Flink 编码方式
方便起见,这里我用 Flink 的 SQL API。同样,经过调试之后,能顺利跑通的代码如下:
package com.anryg

import java.time.Duration

import org.apache.flink.contrib.streaming.state.EmbeddedRocksDBStateBackend
import org.apache.flink.streaming.api.CheckpointingMode
import org.apache.flink.streaming.api.environment.CheckpointConfig.ExternalizedCheckpointCleanup
import org.apache.flink.streaming.api.scala.StreamExecutionEnvironment
import org.apache.flink.table.api.bridge.scala.StreamTableEnvironment

/**
  * @DESC: 测试 Flink SQL 在流式计算下的聚合计算,并将结果写入到Doris
  * @Auther: Anryg
  * @Date: 2024/4/2 17:20
  */
object FlinkGroupBy01 {

    def main(args: Array[String]): Unit = {
        val env = StreamExecutionEnvironment.getExecutionEnvironment

        env.enableCheckpointing(60000L)

        env.setStateBackend(new EmbeddedRocksDBStateBackend(true)) //新的设置state backend的方式

        env.getCheckpointConfig.setCheckpointStorage("hdfs://192.168.211.106:8020/tmp/flink_checkpoint/FlinkGroupBy01")
        env.getCheckpointConfig.setExternalizedCheckpointCleanup(ExternalizedCheckpointCleanup.RETAIN_ON_CANCELLATION) //设置checkpoint记录的保留策略
        env.getCheckpointConfig.setAlignedCheckpointTimeout(Duration.ofMinutes(1L))
        env.getCheckpointConfig.setCheckpointingMode(CheckpointingMode.AT_LEAST_ONCE)

        val tableEnv = StreamTableEnvironment.create(env)

        /**第一步:读取kafka数据源*/
        tableEnv.executeSql(
            """
             Create table data_from_kafka(
             |client_ip STRING,
             |domain STRING,
             |`time` STRING,
             |target_ip STRING,
             |rcode STRING,
             |query_type STRING,
             |authority_record STRING,
             |add_msg STRING,
             |dns_ip STRING
             |)
             |with(
             |'connector' = 'kafka',
             |'topic' = 'test',
             |'properties.bootstrap.servers' = '192.168.211.107:6667',
             |'properties.group.id' = 'FlinkGroupBy01',
             |'scan.startup.mode' = 'latest-offset',
             |'value.format'='csv',                                 //确定数据源为文本格式
             |'value.csv.field-delimiter'=','                      //确定文本数据源的分隔符
             |)
            """.stripMargin)

        /**第二步:创建Doris映射表*/
        tableEnv.executeSql(
            """
               |CREATE TABLE data_from_flink01 (
               |client_ip STRING,
               |domain STRING,
               |`count` BIGINT
               |)
               |    WITH (
               |      'connector' = 'doris',
               |      'fenodes' = '192.168.221.173:8030',
               |      'table.identifier' = 'example_db.data_from_flink01',
               |      'username' = 'root',
               |      'password' = 'xxx',
               |     'sink.label-prefix' = 'label01'  //导入标签前缀,每次要不一样
               |)
            """.stripMargin)

        /**第三步:写聚合结果到Doris表*/
        tableEnv.executeSql(
            """
              |INSERT INTO data_from_flink01
              |SELECT
              |    client_ip,
              |    lower(domain) AS domain,
              |    count(*) AS `count`
              |FROM data_from_kafka
              |WHERE client_ip <> ''
              |GROUP BY
              |    client_ip,
              |    domain
            """.stripMargin)
    }
}
同样,这里也有几个需要值得注意的地方:
1. 同样的 SQL,Flink 跟 Spark 这里就出现了语法上的2处不一致。
第1处不一致:

这个 count 必须要用「尖括号」(tab键上面那个)给括起来,否则语法不通过,而 Spark sql 不用;
第2处不一致:
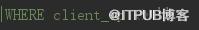
这个不等号,Flink 得用 “<>” 符号,而Spark 用的是 “!=”。
2. 还记得之前我的文章验证过,Flink 消费 Kafka 数据时,如果用 latest 模式,会丢数据,你猜这次它会不会呢?
3. Spark 跟 Flink 运行过程对比
因为都用的 latest 消费模式,所以先启动 Spark 跟 Flink 进程,然后往 Kafka 推数据,这样它们就能消费到一样的数据了。
先往 Kafka 的 topic 推了3条数据,观察到如下的输出情况。
对于 Spark 的中间输出数据来说:
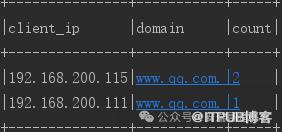
因为它不像 Flink 有「回撤流」的概念,所以聚合结果每次都是全量最新的,而且它的聚合 SQL 可以用「任意字段」进行排序,比如对 count 排序。
而对于 Flink 的中间结果来说:
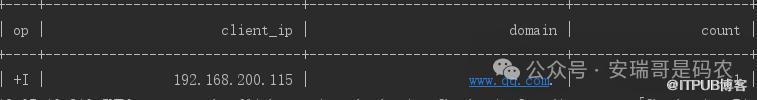
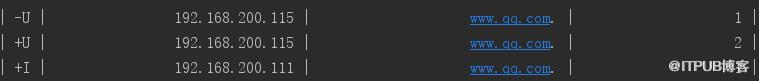
因为它有「回撤流」的概念,所以每次如果聚合结果有更新,都会有 -U 的回撤数据出现,因为这个,相比 Spark,它不能用「非时间」字段进行排序。
再来看一眼 Spark 跟 Flink 的状态目录情况。
Spark 的状态目录:
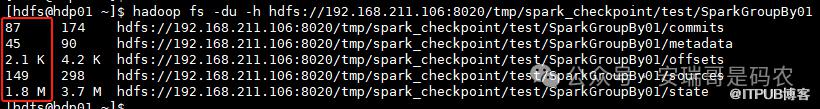
可以看到它的目录结构比较丰富,总共有5个,而且才写入3条数据,居然它的状态就有 1.8MB+ 大小,但最终的状态大小,咱后面需再进一步比较看。
Flink 的状态目录:

相比 Spark,Flink 的状态目录结构更简单,而且一开始占用空间也更小,但是它这个即便在没有数据处理(流入)的情况下,还在不断地「删除老目录,创建新目录」这个行为,多少有点让人想不通。
4. 运行结果对比
先确定这两个程序在本地环境测试运行OK,然后打包上传到 YARN 集群运行,确保这两个进程已经完全启动。
将事先准备好的一张四百多万记录 Clickhouse 表数据,给推入到 kafka 中,
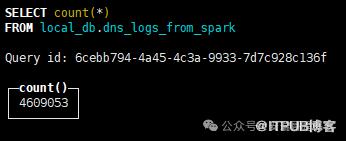
这样做的最大好处在于,我是提前知道聚合结果的,这样就能验证经过 Spark 以及 Flink 的流式聚合计算之后,写入到 Doris 的结果,它到底准不准。
一番操作猛如虎之后发现,数据已经全部写入到对应的两张 Doris 表里。
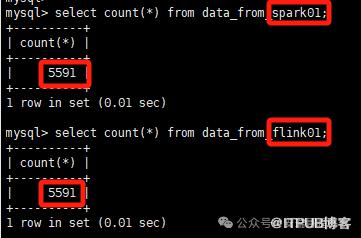
可以看到输出的聚合结果数据量是一样的,都是 5591条。
为了验证这个数量的正确性,我们来看一下原表的聚合结果数据量:
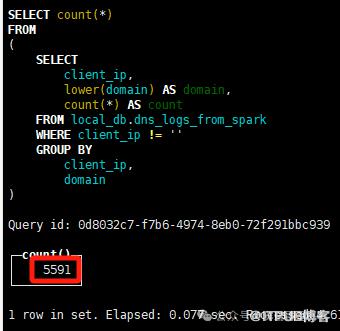
可以看到,CK 的原表聚合记录也是 5591条,证明这个总数量没错。
但是,这样你是不是就以为写入结果就真的正确了呢?
从运行效率来看,Spark 处理完这些数据耗时如下:

花了 204秒。
而 Flink 因为玩法跟 Spark 不一样,只能盯着它数据处理开始的时间,然后用数据处理完的大概时间跟它取时间差,我大概算了一下,用时140秒左右。
再来看一眼这两者的状态存储情况。
Spark 的状态:
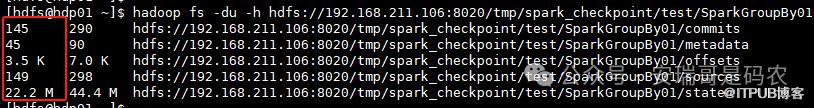
占用 22MB 多一点。
Flink 的状态:

占用 17MB 多一点。
最后
从这次 Spark 跟 Flink 简单的聚合状态计算对比来看,这两款时下主流的计算引擎,都支持在实时模式下的「状态计算」。
但是从这次测试对比来看,它们之间的区别跟联系在于:
1. Spark 跟 Flink,都能够根据业务需求,达到聚合状态计算的目的;
2. 聚合状态计算的效率不一样,Flink 的效率,要高于 Spark;
3. 从存储的状态来看,Flink 占用的存储空间要略小于 Spark,但是,在没有数据流入的情况下,Flink 依然会定期「删除目录,重建目录」,Spark 则不会。
最后,留个思考题:
在这次设计的测试对比中,最终写入到 Doris 的聚合结果,对?还是不对呢?为什么?
答案咱们在下一篇揭晓。
原文作者:安瑞哥是码农;如有侵权,请联系管理员删除。

