上篇文章咱们实测了利用 Flink 的「EXACTLY_ONCE」和「AT_LEAST_ONCE」语义,以流的方式读取 HDFS 上的数据,然后将数据写入到 Elasticsearch(下称 ES)。
过程中,通过调整 checkpoint 时间,以及两种不同的语义方式,来对比不同参数组合下,数据入库的总量变化情况(B站直播的时候又演示了一遍)。
从最后的测试结果来看,仅仅只是设置 Flink 的 CheckpoinMode 而不采取其他任何措施的话,写入到 ES 的数据量都会比期望的要多。
那么这一次,咱们把数据源从之前的 HDFS,换成你可能更感兴趣的 Kafka,同时增加 Spark 作为对比,看测试效果会不会变得不一样。
0. 测试设计
还是把上次测试过的那批相同的数据,我用 Spark 给写入到 Kafka 里面,然后,分别用 Flink 和 Spark 以流的方式去消费,然后再次写入到 ES。

这一次,我们不再用「手动」的方式去 cancel 停掉进程,而是通过进程在处理数据时,自然发生「处理错误」导致进程退出。
然后,对错误进行捕捉处理,再次对程序通过「checkpoint」恢复,看最终写入到 ES 的数据量跟预期的是否一致。
其中,经过调试之后的 Spark 代码如下:
package com.anryg.bigdata.streaming.es

import java.util.concurrent.TimeUnit

import com.alibaba.fastjson.JSON
import com.anryg.bigdata.clickhouse.CKSink
import com.anryg.bigdata.{IpSearch, RedisClientUtilsV2}
import org.apache.spark.SparkConf
import org.apache.spark.sql.SparkSession
import org.apache.spark.sql.streaming.{OutputMode, Trigger}

/**
  * @DESC: 通过spark structured streaming消费kafka写 ES,测试程序失败后,通过checkpoint恢复,数据重复的情况
  * @Auther: Anryg
  * @Date: 2024/4/16 10:18
  */
object SparkFromKafka2ES {

    def main(args: Array[String]): Unit = {
        val conf = new SparkConf().setAppName("SparkFromKafka2ES").setMaster("local[*]")
        val spark = SparkSession.builder().config(conf).getOrCreate()

        val rawDF = spark.readStream //获取数据源
                .format("kafka") //确定数据源的来源格式
                .option("kafka.bootstrap.servers", "192.168.211.107:6667") //指定kafka集群的地址,理论上写一个broker就可以了
                .option("subscribe","test")  //指定topic
                .option("failOnDataLoss",false)  //如果读取数据源时,发现数据突然缺失,比如被删,则是否马上抛出异常
                .option("fetchOffset.numRetries",3)  //获取消息的偏移量时,最多进行的重试次数
                .option("startingTimestamp","1713182435000") //通过时间戳指定消费位置
                .load()

        import spark.implicits._

        val ds = rawDF.selectExpr("CAST(value AS STRING)")  //将kafka中的数据的value转为为string,原始为binary类型
                .map(row => {
                    val line = row.getAs[String]("value") //获取row对象中的field,只有一个field
                    val array = line.split(",")  //指定分隔符进行字段切分

                    var rcode = 99
                    var query_type = 99
                    var client_ip = ""
                    var domain = ""
                    var time = ""
                    var target_ip = ""
                    var authority_record = ""
                    var add_msg = ""
                    var dns_ip = ""
                    try {
                        if (array(4).length == 1) rcode = array(4).toInt
                        if (!array(5).equals("")) query_type = array(5).toInt //制造可能的数据异常
                        client_ip = array(0)
                        domain = array(1)
                        time = array(2)
                        target_ip = array(3)
                        authority_record = array(6)
                        add_msg = array(7)
                        dns_ip = array(8)
                    } catch {
                        case e:Exception => {
                            println(line,e) //捕获异常数据异常情况
                            if (args(0).equals("0")) System.exit(-1) //控制遇到数据异常时,是否退出进程
                        }
                    }
                    (client_ip, domain, time, target_ip, rcode, query_type, authority_record, add_msg, dns_ip)
                }).toDF("client_ip", "domain","time","target_ip","rcode","query_type","authority_record","add_msg","dns_ip") //给裸数据添加字段名

        val query = ds.writeStream
                .outputMode(OutputMode.Append())  //指定数据的写入方式
                .format("org.elasticsearch.spark.sql")  //指定外部输出为ES
                .option("es.nodes","192.168.221.173")
                .option("es.port","9201")
                .option("checkpointLocation","hdfs://192.168.211.106:8020/tmp/spark_checkpoint/SparkFromKafka2ES") /**用来保存offset,用该目录来绑定对应的offset,如果该目录发生改变则程序运行的id会发生变化,类比group.id的变化*/
                .start(args(1)) //指定目标索引

        query.awaitTermination()
    }
}
Flink 代码如下:
package com.anryg.es

import java.util
import org.apache.flink.api.common.eventtime.WatermarkStrategy
import org.apache.flink.api.common.serialization.SimpleStringSchema
import org.apache.flink.api.connector.sink2.SinkWriter
import org.apache.flink.connector.elasticsearch.sink.{Elasticsearch7SinkBuilder, ElasticsearchSink, RequestIndexer}
import org.apache.flink.connector.kafka.source.KafkaSource
import org.apache.flink.connector.kafka.source.enumerator.initializer.OffsetsInitializer
import org.apache.flink.contrib.streaming.state.EmbeddedRocksDBStateBackend
import org.apache.flink.streaming.api.CheckpointingMode
import org.apache.flink.streaming.api.environment.CheckpointConfig.ExternalizedCheckpointCleanup
import org.apache.flink.streaming.api.scala.StreamExecutionEnvironment
import org.apache.http.HttpHost
import org.elasticsearch.client.Requests


/**
  * @DESC: 通过Flink DataStream API读取kafka数据,写入到ES,测试 checkpointmode 不同语义下,数据恢复的情况
  * @Auther: Anryg
  * @Date: 2024/4/16 17:05
  */
object FlinkDSFromKafka2ES {

    /**
      * @DESC: 设置checkpoint的mode
      * */
    private def setCheckpointMode(env:StreamExecutionEnvironment, mode:String): Unit ={
        if (mode.equals("1")) env.enableCheckpointing(10000, CheckpointingMode.EXACTLY_ONCE)
        else env.enableCheckpointing(10000, CheckpointingMode.AT_LEAST_ONCE)
    }

    def main(args: Array[String]): Unit = {
        //获取流任务的环境变量
        val env = StreamExecutionEnvironment.getExecutionEnvironment

        /**通过参数控制用哪种语义*/
        setCheckpointMode(env, args(0)) //设置checkpointmode

        env.setStateBackend(new EmbeddedRocksDBStateBackend(true)) //新的设置state backend的方式
        env.getCheckpointConfig.setCheckpointStorage("hdfs://192.168.211.106:8020/tmp/flink_checkpoint/FlinkDSFromKafka2ES") //设置checkpoint的hdfs目录
        env.getCheckpointConfig.setExternalizedCheckpointCleanup(ExternalizedCheckpointCleanup.RETAIN_ON_CANCELLATION) //设置checkpoint记录的保留策略

        import org.apache.flink.streaming.api.scala._  //引入隐式转换函数,需要将从kafka读出来的数据做隐式转换

        val kafkaSourceBuilder = KafkaSource.builder()
            .setBootstrapServers("192.168.211.107:6667")
            .setTopics("test")
            .setGroupId("FlinkDSFromKafka2ES")
            .setStartingOffsets(OffsetsInitializer.timestamp(1713182435000L)) //指定消费的时间戳
            .setValueOnlyDeserializer(new SimpleStringSchema())

        import org.apache.flink.streaming.api.scala._  //引入隐式转换函数,需要将从kafka读出来的数据做隐式转换

        /**读取数据源生成DataStream对象*/
        val kafkaDS = env.fromSource[String](kafkaSourceBuilder.build(), WatermarkStrategy.noWatermarks(),"kafka-data")

        val builder = new Elasticsearch7SinkBuilder()
            .setBulkFlushMaxActions(args(1).toInt) //批写入大小
            .setHosts(new HttpHost("192.168.221.173",9201,"http"))
            .setEmitter((element:String, context:SinkWriter.Context, indexer: RequestIndexer) =>{

                val array = element.split(",")

                var rcode = 99
                var query_type = 99
                var client_ip = ""
                var domain = ""
                var time = ""
                var target_ip = ""
                var authority_record = ""
                var add_msg = ""
                var dns_ip = ""
                try {
                    if (array(4).length == 1) rcode = array(4).toInt
                    if (!array(5).equals("")) query_type = array(5).toInt  //制造可能的数据异常
                    client_ip = array(0)
                    domain = array(1)
                    time = array(2)
                    target_ip = array(3)
                    authority_record = array(6)
                    add_msg = array(7)
                    dns_ip = array(8)
                } catch {
                    case e:Exception => {
                        println( element,e) //捕获异常数据异常情况
                        if (args(2).equals("0")) System.exit(-1) //控制遇到数据异常时,是否退出进程
                    }
                }

                val map = new util.HashMap[String,String]() /**必须是Java的map类型*/
                map.put("client_ip", client_ip)
                map.put("domain", domain)
                map.put("time", time)
                map.put("target_ip", target_ip)
                map.put("rcode", rcode.toString)
                map.put("query_type", query_type.toString)
                map.put("authority_record", authority_record)
                map.put("add_msg", add_msg)
                map.put("dns_ip", dns_ip)

                val indexRequest = Requests.indexRequest()
                    .index(args(3)) /**目标索引*/
                    .source(map)

                indexer.add(indexRequest)
            }
            ).build()

        kafkaDS.sinkTo(builder.asInstanceOf[ElasticsearchSink[String]])/**这里需要进行强制转换*/

        env.execute() //启动任务,action按钮
    }
}
从这两者的代码对比可以发现,除了 Spark 跟 Flink 框架部分代码不同之外,它们的数据处理逻辑,为了对比公平,是一毛一样的。
1. 基准测试
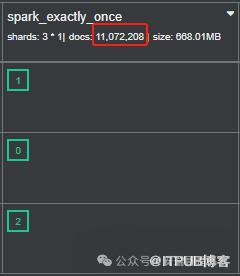
一开始呢,为了确保上面这两部分的代码逻辑没有问题,咱先各自都「正常」跑一遍,把前面推入到 Kafka 的所有数据,都写入到2个作为参照的基准 ES 索引里。
一顿嘎嘎操作之后,Spark 代码写到 ES 索引的数据量如下:
Flink 代码写入到 ES 索引的数据量如下:
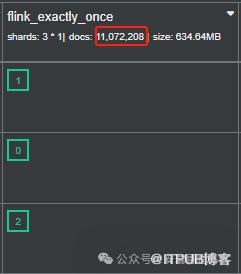
可以看到,Spark 跟 Flink 各自写入的基准 ES 索引数据量一致,且都跟原始数据量一样,证明上面各自的代码逻辑都没有问题。
那么接下来,咱们 PK 正式开始。
2. Spark 的精确一次性测试
虽然 Spark structed streaming 并没有设置所谓「精确一次性」的参数,但是,它对流式任务,是有实实在在状态记录的,咱们可以从实践中来验证,它在这一块的表现如何。
从以上的 Spark 代码可以看到,我专门预留了一个任务启动时的参数,用来控制在数据处理时,遇到处理异常,是否退出进程。

至于这个异常呢,我专门根据数据的特点,造了一个。
在第一次做基准测试的时候,是没有退出的,因为我通过参数控制了进程只是单纯的「try...catch」,所以数据能全部完整地写到 上面的 ES 索引里,这个不难理解。
那么这一次,咱不装了,把这个退出逻辑打开,当遇到数据处理异常时,进程就会直接退出。
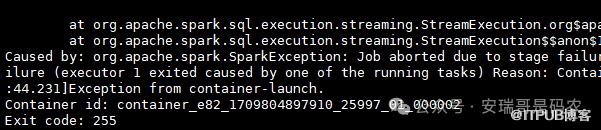
果然,程序运行不到一会,程序就因为捕获到提前设置好的异常,挂了。
此时,写入到 ES 索引的数据量为:
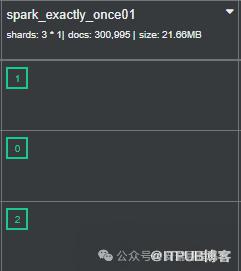
才写入三十多万数据量,挂真够快的。
那么此时,我们再通过代码中设置的「checkpoint」来恢复,而对于 Spark 来说,通过状态来恢复数据,是不需要你做任何额外操作的。
当然,这个时候,需要通过参数来控制不要让进程退出,这样才能保证剩下的 Kafka 数据能全部写入到 ES 里(把提交任务时的 0 参数改为其他任何值)。
把剩下的数据再次写入到 ES,最后,得到的总数据量如下:
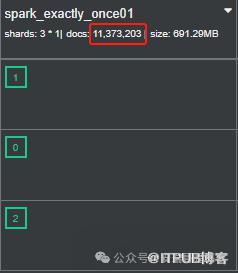
从结果来看,它比基准数据量多了 300995 条,居然跟第一次任务失败前的数据量一样多。
说明什么?
说明当前的任务在失败前,一次有效的 checkpoint 都没有来得及做,且对于 Spark 来说,它是不能像 Flink 那样,手动控制 checkpoint 时间间隔的,这点体验不好。
3. Flink 精确一次性测试
由于跟 Spark 的数据处理逻辑完全一样,所以 Flink 的代码,也同样可以通过参数来控制遇到数据问题,进程是否退出。
同样地,第一次,我们把进程遇到处理异常就退出的开关打开,很快,程序就挂了。
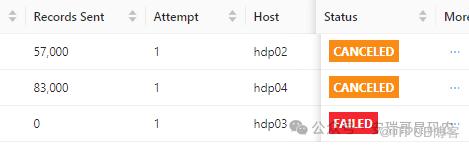
此时,写入到 ES 的数据量为:
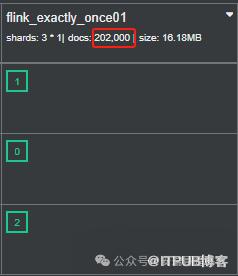
相比于 Spark,挂得更快,写入的量要更少一点。
然后,我们通过它的 checkpoint 进行恢复,再次把剩下的数据写入到 ES。
得到最终的数据总量为:
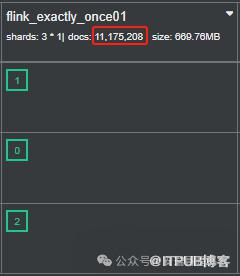
跟基准的数据量比,多出了整整 103000 条(用的精确一次性语义)。
虽然量也是多了,但是相比上面 Spark 的整个数据重复,体验要更好一些。
4. 如何保证一致性
在上面的测试中可以看出来,仅仅通过计算引擎端的参数设置,最终结果,是不可能达到「精确一次性」的。
但好在,它只是让「部分数据重复」,而没有丢失,而对于一个现实中的场景来说,我们只需要保证数据的「最终一次性」就够了,既然这样,那就好办了。
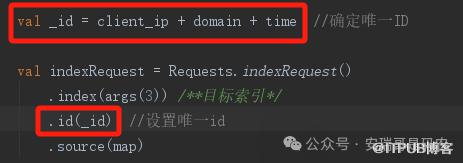
上次在直播的时候其实已经演示过,因为我们是要避免最终写入到 ES 数据的重复,那么最简单,最务实的办法就是:「设置唯一id」,这样一来,即便程序恢复时,读取数据源时,出现了数据重复,但写入 ES 后,也会因为这个唯一 id,将重复数据覆盖掉。
具体的做法如下。
对于 Flink 来说:
对于 Spark 来说:

最终,所有数据写入到 ES 的数据量如下:
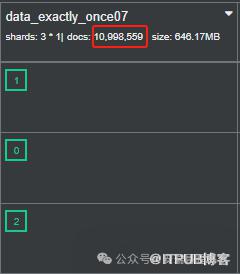
可能你会好奇,咦... 怎么跟基准数据量比,它变少了呢?
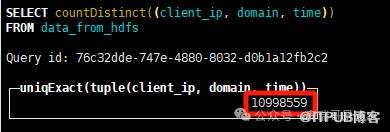
原因很简单,因为通过(client_ip,domain,time)这个组合设置的 id,也出现了部分数据的重复。
通过下面去重 SQL 的验证,也确实证实了这一点:
小结
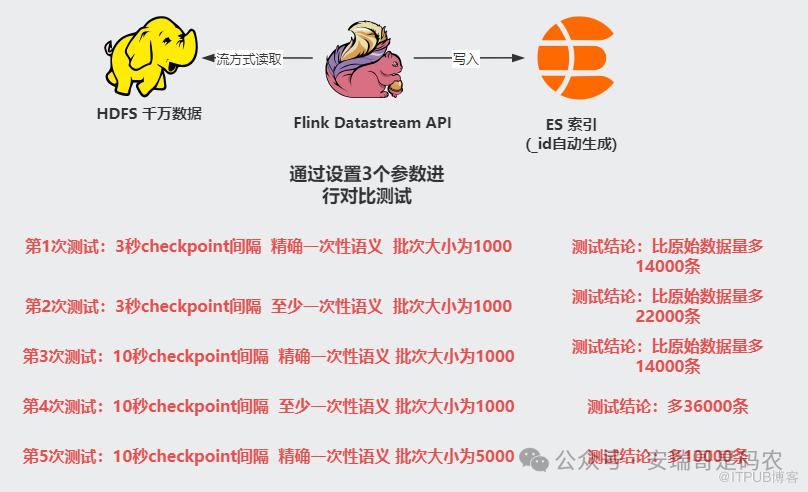
这次测试,没有去通过不同的参数组合来做对比,因为上周末的时候,已经在直播的时候干了这件事。
本来以为,通过缩小 Flink 的 checkpoint 时间间隔,可以有效减少数据重复的量,但是从直播时的实践来看,并不完全是这样。
下面是当时直播测试时,对比不同参数得出的数据重复量结论:
最后想说,不要去轻易相信任何一个框架给你的「承诺」,合理怀疑,亲自验证,根据实际情况,设置多重保险,才是解决问题的最佳方式。

原文作者:安瑞哥是码农;如有侵权,请联系管理员删除。

