上篇文章写了怎么样将字段数量不确定,且有着嵌套关系的 json 用 Spark RDD API 给写入到 Elasticsearch,并且满足了对 json 内部这些不确定 key,以及嵌套 key 的查询。
后面我又突然一想,诶... 既然 Spark 能够满足这种 json 数据的写入,那 Flink 是不是应该也可以满足?
本着试一试,比一比的心态,那就来吧,说不定对有些小伙伴有用呢。
0. 技术准备
我们知道,用 Flink,当下都会有两套 API 可以选择,一个是 SQL API,另一个则是 DataStream API。
但是,从官网给出的,SQL API 对 json 的功能介绍来看,
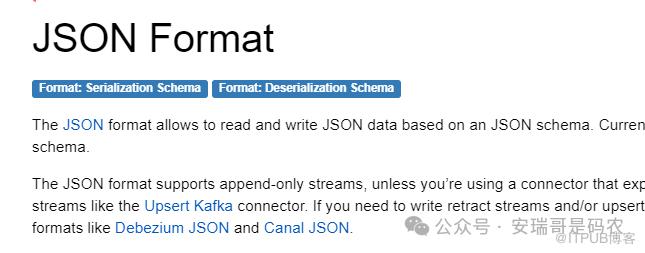
很遗憾,对于一个有着嵌套关系,且内部 key 不确定的 json 来说,目前的 Flink SQL API 是无能为力的。
一者,它不能提供对嵌套 json 的进一步解析;
二者,它也不能根据 json 内部,可能变化的 key 随时调整 create table 语句中的字段数量。
既然这条便利的通道已经被堵死,那么现在就只有 DataStream API 这一条路可走,对于 DataStream API 而言。
它最大的缺点就是:需要你用代码,完整实现所有的数据处理逻辑, 对编码要求比较高;
而优点则是:你能以最细粒度的方式,对数据进行控制。
1. 编码
废话少唠,下面就是我已经调试通过的 Flink DataStream API。
package com.anryg.es

import java.sql.Date
import java.text.SimpleDateFormat
import java.util
import java.util.Locale

import com.alibaba.fastjson.{JSON, JSONObject, JSONValidator}
import org.apache.flink.api.common.eventtime.WatermarkStrategy
import org.apache.flink.api.common.restartstrategy.RestartStrategies
import org.apache.flink.api.common.serialization.SimpleStringSchema
import org.apache.flink.api.connector.sink2.SinkWriter
import org.apache.flink.connector.elasticsearch.sink.{Elasticsearch7SinkBuilder, ElasticsearchSink, RequestIndexer}
import org.apache.flink.connector.kafka.source.KafkaSource
import org.apache.flink.connector.kafka.source.enumerator.initializer.OffsetsInitializer
import org.apache.flink.contrib.streaming.state.EmbeddedRocksDBStateBackend
import org.apache.flink.streaming.api.CheckpointingMode
import org.apache.flink.streaming.api.environment.CheckpointConfig.ExternalizedCheckpointCleanup
import org.apache.flink.streaming.api.scala.StreamExecutionEnvironment
import org.apache.http.HttpHost
import org.elasticsearch.client.Requests

/**
  * @DESC: Flink 处理 schema-free 的 json,然后写入 ES
  * @Auther: Anryg
  * @Date: 2024/4/30 10:32
  */
object FlinkDSFromJson2ES {

    def main(args: Array[String]): Unit = {
        //获取流任务的环境变量
        val env = StreamExecutionEnvironment.getExecutionEnvironment

        env.enableCheckpointing(10000, CheckpointingMode.AT_LEAST_ONCE)

        env.setStateBackend(new EmbeddedRocksDBStateBackend(true)) //新的设置state backend的方式
        env.getCheckpointConfig.setCheckpointStorage("hdfs://192.168.211.106:8020/tmp/flink_checkpoint/FlinkDSFromJson2ES") //设置checkpoint的hdfs目录
        env.setRestartStrategy(RestartStrategies.noRestart())//遇到报错不让它重试,默认会重试
        env.getCheckpointConfig.setExternalizedCheckpointCleanup(ExternalizedCheckpointCleanup.RETAIN_ON_CANCELLATION) //设置checkpoint记录的保留策略

        val kafkaSourceBuilder = KafkaSource.builder()
            .setBootstrapServers("192.168.211.107:6667")
            .setTopics("test")
            .setGroupId("FlinkDSFromJson2ES")
            .setStartingOffsets(OffsetsInitializer.timestamp(1714451518000L)) //指定消费的时间戳
            .setValueOnlyDeserializer(new SimpleStringSchema())

        import org.apache.flink.streaming.api.scala._  //引入隐式转换函数,需要将从kafka读出来的数据做隐式转换

        /**读取数据源生成DataStream对象*/
        val kafkaDS = env.fromSource[String](kafkaSourceBuilder.build(), WatermarkStrategy.noWatermarks(),"kafka-data")

        import scala.collection.JavaConversions._ /**不引人会导致下面对json for循环识别不了*/

        val esSink = new Elasticsearch7SinkBuilder()
            //.setBulkFlushMaxActions(args(1).toInt) //批写入大小
            .setHosts(new HttpHost("192.168.221.173",9201,"http"))
            .setEmitter((element:String, context:SinkWriter.Context, indexer: RequestIndexer) => {
                val map = new util.HashMap[String,String](8) /**用来存储写入ES的目标数据,必须是Java的map类型*/
                val time = context.timestamp()
                map.put("time", new SimpleDateFormat("yyyy-MM-dd HH:mm:ss", Locale.CHINA).format(new Date(time)))

                /**判断确定当前的detail信息,是否可以转换为标准的json格式,不要用,会过滤掉太多是json的数据*/
                //val ifJson = JSONValidator.from(element).validate()

                if (!element.contains("DOCTYPE HTML PUBLIC")) { /**过滤掉个别脏数据*/
                    var detailJson = new JSONObject()
                    try {
                        detailJson = JSON.parseObject(element)
                    } catch {
                        case e: Exception => {
                            println("999999: " + element, e) /**打印脏数据*/
                            System.exit(-1)/**遇错退出*/
                        }
                    }
                    for (set <- detailJson.entrySet()) {
                        val key = set.getKey
                        val value = set.getValue.toString
                        if (key.equals("data")) {
                            if (!value.trim.equals("[]")) {
                                val dataJson = JSON.parseObject(JSON.parseArray(value).getString(0))
                                for (kv <- dataJson.entrySet()) {/** 用这种方式来提取嵌套的json,以及其中不确定的key */
                                    val k = kv.getKey
                                    val v = kv.getValue
                                    map.put("data." + k, v.toString)
                                }
                            }
                        }
                        else map.put(key, value)
                    }
                }

                val indexRequest = Requests.indexRequest()
                    .index("schema_free_json02") /**目标索引*/
                    .source(map)

                indexer.add(indexRequest)
            }).build()

        kafkaDS.sinkTo(esSink.asInstanceOf[ElasticsearchSink[String]]) /**这里必须要进行强制转换*/

        env.execute() //启动任务,action按钮
    }
}
核心的数据处理逻辑,跟上一篇用 Spark 是一样的。
只不过,根据 API 的要求不同,Spark 可以把处理后的数据,封装成一个 json 对象(其他任何key-value类型的对象也都可以),而 Flink,则只能把最终的结果,封装成一个 Java map。
同时,在代码逻辑中,还有一点需要注意的是,那就是我用的这个阿里的fastjson,里面这个用来验证 json 数据格式的方法 JSONValidator.from(element).validate()。
不好用,从实践来看,会有非常多的误判,所以这里面就没用它,不信你也可以验证一下。
2. 写入结果
代码逻辑没有问题,写入自然就不会有问题。
凑合看2条吧。
第1条:

第2条:
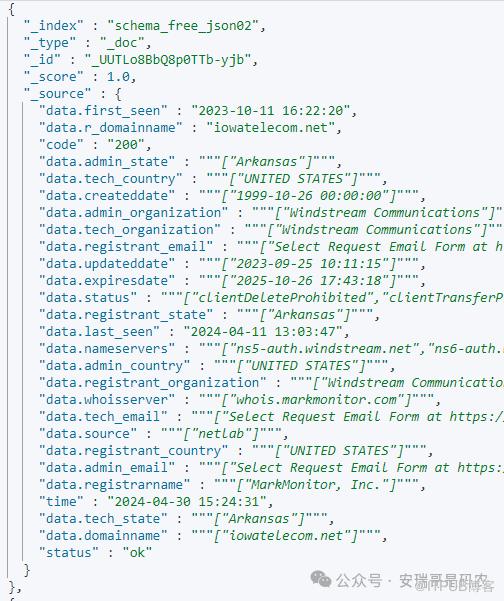
很明显,字段各不一样,说明写入结果符合预期。
至于其他的查询,也都不在话下,跟上篇一样,暂时不演示。
最后
这次没有最后,就这样吧,放假了,大家玩的开心...
原文作者:安瑞哥是码农;如有侵权,请联系管理员删除。

