如果说前面几次用 Doris 基于 json 数据提供的解决方案,只能算比较片面的功能性测试的话,那么这一次,咱就针对一个更加具体的,较大数据文件的存储和查询需求。
看 Doris 可以提供哪些较为完整的解决方案?
从流程上来说,一个数据文件,想要完成从「原始态」,到「可被查询态」的转变,有两个步骤需要走:
第1个:选择合适的数据导入方式;
第2个:设计合理的表结构,来承载后续的查询。
那么接下来,我们就根据这两个步骤,来分别检验 Doris 这款数据库,在面对一份20G的 json 数据文件时,分别在导入跟查询时,能提供的解决方案。
0. 确定需求
就是这么一份 schema- free 的数据文件,里面的每一行,都是一个 json,内容大概长下面这样:

说起来,相比之前几期测试用的 json,这次的结构要更简单一点,不再出现 json array 里,再次包含 json 对象的情况。
总大小为 20G,数据行数为2千万,也就是说,每条 json 大小平均约为 2MB。
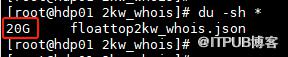
json 文件总大小
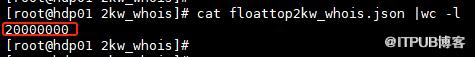
json 文件总条数
对于这份数据的存储,从往前的测试结论来看,存为 Doris 的 variant 类型最为合适。
而至于数据的导入方式,则有下面几种。
1. Doris 提供的 json 文件导入方式
几乎翻遍了 Doris 的官网,目前发现了 2 个靠谱、简单、不需要编码的方式。
1.1 直接的 json 导入方式

这种方式应该是目前为止,最简单的导入方式了(stream load),根据目前表的表结构:
CREATE TABLE `domain_whois_variant` (
  `domain` VARCHAR(100) ,
  `detail_json` VARIANT,
  `create_time` DATETIME
)UNIQUE KEY(`domain`)
DISTRIBUTED BY HASH(`domain`) BUCKETS 3
PROPERTIES (
"replication_allocation" = "tag.location.default: 1"
);
那么对应的 json 文件,跟这张表中3个字段的映射关系设置,就是这样的:
-H "format: json"
-H "jsonpaths: [\"$.sld\", \"$.whois\", \"$.whois.createddate[0]\"]"
-H "columns: domain, detail_json, create_time"
完整的导入命令就是:
curl -v --location-trusted
-u root:xxx
-H "timeout: 3000"
-H "read_json_by_line: true"
-H "format: json"
-H "jsonpaths: [\"$.sld\", \"$.whois\", \"$.whois.createddate[0]\"]"
-H "columns: domain, detail_json, create_time"
-T floattop2kw_whois.json http://192.168.221.173:8030/api/whois_db/domain_whois_variant/_stream_load
虽然上面这些整挺好,但是,命令一运行起来就嗝了:

提示导入文件过大。
那么根据官方文档的解决办法,就是调参数喽。
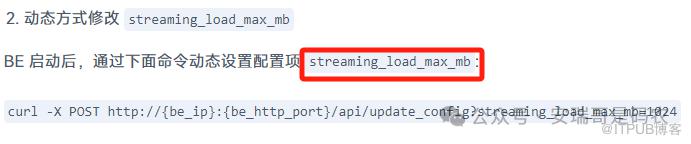
既然这样,那就调大一点(40G总可以了吧):
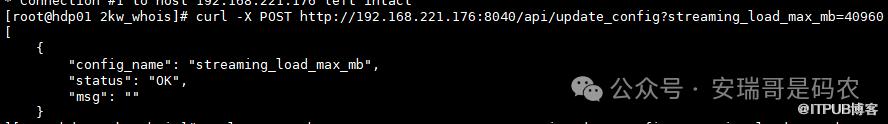
因为集群有3个 BE,所以对应需要执行3个这样的命令。
你别说,你还真别说,这样子好像真的就可以了。
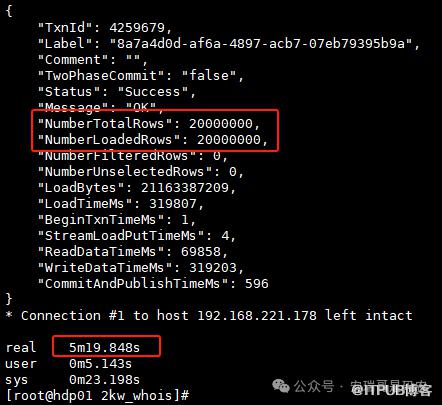
2千万条 json 数据,全部导入成功,耗时为 5分19秒。
这里有个需要注意的地方:
那就是在取这个 json 内部 key createddate 的值时候,如果你指定的 json 路径为 $.whois.createddate,而因为它的值是一个 array,数据是取不出来的(为NULL,按道理说不应该)。

只能改为 $.whois.createddate[0]。
1.2 Broker Load 读取 HDFS 的方式
这种方式相比上面,操作步骤上要稍微麻烦一点,比如需要将数据上传到分布式文件系统 HDFS。
而这种需要提前把数据上传到分布式文件系统,是使用 Broker Load 的前提。
还记得上一次,我用过这种方式把一个8亿+条数据的 Doris 表,给导出到 HDFS,当时因为导出数据量太大,需要手动调整导出时,BE 读数据超时的参数,否则是导出不成功的,不知道这一次也需不需要调整。
首先,把 json 文件上传到 HDFS。

然后,找到官网给的,json 数据的导入案例。

官网提供的导入案例
依葫芦画瓢,编一个我自己的导入任务:
LOAD LABEL whois_db.label001
(
    DATA INFILE("hdfs://192.168.211.106:8020/DATA/2kw_whois/floattop2kw_whois.json")
    INTO TABLE `domain_whois_variant01`
    FORMAT AS "json"
    (domain, detail_json, create_time)
    PROPERTIES(
      "jsonpaths" = "[$.sld, $.whois, $.whois.createddate[0]]"
    )
)
with HDFS
(
  "fs.defaultFS"="hdfs://192.168.211.106:8020",
  "hadoop.username"="hdfs"
);
但是,这个瓢,好像画失败了。
查看导入任务的状态时发现,

这个导入任务,它压根就跑不起来。
一直就告诉你这个 json 路径映射有问题。
我就奇了怪了,这个导入配置,不是照着官方文档的模板抄过来的嘛,咋球不行了呢?
大概盯着这个配置发呆了得有2分钟,也不知道为什么,突然灵光一闪,我就把原本的这个地方:
"jsonpaths" = "[$.sld, $.whois, $.whois.createddate[0]]"
给改成了这个:
"jsonpaths" = "[\"$.sld\", \"$.whois\", \"$.whois.createddate[0]\"]"
然后就可以了。就问如果是你,你想不想骂人(写文档的同学,可上点心吧)?

虽然导入过程没有上一个 stream load 的方式方便,但这个效率明显要更高一些,总耗时2分钟半,效率是 stream load 的2倍多,而且不需要调整任何导入参数。
1.3 暂时没有发现
剩下的就要更麻烦一些了,算球,不试了。
2. 导入结果
先来看一眼这两种分别用 stream load,以及 broker load 方式导入到数据库中表的大小。
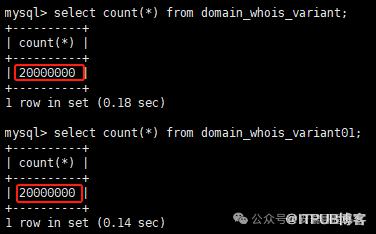
两种导入方式导入的数据量
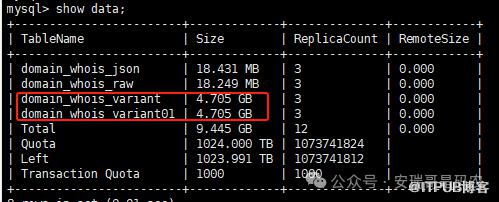
两种方式导入的数据大小
可以看到,20G的原始数据,入库之后,在没有添加任何额外索引的情况下,存储占用只有大概原数据的1/5。
再看一眼写入数据后的表结构:

字段数量由原来的3个,变成了现在的 N 多个(后面还有,没有截全)。
而且可以看到,这里面有很多从 json 中提取出来的新字段都是 Array,但是对于 Doris 来说,官网对于 Array 这个数据类型的功能描述,几乎没有。
这就导致我想要对这些从 json 提取出来的子字段进行条件查询时,不能像其他普通字段一样那样自由。
比如,我虽然可以这样查:

但如果我把查询条件再限制苛刻一点。
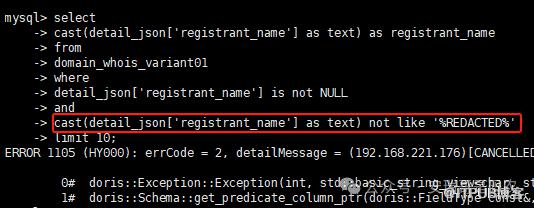
发现就不行了。
综合上次对 variant 的功能测试结论,还是那句话,对于这个数据类型的功能优化,还有待进一步加强。
最后
从这次将一个20G的 json 文件,导入到 Doris 带 variant 类型字段的表需求出发,测试了两种(stream load + broker load)将文件数据,导入到表中的方法。
其中相同点:
1. 两种方法都能满足较大文件数据的导入;
2. 导入效率都还比较高。
不同点:
1. stream load 方式更简单,对导入要求更低,但默认导入文件大小比较小,如果是大文件,需要调整导入参数;
2. broker load 方式,需要将文件先上传到分布式文件系统(比如 HDFS、S3),才能使用,导入效率更高一些,且不用调整参数。
另外,虽然这次导入的数据,json 格式没有之前的复杂,但从查询体验来看,variant 的表现依然有瑕疵,还有进一步优化的空间。
原文作者:安瑞哥是码农;如有侵权,请联系管理员删除。

