我们把知识分为两类,一类是道理类,一类是技能类。资讯类其实很难算作知识。
道理类的知识是被高度(High Level)提炼,其目的是为了传播,让更多的人理解,是一种方向性的指引。但是靠他不能完成任何事情,因为他的高级-就是被抽象、提炼的层级高,靠这些知识完成不了落地。
技能类就是实际要完成这件事情所需要的具体的知识,有理论模型,也有工具来落地。
这两类的知识都是重要的,如果浮在表面那么就要(A+B+C+...),跨知识领域的融合。如果要沉下来,那么就A++++++...,专业纵深学习。建议即便选择了浮在表面的学习,也至少在ABC中,有那么一个+++,或者++。
人工智能(AI)AI目标是使机器能够胜任一些通常需要人类智能才能完成的复杂工作。研究机器人、语言识别、图像识别、自然语言处理和机器学习等。每一个分支都很复杂,譬如机器视觉:指纹识别,人脸识别,视网膜识别,虹膜识别,掌纹识别,专家系统,自动规划,智能搜索,定理证明,博弈,自动程序设计,智能控制,机器人学,语言和图像理解,遗传编程等。有时我们也把譬如《论人工智能未来发展趋势》《人工智能的应用》等文章也作为知识。我们把这些称为道理类,只讲是什么,用来干什么,有多重要等,不会讲如何去落地实现。
我们来看一下具体技能类的知识,讲讲如何实现:
以机器视觉来讲,用机器来模拟人类的视觉。人类视觉系统是大自然的一大奇迹,从最简单的数字识别来看,人类能够毫不费力的识别出数字,我们可能会觉得很简单,其实这是一个幻觉。在我们大脑各半球,有一个主要的视觉皮层,即V1,它包含1.4亿个神经元以及数以百亿的神经元连接。而且人类不只是有V1,还有一系列的视觉皮层——V2,V3,V4和V5,它们能够执行更加复杂的图像处理。通过计算机实现的人工神经元,思路与这个有一点相像。
譬如让计算机程序识别数字,如“9头上有一个圆圈,右下角有一笔竖线”——看起来好像规则明确, 但是识别算法却不是那么简单,因为这些规则会被大量的例外、警告和特殊案例打破,不再像我们严谨的If A then B elese C end if所处理的抽象模型。神经网络思想是利用大量的手写数字(训练样本),开发出一套从训练样本中进行学习的系统。换句话说,神经网络使用样本来自动推理出识别手写数字的规则。通过增加训练样本规模,神经网络能学到手写体的更多规则从而提升它的识别精度。
为了便于理解先看一种人工的神经元,即感知器(perceptron)的基本运作原理。现代的神经网络工作中, 主要的神经网络模型是sigmoid神经元。
一个感知器获取几个二进制输入x1,x2,…,并且产生一个二进制输出。如下例子:
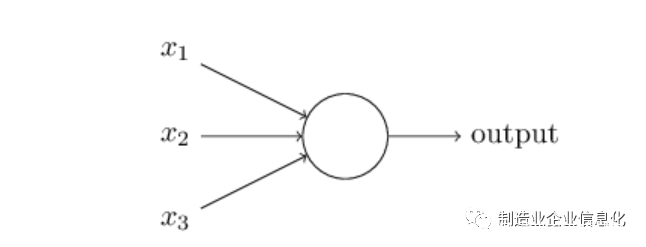
这个感知器具有三个输入x1,x2,x3
。通过一个规则来计算最后输出,即
权重(weights)
w1,w2,…
,这些实数表示各个输入对输出的重要性。这个神经元输出(output)0或者1是由这些输入的加权求和

是否大于或者小于某一个阈值(threshold)。
不像这些权重,
阈值是这个神经元的实数参数
。
代数式
如下:
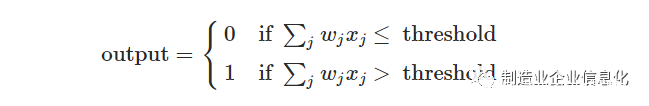
感知器,它是一个通过加权凭据来进行决策的设备。通过更改权重和阈值,我们能得到不同的决策模型。显然,这个感知器不是人类决策的完整模型!
在下面这个网络中,第一列感知器(我们称其为第一层感知器)通过加权输入凭据来做出三个非常简单的决策。那第二列感知器是什么呢?其中每一个感知器都是通过将第一列的决策结果进行加权和来做出自己的决策。通过这种方式,第二层感知器能够比第一层感知器做出更加复杂和抽象层的决策。第三层感知器能做出更加复杂的决策,以此类推,更多层感知器能够进行更加复杂的决策。
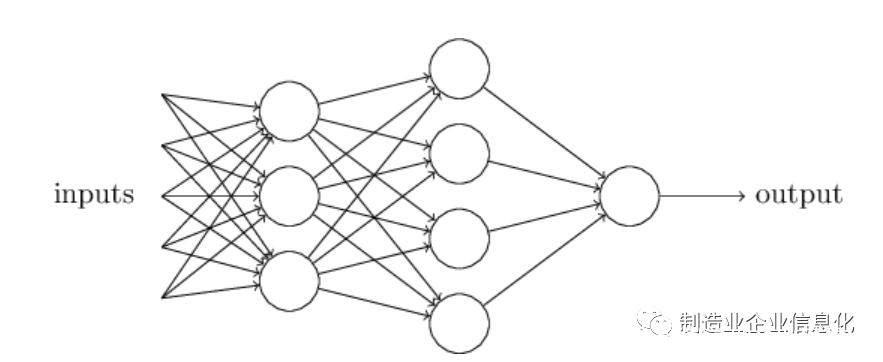
是不是与上面一系列的视觉皮层类似?且你会发现有一个关键问题就是权重和阈值(偏移)的设定,我们会希望这个网络能够学会调权和偏移以便正确决策。
学习算法,这种算法能够自动调整人工神经网络的权重和偏移。这会在响应外部刺激时候发生,而且没有程序员的直接干预。这些学习算法能让我们用一种新的方式使用人工神经网络,它将与传统的逻辑门方法完全不同。
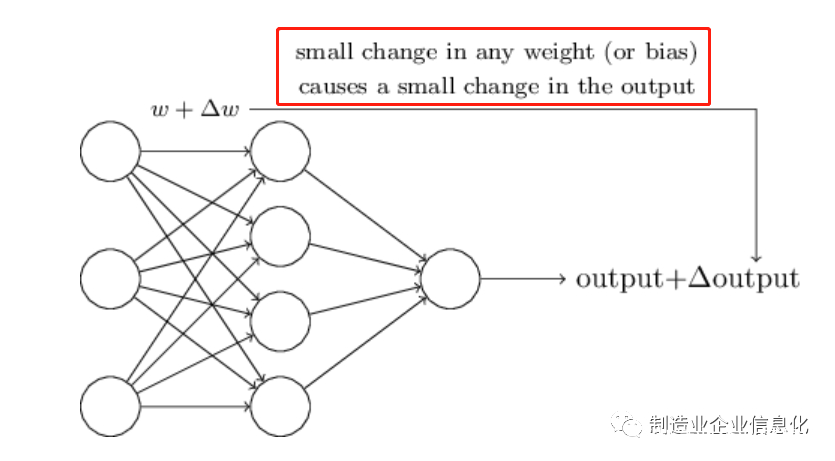
人工神经元(sigmoid神经元)细微调整它的权重和偏移只会很细小地影响到输出结果。sigmoid神经元有输入x1,x2,…。但是输入值不仅是0或者1,还可以是0到1的任意值。微积分告诉我们细小的输出Δoutput近似等于:
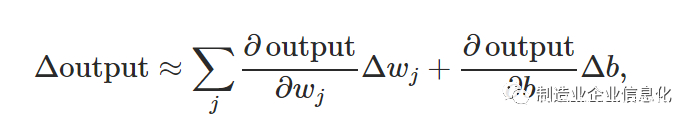
虽然上面具有偏导运算的表达式看起来很复杂,但实际上很简单(这是一个好消息):输出改变Δoutput是权重和偏移改变Δwj和Δb的线性函数。这种线性使得权重和偏移的细微改变就能很容易使得输出按期望方式微小改变。
sigmoid神经元不是只输出0或者1。它能够输出0到1之间任意实数。
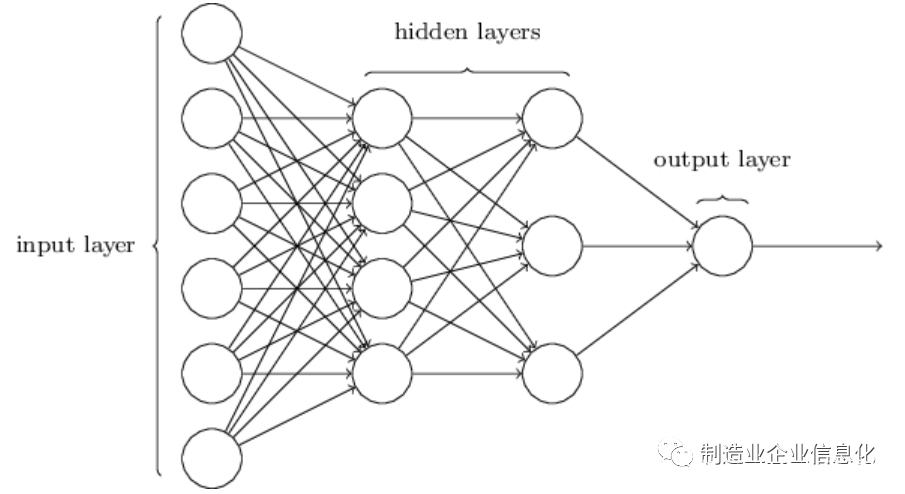
如上面图形中,网络的最左边一层被称为输入层,其中的神经元被称为输入神经元。最右边及输出层包含输出神经元,在上面例子中,只有一个单一的输出神经元。中间层被称为隐含层,因为里面的神经元既不是输入也不是输出。上面的网络只包含了唯一个隐含层,但是一些网络可能有多层。比如,下面的4层网络具有2个隐含层:
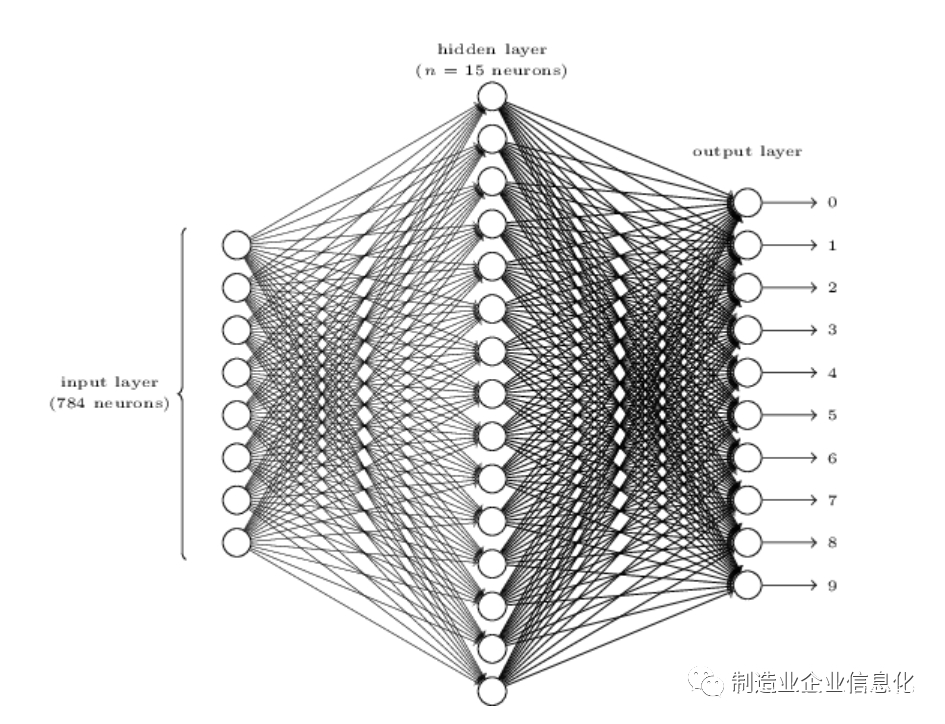
针对图像识别的入门程序, 数字识别的模型,采用的是三层
梯度下降学习算法(gradient descent algorithm)
我们想要的是一个能让我们找到合适的权重和偏移的算法,以便网络输出y(x)能够几乎满足所有训练输入x。为了量化这个匹配度目标,我们定义了一个代价函数:
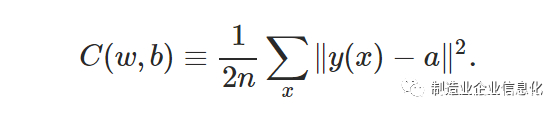
这里w表示网络中的所有权重,b是所有偏移,n训练输入的总数,a是网络输入为x时的输出向量,总和是对所有输入x进行的累加。
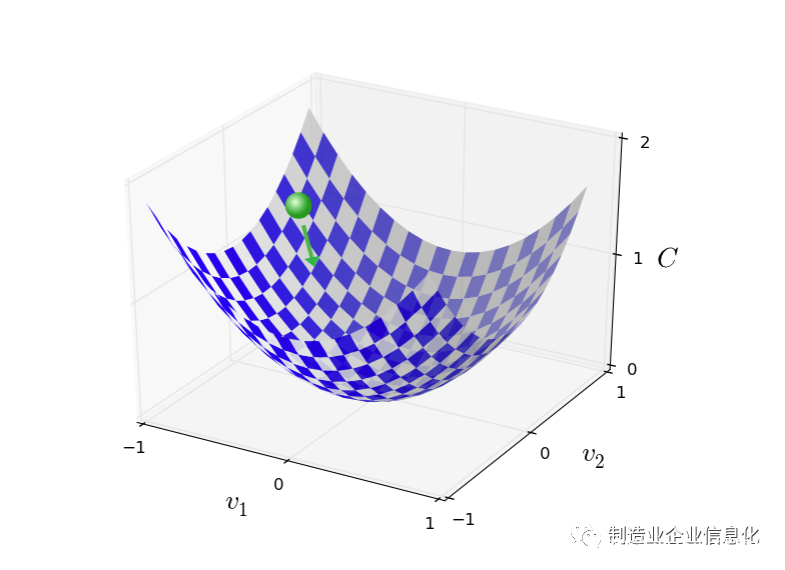
为了最小化C(v),可以把C想象成只具有两个变量,即v1和v2,让我们想象有一个小球沿着山谷的坡面向低处滚。生活经验告诉我们这个小球最终会到达谷底。可以采用类似的思路找到函数的最小值。
我们将“梯度”矢量记为∇C
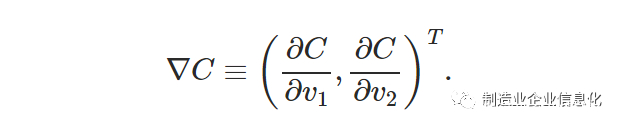
这里 η是一个正的小参数,被称为“学习率”(learning rate)。
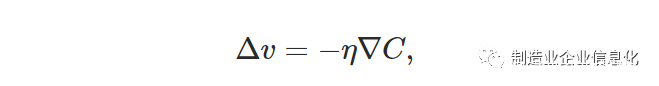
这给了我们一种沿着梯度找到最小值的方法,即使 C依赖于很多变量。即通过不断重复地使用以下更新规则。
总之,梯度下降算法(gradient descent algorithm)是通过不断计算梯度∇C,然后向着梯度相反的方向小步移动的方式让小球不断顺着坡面滑向谷底。
梯度下降如何应用于神经网络的学习过程呢?具体思路是用梯度下降来寻找权重(weights)wk 和 偏移(bias) bl,从而最小化代价函数 。
TensorFlow 是一个用于人工智能的开源神器, 器就是工具,是具体实现的一种技术,我们要落地相应的方案,Tensorflow是个不错的学习方向(推荐)。当然还有很多其他开源工具,如Torch Caffe、OpenCog、Deeplearning4j、Neuroph、OpenNN可以自行搜索学习。
从以上的介绍中,会发现需要一个基本思维就是问题模型化,思路类似,算法不同,譬如线性规划问题的处理路径一般是:
描述目标:****************************
描述约束条件:
-
约束条件1:————
-
约束条件2:————
-
约束条件3:————
定义决策变量:————
构建函数,求解
基于数据样本深度学习算法,用到数据分析、模型与决策等的知识,如微积分,线性规划,非线性最优化模型,数据的分布(尤其是正态分布),决策分析(已知概率、未知概率,风险分析,灵敏度分析,效用理论)等等。这些知识最好是系统化的学习,退一步也可以在应用中按需学习。
在企业信息化建设中,如果要从底层开始搭建人工智能基础,看起来不是一个合适的做法,对于基础云服务的应用相对更合理,但是要学会业务建模,才能跟企业应用深度结合。
推荐两本基础知识的书:
《数据、模型与决策》 戴维R.安德森 等著,侯文华 杨静蕾 等译
《商务与经济统计》 戴维R.安德森 等著,张建华 王建 等译
真正的知识需要沉下来去系统化的学习,很难在公众号学到, 公众号只是一个引子,能够引发思考,带来行为的变化,就够了。
希望我的分享和思考能够对你有一点点价值。
来自 “ ITPUB博客 ” ,链接:https://blog.itpub.net/61939/viewspace-2689341/ ,如需转载,请注明出处,否则将追究法律责任。

