昨天中午在一个小餐馆吃饭,发现老板的儿子和女儿一人一个手机玩的high,爸妈在后厨忙的不亦乐乎。从我进来到离开, 老板的儿子和女儿,眼睛都没离开手机, 姿势换了几个, 低着头, 弓着腰。看着他们入迷的样子, 内心是泛起波澜的。
这张配图来自互联网
疫情期间,儿子上课需要用手机, 聊天工具,娱乐视频,手机游戏,这些都会接触到, 这个年龄的孩子, 对这些很快能上手。孩子其实在这个过程中承受着很大的挑战,能够在手机游戏,娱乐视频“自我节制”,“管理好时间”, 其实很难。到底多难,从我们自己在刷抖音,刷头条,入迷的看某个电视剧,被生硬拽出来的时候有多难,就知道(除非你超级自律,而且以此为傲,灵活驾驭),况且这个阶段的孩子发育还不成熟, 自制力还不强。
这个期间 家长会跟孩子斗智斗勇,时刻盯着孩子玩手机(娱乐app),生怕一不小心孩子搂不住。个中痛苦,经历的人都懂。从长远看,我很难断定未来会怎样,毕竟从我们之前觉得玩游戏是浪费时间,到现在游戏也出现了专业玩家(还可能列为奥运项目)。但是从眼前来看,对孩子的身体和智力成长看不出来什么大的好处。社会就本就是在矛盾中前行,也不必过于焦虑。
尝试了解这些互联网产品背后的逻辑, 也许对我们看待相关事情有一定的帮助。
这张配图来自互联网
有些Kill time的互联网产品包裹上Save time的糖衣:
Kill time:打发时间,消磨时间;Save time:提高效率,省时方便。
仔细想来,我们很多产品,其实本质是在做Save time的事情,譬如汽车,家用电器、机器人 、农机、大型装备等等都属于这个范畴。Save time产品的主要特征是偏工具属性/投入产出比较高或者产出反馈直接/学习型。而Kill time产品的普遍特征,偏重娱乐性较强/投入产出比低或产出偏隐性。
这两种属性对于有的产品而言界限很模糊。抖音可能是大家公认的kill time产品,但对于有些人来说,他们可以从中学到很多自己所需要的知识,短视频的形式使得知识点更加密集更加高频的被用户获取,这么一看,提升效率的抖音算是Save time的产品?
普世的价值观,我们一直接受的是Save time是好的,应该鼓励的, Kill time是不好的,应该被限制的。但我们也不要去否认,Kill time是有需求的,而且是作为一个自然人,其更符合本性的需求,不能假装看不见。从我个人的角度, 我的确更认同普世的价值观,认为这是更积极的人生态度。
从事实来看, Kill time的产品比之Save time产品具有更强的成瘾性,你可能会刷着抖音直到天明,但除非考试,你很难抱着百词斩学习单词直到第二天。这种成瘾性对于互联网公司是无法抗拒的,在这个“注意力经济”时代,成瘾性意味着更多的注意力,更长的使用时长,这就意味着更多的流量,可以安插更多的广告(就是更多钱),更全面的用户数据画像…,这个背后经济的驱动, 是符合经济学理性人假设的。这种成瘾性是普通用户难以抗拒的,著名的奶头乐效应大家应该都听说过,在奶头经济中,“奶嘴”的形式主要有两种:
-
一种是发泄性娱乐,热闹选战造势、无休止的口水战、暴力网络游戏;
-
另一种是满足性娱乐,报导无聊小事(可爱动物、明星丑闻)、廉价品牌横行(自产品牌或引进山寨手机、白牌服饰)、商品优惠活动(例如饰品、旅游签证)、视听娱乐大众化(偶像剧、动画、好莱坞)等。
诱人的奶嘴不仅仅让人心情放松,也提供了与他人聊天沟通的“社交货币”。
Kill time有它的问题, 我们却不能一概否定kill time存在的意义,人们的生活对于娱乐、游戏等需求并不可耻,相反非常值得提倡,很多时候这种需求的满足能提升人的创造力与学习工作效率,具有很强的正向促进作用。那些一听到是娱乐等行为就表现出厌恶、鄙弃态度的人,思维是错误的,是对于自我需求的绝对压抑,是不符合人性的,我们要知道这是合理的存在。
一切的讨论基于一个基准,即使用者应该对自己在做什么有清醒的认知,因此对于未成年人等认知能力尚未成熟的群体,“适当的”管控是必须的,“堵”绝对是错的,社会大势如此,你怎么堵?“疏”- 正确的引导才是正道】。
敲黑板: 【适当的管控】【不可堵,要正确引导】
用户虽然心底里更喜欢Kill time的场景,但是因为自我激励的要求与负罪感的约束,对于Kill time的场景实际上是又爱又恨的。既需要这种消磨时间的场景来让自己获取瞬时的快乐,又忧虑且深知这种快乐不可持久且毫无意义。有些产品抓住这一点,给Kill time内核的产品,套上一层Save time的糖衣,你会发现用下来, 除了消磨了时间, 啥也没学到!
作为普通的用户,我们需要做到的是不被save time的糖衣迷惑,打开背后经济利益驱动的套路,真正清楚自己所做所想的,时代在变,对于自我的认知依然要清晰。
AI的推荐算法,投你所好,是把双刃剑:
简要了解一下基本的推荐逻辑,有利于理解为什么会成瘾。推荐系统往往是多个推荐算法策略的组合使用, 本文从其中一个角度来尝试说明,经济学里面有一个概念叫做消费者偏好,类似的我们看一下相对成熟的算法:基于内容的推荐算法(Content-Based Recommendations CB)如何去理解用户或消费者。
从最简单的实现思路来看:
-
抽取物品(可以是苹果、视频、文章)的一些特征。
-
利用一个用户过去喜欢(及不喜欢)的物品的特征数据,来学习出此用户的喜好特征(profile);这些特征可以用特征向量来表达,最简单可以使用向量的平均值。
-
通过比较用户喜好特征(profile)与候选物品的特征,为此用户推荐一组相关相似性(相似度的衡量可以用余弦相似度Cosine来进行计算)最大的物品
简要看一下用户喜好特征学习:
通过用户U过去的这些喜好判断,为他产生一个模型。有了这个模型,我们就可以根据此模型来判断用户U是否会喜欢一个新的物品。所以,我们要解决的是一个典型的有监督分类问题,理论上机器学习里的分类算法都可以使用。本文主要目的不是为了介绍技术细节, 所以简单列示几个算法:
最近邻方法(简称KNN)
对于这个方法,比较关键的可能就是如何通过item的属性向量计算item之间的两两相似度。对于结构化数据,相似度计算使用欧几里得距离;而如果使用向量空间模型(VSM)来表示item的话,则相似度计算可以使用cosine。
Rocchio算法
Rocchio算法是信息检索中处理相关反馈(Relevance Feedback)的一个著名算法。比如你在搜索引擎里搜“苹果”,当你最开始搜这个词时,搜索引擎不知道你到底是要能吃的水果,还是要不能吃的苹果,所以它往往会尽量呈现给你各种结果。搜索引擎可以通过你刚才给的相关反馈,修改你的查询向量取值,重新计算网页得分,把跟你刚才点击的结果相似的结果排前面。
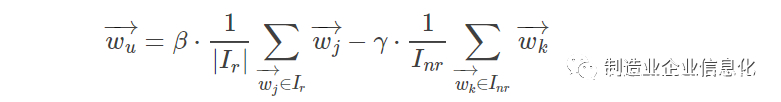
其中 wj 表示物品 j的属性,Ir与 Inr分别表示已知的用户U喜欢与不喜欢的物品集合;而 β 与 γ 为正负反馈的权重,它们的值由系统给定。
决策树算法(Decision Tree,简称DT)
当物品的属性较少而且是结构化属性时,决策树一般会是个好的选择。这种情况下决策树可以产生简单直观、容易让人理解的结果。而且我们可以把决策树的决策过程展示给用户U,告诉他为什么这些物品会被推荐。
线性分类算法(Linear Classifer,简称LC)
对于我们这里的二类问题,线性分类器(LC)尝试在高维空间找一个平面,使得这个平面尽量分开两类点。也就是说,一类点尽可能在平面的某一边,而另一类点尽可能在平面的另一边。就是用平面尽量分开喜欢的和不喜欢的。
素贝叶斯算法(Naive Bayes,简称NB)
NB算法就像它的简称一样,牛逼!NB经常被用来做文本分类,它假设在给定一篇文章的类别后,其中各个词出现的概率相互独立。它的假设虽然很不靠谱,但是它的结果往往惊人地好。再加上NB的代码实现比较简单,所以它往往是很多分类问题里最先被尝试的算法。我们现在的profile learning问题中包括两个类别:用户U喜欢的物品,以及他不喜欢的物品。在给定一个物品的类别后,其各个属性的取值概率互相独立。我们可以利用用户u的历史喜好数据训练NB,之后再用训练好的NB对给定的物品做分类。
随着数据的增加, 其实我们的喜欢的模型会越来越懂我们的偏好,而且不断的推荐你的喜欢,引诱更多的点击;然而有些需要努力学习获取的,对我们真正有益的,却不容易被推荐。如果我们懂了这些算法的原理, 想获取更有价值的信息, 我们应该善用这些工具,驾驭这些工具。
现在的学生,看到这儿就应该知道一定要好好学习数学,打好基础,这些背后的算法更有意思。
希望AI的从业者, 善用所学知识,研发更健康,更有益,符合普世价值观的产品。
来自 “ ITPUB博客 ” ,链接:https://blog.itpub.net/61939/viewspace-2693087/ ,如需转载,请注明出处,否则将追究法律责任。

