Raft概述
文献[1]提出了Raft协议[1],该协议用于管理“replicated log”,作者的原话描述了其本质:作为一个共识(consensus)算法,Raft不是Paxos算法或其变种,但用途相同,且在结果和效率上,与Paxos协议相当;但在易理解和易构建生产系统上,好于Paxos。
Raft is a consensus algorithm for managing a replicated log. It produces a result equivalent to (multi-)Paxos, and it is as efficient as Paxos, but its structure is different from Paxos; this makes Raft more understandable than Paxos and also provides a better foundation for building practical systems.
那么,什么是共识算法呢?共识是具备容错(fault-tolerant)能力的分布式系统中的一个基本问题。共识,指分布的多个参与者就“值(value)”达成一致。一旦参与者对一个值做出决定,这个决定就是最终的。当大多数参与者存活时,共识算法会在存活的参与者间达成值一致,这相当于全部参与者存活时达成的一致,故部分参与者达成的一致是整个系统有效的;因此这也意味着允许分布式系统中,有部分参与者处于非存活状态;这就使得分布式系统具备了一定的容错能力。无论是Paxos及其变种,还是Raft协议,在共识这个目标上,本质相同;只是他们各自的实现方式,存在差异。
Raft算法基础
共识算法通常出现在复制状态机(Repilcated State Machine,RSM[2],可参考文献[2])的上下文中,而复制状态机是构建容错系统的常规方法。一个分布式系统,其复制状态机由多个复制单元组成,每个复制单元均有一个状态机,该状态机的状态保存在状态变量中,这些变量只能通过外部命令(通常通过传输日志作为外部命令的输入源,即日志包含了一系列指令)被改变。备机状态机在日志指令的驱动下,严格按照顺序逐条执行日志中的指令。假定所有的状态机都能按照相同的日志执行指令,则它们最终能达到相同的状态,这就能保证该分布式系统状态的一致性。Raft协议即明确定义了复制状态机,其把共识问题分为三个子部分:
1. Leader选举(Leader election):旧Leader故障时或系统初始化首次需选主,选出一个新的Leader。
2. 日志复制(Log Replication):Leader接受来自客户端的命令/操作指令,并记录为日志,然后复制给集群中的其他服务器即Folloer角色的备机,通过在备机执行日志,使得备机的从副本和Leader的主副本保持一致。日志复制依赖于复制状态机,如图3-4给出了Raft协议带有复制状态机的整体架构,关注图中①到④标识的流程。
3. 安全Safety措施:通过一些措施确保系统的安全性:如确保所有状态机按照相同顺序执行相同命令,即Leader将某个特定index的日志条目交由主机的状态机处理,则对于其他备机,交由备机状态机处理的日志需要具有相同index的日志条目;如“Election Safty”每一个任期内只能有一个Leader等。

图1 复制状态机架构
图1中,①客户端发送执行命令给服务器,②服务器通过共识模块(Consensus
Module)复制日志(replicate log)给每个备机的复制状态机即RSM,每个RSM中replicate log中commads的顺序都是相同的,③RSM按顺序处理replicate log中的command, ④并将处理的结果返回给客户端。由于RSM具有确定性,因此每个状态机的输出和状态都是相同的,因此能保证多个备机的数据处于一致状态。
保持复制日志的一致性是共识模块的工作,该确定的工作由共识算法确保。但是,因为处于分布式系统中,某些服务器会出现故障,因此共识算法需要考虑这些异常的情况。如果与两阶段提交算法即2PC比较,日志复制中共识算法的核心思想等同于2PC算法(文献[3]论述了2PC算法为Paxos算法的变种,2PC类似Paxos的Prepare-Accept阶段),只是Raft需要选取出Leader以相当于2PC中的协调者,Raft在投票时利用了多数派完成投票确认而2PC需要所有参与者都投票确认才能达成共识。这提示我们,Raft算法中的“Leader选举”和“日志复制”其实是Raft协议为应对分布式系统故障而执行的两个过程,这两个过程的正确完成需要Raft的“安全Safety措施”来保证,而这些安全措施是应对分布式系统故障的问题而被提出的。
Raft算法
首先,Raft算法的特点:有一个强Leader,在无分布式系统异常(如节点宕机)的情况下,负责接收客户端的请求命令,并将命令作为日志通过Raft的日志复制功能传输给Follower服务器,Leader在接收到Follower服务器上确认日志安全后(大多数从副本已经将该命令写入日志当中,可未完成Apply),Follower将日志命令提交本机的复制状态机执行(即日志的Apply);这样的过程,是一个正常情况的过程。但是,分布式系统存在发生异常情况的可能,包括:
1. Leader故障:此时需要选举产生一个新的Leader。发生选主需要处理几个事情:
a) 怎么知道Leader出现故障:这依赖心跳机制。从副本(Follower所在的副本)在一段时间内没有收到Leader主副本的心跳(定期的心跳中包括不带log的AppendEntriesRPC),则认为Leader已经出现故障。所以和Leader存活有关的心跳时长即Leader的租约(Leader的有效任期)的长短,是影响系统处理故障时长的一个因素,不能太长(长了则不能尽早发现故障),也不能太短(短了则会触发频繁选主影响效率)。
b) 选主:选主的结果,可能有两种,一是成功选出新的Leader,二是一轮选主失败,需要重新再选,直到选主成功。
i. 选主过程:某个Follower将自己维护的current_term_id加1并转变为Candidate。Candidate发起投票,首先投自己一票,然后向其他所有节点并行发起RequestVote RPC,等待其他节点的回复(收到RequestVote RPC的每个节点只会给发送消息方回投一票),如果收到了大多数(majority)的投票回复后,Candidate状态切成Leader。选主过程是需要在一个election timeout周期(一个不等长的周期,该周期称为一个term)内完成的,且每个term最多只能有一个Leader存在。Term本质上是一个逻辑时钟(logical clock,参考3.2节讨论的逻辑时钟),在每个RPC消息中都会被带上,用于检测过期即超时事件的发生。在选主的过程中,需要注意的细节是RPC消息的发送和接收双方之间需要通过term保持偏序关系;当一个server收到的RPC消息中的rpc_term比本地的current_term大,则更新current_term为rpc_term,且如果当前状态为Leader或者Candidate时,将自己的状态切成Follower(这表明旧主故障发生被探测到需要重新选主);如果rpc_term比本地的current_term小,则拒绝这个RPC消息。
ii. 选主失败:当投票被瓜分(即有多个Candidate发起投票发现投票选主且没有任何一个Candidate收到了多数派回复),则不会有Leader被选出。此后Candidates需将本地的current_term加1,发起新一轮的选主过程。但是,下一轮选主还可能失败,为了避免这样的问题,每个Candidate的election timeout从150ms-300ms之间随机取,如此第一个超时的Candidate就可以发起新一轮的选主,其可带着最大的term值给其它所有节点发送RequestVoteRPC消息,从而有助于自己成为Leader。这样的操作方式称为“随机选举超时(randomize election timeouts)”。
c) 如上过程提及了两种消息:
i. RequestVote RPC:选主过程中由Candidate发出,用于拉取选票。
ii. AppendEntries RPC:正常运行过程中,由Leader发起,用于复制日志或者发送心跳信号。
2. 复制失败:在Leader正常工作期间,如果某个Follower出现问题(宕机、或者运行的很慢,或者网络丢包),Leader将一直给这个Follower发AppendEntriesRPC直到日志一致。。
3. 日志不一致:新主被选出后,可能旧主所记录的日志没有完全被复制,因此会造成所有节点上日志不一致的情况;有的Follower相比于当前的Leader可能会丢失几条日志,也可能会额外多出几条日志,且这种情况可能会持续几个term。
a) 日志顺序:日志复制时,严格按照顺序推进,如图3-6,log index表示了Leader上产生的日志顺序,在Follower上其得到的日志项严格按照Leader上的顺序获得,所以图3-6的每一个列,在Follower上要么没有要么与Leader上的同样的列值相同。具体做法如下:Leader在进行AppendEntry RPCs的时候,消息中会携带preLogIndex和preLogTerm两个信息,Follower收到消息的时候,需要判断它最新日志项的index和term是否和rpc中的一样,如果一样则append。
b) 新主和Follower日志不一致:在新主产生后,新Leader和Follower之间的日志项可能不一样。如图3-7(框内的数字是term编号),作为Follower的“a和b”,少了一部分命令,“c和d”多了一部分命令,“e和f”上的命令和Leader存在较大不同有丢失也有增多。例如,Follower的“f”,可能发生的情况为:f节点在term为2时是Leader,写入了几条命令,然后在提交之前崩溃了;之后term 3时,该节点快速重启并再次被选为Leader,又写入了几条日志,在提交前又崩溃;等该节点重启加入Raft组后,新的Leader被选出,“f”节点就形成了图3-7中的情形。遇到这种情况,Leader将强制Follower复制自己的日志,使得日志保持一致。
c) 提交日志被误删除:当某个Follower在Leader提交时宕机了,该Follower会少若干条命令,然后它重启加入Raft组后又被选为新的Leader,该新Leader将强制其他Follower跟自己保持一致,这就会让其他节点上刚刚提交的命令被删除,此举会导致客户端提交的一些命令被丢失,该问题需要被避免。避免方式是在选举过程中加一个限制条件:确保投票过程只有拥有全部已提交日志的Candidate才能成为新Leader。
d) 提交接力:一个Leader如果把命令已经复制到了大部分节点上,但是还没来的及提交就崩溃,后选出的新Leader应该完成之前term期内未完成的提交。Raft让新Leader统计之前的term内还未提交的命令但已经被复制的个数如超过多数派, 则新Leader组织进行提交。
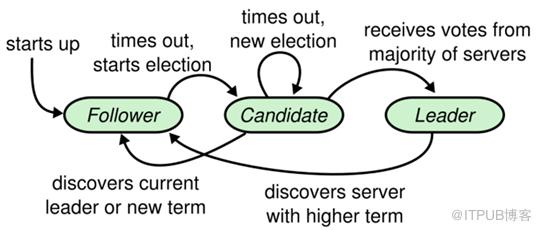
图2 Raft算法状态机角色转换图—分布式系统异常处理
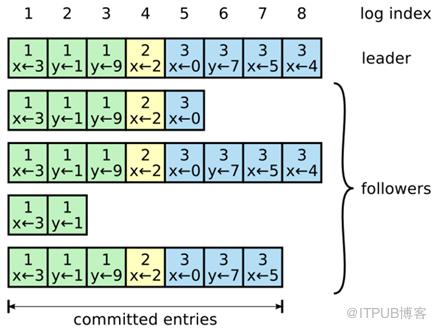
图3 日志复制的日志顺序图
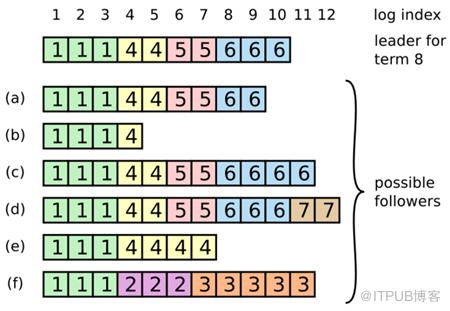
图4 新主产生,日志不一致图
另外,需要注意的是,Raft算法启动的时机:当上层(调用Raft的业务层)发出一条提交日志commited时,Leader才可以将相关日志(一个完整的日志单位,从开始到提交)应用到状态机中(注意是应用不是传输,所有的日志都是要传输的,但被传输的日志未必被应用只有在收到提交日志项时才能被应用)。Raft的复制状态机需要保证一条commited的日志项已经持久化了并且会被所有的节点执行完成。
除此外,Raft还支持日志压缩功能等其他的一些细节,本节不再赘述,详情参见文献[1]。
Paxos与Raft的比较
本节从多个层面对Paxos与Raft进行一个对比,如表1至4。
表1 算法宏观层面对比
对比项 |
Paxos |
Raft |
目标 |
就某个“值”达成共识 |
同左 |
难点 |
分布式系统中存在各种异常情况 |
同左 |
算法思路 |
半数以上参与者认可“值”则可达成共识 |
同左 |
算法框架 |
依赖于RSM(本质上是一个有限状态自动机) |
同左 |
算法阶段 |
从一个提案被提出到被接受分为两个阶段,第一个阶段“Phase 1”去询问值(类似选Leader过程),第二阶段“Phase 2”根据询问的结果提出值,其行为表现出类似2PC的两个子阶段 |
在Leader被选出后,其行为表现出类似2PC的两个子阶段 |
表2 基本角色与概念对比
对比项 |
Paxos |
Raft |
Leader/Candidate/Follower角色 |
任务执行期内:需要一个领导者,受到所有参与者信任; 但没有明确用Leader/Candidate /Follower角色对应状态机,对于Paxos,这些角色中,Leader只是一个概念上的逻辑存在,Candidate /Follower角色不存在 |
任务执行期内:需要一个领导者,受到所有参与者信任; 明确用Leader/Candidate /Follower角色对应状态机 |
Proposer/Acceptor/Learner角色 |
Paxos独有。但要区分选主或执行Client的任务场景;一旦要执行Client的任务,则通常意味着Proposer已经成为了Leader |
逻辑上有这样的角色,但Raft直接与状态机挂钩;Raft用Candidate表示选主阶段的Paxos的几个角色,但更多时候对应Paxos的Proposer角色 |
Leader存活期 |
一个Leader有一个任期。如果认为现任Leader有故障,触发选主,新Leader进入新任期,必须大于前一任期。Leader存活期称为Proposal Number (PN) ,Leader一定只有一个,且其PN值最大 |
同左。Leader存活期称为Term,即任期 |
谁可成为Leader |
Paxos允许任何角色成为Leader。新Leader需要了解其他角色的日志情况,带来复杂性 |
Term值只允许递增,Leader一定只有一个,且其term值最大; 成为Leader者需拥有以前term中的所有已提交日志,这保证了Leader可以简单地在其他Follower上“强加”其日志(把重新选主后的日志复制简单化) |
Leader任期连任 |
Basic-Paxos:只一个任期 Multi-Paxos:可续租连任 |
续租连任 |
确认值的过程 |
通过Prepare提议阶段、Accept批准阶段进行 |
通过Leader/Follower角色进行 |
达成共识 |
Value is Chosen(值被选定/形成决议),Paxos称为提案被决定,Multi-Paxos中叫proposer-id,proposer-id最大的Leader提出的决议才有效 |
Commit(显式提供提交操作项),Raft称为日志被提交。达成共识在Raft中叫做Term,协议中Term最大的Leader才是合法的 |
日志 |
一系列ID递增的Paxos Instance对应一系列日志,被Paxos称为提案 |
Raft称为日志,用Log Entry表示 |
日志项的连续 |
日志项可不连续,允许空洞 |
被接收的日志项必须是连续的,不允许有空洞出现 |
表3 算法重点项对比
对比项 |
Paxos |
Raft |
值形成决议的必要条件 |
Acceptor形成多数派后,接受该提议的值 |
两种情况: 1 直接 Commit:形成多数派后,可commit,即Term等于currentTerm的log entry 2 间接Commit:适用的场景为,新 Leader 当选:对于非当前Term的Log Entry,形成多数派不代表决议已经Commit。而是通过新Leader上任后做出的一个直接commit(提交一个本term的no-op 日志),让更早的Log entry被间接commit(一次性Commit了commit Index 及之前所有的Log entry) |
实例(即日志项)的决议处理方式 |
日志项无顺序关系,允许空洞出现 |
日志项之间有两种顺序依赖关系: 1 接收时的前向依赖:不允许有空洞 2 Commit时的后向依赖:新Leader当选后,直到有currentTerm的log被commit,才会让其当选前未commit 的Log entry变为committed。即新Leader当选后不允许之前旧Leader应提交的日志项对应的位置处有空洞 |
未形成的决议的处理方式 |
使用自己的新PN,对所有未形成决议的实例执行Phase 1以确定它们是否可以被提交;之后使用最大的value或者no-op进行Phase 2,以尽快解决空洞,新Leader可能缺失可以被提交的日志,需要向一个多数派询问以学习到缺失的可以被提交的日志 |
Leader 采用旧term推送的自己已经持久化的 log给Follower,待Follower补齐日志后,才会用新Term执行自己当选后发起的 AppendEntry |
无 Leader 情况 |
仍然能保证单个实例的 Consensus |
必须有Leader才能对外提供服务 |
需要持久化的内容 |
MaxAccepted PN、各个 LogEntry |
currentTerm、VotedFor(与currentTerm对应)、 各个Log Entry |
表4 算法安全性对比
对比项 |
Paxos |
Raft |
当选安全(Election Safety) |
一个周期内只有一个Leader |
同左 |
服务器从比其当前版本更早的“周期”获得消息(旧主发出的消息) |
丢弃旧消息 |
丢弃旧消息 |
服务器从一个大于当前的“周期”获得消息,这意味着一个新Leader开始了一个新“周期”,接收者必须开始接受新Leader的命令 |
接受新消息 |
接受新消息 |
State Machine Safety |
如果服务器已将给定位置的日志项应用于其状态机,则其他服务器不可以在同一位置应用不同的日志项 |
脚注参考:
[1] Raft论文和作者汇报的视频地址:https://www.usenix.org/node/184041
[2] Consensus protocols are the basis for the state machine replication approach to distributed computing, as suggested by Leslie Lamport and surveyed by Fred Schneider. https://en.wikipedia.org/wiki/Paxos_(computer_science)。
文献参考:
[1] Diego Ongaro, John K. Ousterhout: In Search of an Understandable Consensus Algorithm. USENIX Annual Technical Conference 2014: 305-319
[2] Fred B. Schneider: Implementing Fault-Tolerant Services Using the State Machine Approach: A Tutorial. ACM Comput. Surv. 22(4): 299-319 (1990)
[3] Jim Gray and Leslie Lamport. “Consensus on transaction commit”. ACM TODS 31.1 (Mar. 2006), pp. 133–160.

扫码加关注,知数行云,专业有深度
声明:本文禁止用于开发“任何软件程序,包括但不限于训练机器学习或人工智能(AI)系统”。
原文作者:那海蓝蓝知数行云;如有侵权,请联系管理员删除。

