再谈一致性
《分布式原理》系列,谈及了分布式原理相关内容,主要是分布式问题的相关解法,或称为算法。但是,在理解掌握这些算法之前,先行理解问题更为重要。在分布式系统中,尽管存在多种问题,但CAP指出,C和A是核心问题;PACELC则进一步提出L(延时,latency)也是一个需要重点考虑的问题。
在分布式数据库中,尤其是事务型分布式数据库中,C、A、L三个则更加突出,因为C不只是CAP的C还混合了ACID的C,这使得问题更加复杂化,且使得C更为突出。
之前,我们讨论了各种一致性,如:CAP(参考:《分布式原理--CAP始末(上)》和《分布式原理--CAP始末(下)》)和在《分布式原理(2)--分布式环境下的各种一致性,也在《第三代分布式数据库(4)——为什么要100%保证数据的正确性?(上)》中提出一致性的24字问题:
一致领域存在诸多的问题,他们可以用“一致性24字问题”加以概括:
1. 范围不清:是从整体上描述数据正确性问题存在边界不清晰的问题,如数据库的一致性和Cache一致性、分布式一致性等之间的边界模糊,这使得各个领域似乎都在解决一致性问题,但都各自为战,不能形成有效的统一的体系系统化地解决数据正确性问题。
2. 定义不明:指每个领域内的一致性的定义是不明确的,缺乏形式化的表达,即缺乏科学的定义方式,这表明我们并没有深入理解其本质问题。
3. 多意:在数据库中,一致性的含义有不同的内容,如完整性约束表达的一致性,有ACID的C表达的因并发操作同一对象导致的一致性,因此一致性这个词是存在多种解释的,这会使得学习数据库的人困惑不解。
4. 多词:在数据库中,一致性和数据异常和数据正确性等,似乎存在着某种关系,但是却用了不同的词表达,且词与词之间的含义、关系是不明确的,这也会使得学习数据库的人困惑不解。根据文献[6]可推知,有冲突环图一定不一致性(有环是充分条件非必要条件);但不能知道不一致一定是有环(有三个数据异常游离于冲突环外,分别是:Dirty Read、Dirty Write、Intermediate Read);
5. 理论有缺:事务一致性依赖的可串行化理论不完备;可串行化不能消除所有的数据异常;冲突可串行化也不能消除所有的数据异常(根据文献[6]需要处理如Dirty Read等特例)。
6. 扩展无法:事务一致性和分布式一致性的关系不清晰,导致单机系统的数据正确性无法扩展到分布式系统中(目前只能依据经验解决而不能有明确的定义和规则):在分布式数据库系统中,CAP的C和ACID的C之间的关系是什么?“严格可串行化”是最严格的一致性语义,这个概念是结合了可串行化和线性一致性的语义而成的,适用于分布式事务型数据库系统;但分布式系统是否只存在“严格可串行化”这一种一致性?
7. 系统难评:无论是单机还是分布式数据库,都缺乏一致性检测体系。Oracle数据库有可串行化隔离级别,但是在运行了若干年之后,被发现其所谓的可串行化隔离级别不能消除Write Skew数据异常,因此是一个假的数据异常;而其他的数据库系统,号称实现了可串行化,但是没有一个验证标准,可把数据库作为一个黑盒子进行一致性验证;数据库厂商提供不了数据正确性的评测方法,理论界也不能提供(参考“第三代分布式数据库(3)——一致性八仙图”关于“一致性八仙图”和Jepsen的讨论)。
相关概念混淆:无论是学术界还是工程界,因为一致性缺乏明确的定义,因此不同人对该概念有着不同的理解。有些词经常混淆在一起,如事务范围内容和ACID相关的一致性,分布式系统下和线性一致性、因果一致性等相关的分布式一致性,强一致性(多指多副本复制时被复制的数据与原始数据自己的一致性),最终一致性等。--这些概念,在《分布式原理(2)--分布式环境下的各种一致性》中进一步讨论。
鉴于一致性问题重要,且尚未有成型的体系化理论论述清晰何为“分布式一致性”,本文,我们则进一步论述一致性问题。

数据库一致性定义回顾
事务处理技术的四个特性ACID已经众所周知,其中的C是指一致性。而这个一致性,是指数据的一致性,指数据在并发事务的操作下,数据间的语义始终是符合“某种逻辑”,因符合某种逻辑故而保持一致。符合某种逻辑,在事务处理技术发展的历史上,有两种不同的理解方式,一种是基于用户语义的,一种是基于特定的规则的。
对一致性的第一种理解方式:一致性需要符合完整性约束。经典的教科书,在讲事务一致性的时候,会谈到数据状态发生变化是需要满足完整性约束的。而完整性约束是用户定义的一些逻辑规则。所以从这个角度看,一致性就是数据状态变化前符合完整性约束,数据状态变化后也符合完整性约束。
《TRANSACTIONAL INFORMATION SYSTEMS》描述一致性时提及:“(数据库)保持一致性的特性不能完全自动地得到保证。相反,必须对应用程序进行编程,以便事务的开始和提交之间的代码最终达到一致的状态。这可以隐藏在应用程序逻辑中,也可以通过在应用程序中包含相应的代码来实现;此外,通过使用约束声明语句甚至触发器,可以将检查一致性的任务转移到数据库系统。在后一种情况下,未能满足事务提交点的所有指定约束将导致数据服务器强制异常终止事务。然后,结合原子性属性,保持一致性。或者,当应用程序显然将不能在达到一致状态并请求异常终止时,应用程序可以显式地通知数据服务器(This property of consistency preservation cannot be ensured in a completely automatic manner. Rather, the application must be programmed so that the code between the beginning and the commit of a transaction will eventually reach a consistent state. This can be hidden in the application logic or be done by including corresponding code in the application programs; moreover, the task of checking consistency can be transferred to the database system, by exploiting constraint declaration statements or even triggers. In the latter case, failing to satisfy all specified constraints at the commit point of a transaction results in the data server enforcing an abnormal termination of the transaction. Then, in conjunction with the atomicity property, consistency is preserved. Alternatively, the application program can explicitly notify the data server when it is clear that the application program will no longer be able to reach a consistent state and requests that it be abnormally terminated.)。”
维基百科采用如下方式描述一致性,其含义是:一致性属性确保任何事务都能将数据库从一个有效状态转换到另一个有效状态。根据所有定义的规则,写入数据库的任何数据都必须是有效的,包括约束、级联、触发器及其任何组合(需要满足用户的特定语义才能定义出这些约束)。这并不能保证事务以应用程序程序员可能希望的所有方式的正确性(这是应用程序级代码的责任),而仅仅是任何编程错误都不能导致违反任何已定义的规则(Consistency:The consistency property ensures that any transaction will bring the database from one valid state to another. Any data written to the database must be valid according to all defined rules, including constraints, cascades, triggers, and any combination thereof. This does not guarantee correctness of the transaction in all ways the application programmer might have wanted (that is the responsibility of application-level code) but merely that any programming errors cannot result in the violation of any defined rules.)。
维基百科描述的一致性,除了我们前述提及的需要符合各种完整性约束外,还表明了另外一层含义:即使在满足一致性的情况下,数据的正确性似乎还不能完全保证(即使满足了事务的一致性,应用程序开发者还得自己承担一些数据不一致的风险)。所以,我们需要思考的问题是:满足了一致性的数据库还有哪些事情不能确保的?是否存在一种能百分之百确保事务一致性的方法呢?答案是串行化可以百分之百确保事务一致性。但是,串行化导致事务的吞吐量很低,在生产实践中不可行,于是有了可串行化理论。但是,可串行化理论,是否就一定能高效率地、百分之百地确保事务一致性呢?
另外,前述的“from one valid state to another”,这句话什么抽象难以理解。什么是一个“valid state”,怎么就能到另外一个“valid state”,这中间的过程通过什么来确保过程中会发生什么或不发生什么?所以一致性的定义非常难懂。
对一致性的第二种理解方式:一致性需要符合一种“规则”定义。《Granularity of Locks and Degrees of Consistency in a Shared Data Base》一文对一致性做了如下定义:
3级(Degree 3):事务T符合3级一致性(degree 3 consistency),如果:
1.T不会覆盖其他事务产生的脏数据;
2.在执行完所有的写操作(即事务结束之前),T不会提交任何写操作;
3.T不会读取其他事务产生的脏数据;
4.在T执行完之前,其他事务不会将已经由T读取的数据弄脏。
2级(Degree 2):事务T符合2级一致性(degree 2 consistency),如果:
1.T不会覆盖其他事务产生的脏数据;
2.在执行完所有的写操作,T不会提交任何写操作;
3.T不会读取其他事务产生的脏数据。
1级(Degree 1):事务T符合1级一致性(degree 1 consistency),如果:
1.T不会覆盖其他事务产生的脏数据;
2.在执行完所有的写操作,T不会提交任何写操作。
0级(Degree 0):事务T符合0级一致性(degree 0 consistency),如果:
1.T不会覆盖其他事务产生的脏数据.
从如上的定义描述,我们通过表3-1的说明列可以看出:3级消除了4种数据异常(脏写、脏读、不可重复读、幻读),2级消除了2种数据异常(脏写、脏读),1级和0级消除了1种数据异常(脏写);其中3级是最强的一致性。这是不是和ANSI/ISO-SQL定义的隔离级别很相似(参考2.2.2节的表2-5)?!
《Granularity of Locks and Degrees of Consistency in a Shared Data Base》一文发表于1976年,ANSI/ISO-SQL定义隔离级别是1992年,前者对于后者的影响可以从中窥见一斑。
所以,从一致性的第二种定义我们可以看到,该定义比第一种定义具体化规则化了。其采用规避数据异常的方式,定义一致性,同时以不同层级的一致性方式暗中定义了隔离级别。该定义启示我们思考这样的一个重要问题:数据异常、一致性、隔离级别之间,究竟存在着什么样的关联?从第二章我们知道,历史上对于数据异常的定义是不完备的。那么一致性的第二种定义方式是不是也不正确呢?如果第二种定义不正确,那么只能回退到第一种抽象晦涩的定义上,如果这样,我们不禁要问“究竟什么是一致性”?
表1 第二种一致性的定义
编号 |
0到3级一致性的内容 |
说明 |
1 |
T不会覆盖其他事务产生的脏数据 |
不应当发生WW的操作,否则第二个写操作会覆盖第一个写操作。按传统的知识,这对应脏写异常 |
2 |
在执行完所有的写操作,T不会提交任何写操作 |
事务T可以连续做多个写操作,然后一次性提交 |
3 |
T不会读取其他事务产生的脏数据 |
不应当发生WR的操作,否则第二个读操作会读取到第一个写操作未提交的内容。按传统的知识,这对应可能发生脏读异常 |
4 |
在T执行完之前,其他事务不会将已经由T读取的数据弄脏 |
不应当发生RW的操作,否则第二个写操作会修改到第一个读操作读取过的内容。按传统的知识,这防止了不可重复读和幻读异常发生 |
其他领域的一致性--Cache一致性
除了事务处理技术领域,谈及事务一致性外,还有其他领域,都在提及一致,如操作系统领域会涉及cache一致性、大型分布式缓冲软件系统会涉及缓冲一致性、CAP中的C也是在谈及一致性,这些不同领域的一致性有什么不同?他们之间的本质是否存在某种必然的联系?
如下将展示多种不同的一致性问题。
Cache一致性
在CPU和内存之间,存在有cache。目前CPU大部分的数据访问操作都是通过cache完成,不需要和DDR直接交互;这种设计可提高CPU访问数据的效率,并极大的节约总线带宽,还能使系统可容纳的CPU数目增加。
每个CPU都有对应的cache,每个CPU都会对相应的cache进行读写操作。而多核系统中,多个CPU可能对同一地址进行读写操作,原始数据在内存中,需要被加载到发生读写的CPU的cache中。当某个CPU对共享cache line进行写操作时,其它CPU的cache中该数据块的副本将成为过时的数据。如果不及时地通知相应的CPU和内存,将导致错误的运行结果。如何保证同一地址的数据在不同cache保持一致、并与内存保持一致成为需要考虑的问题,这就是cache一致性的问题。
例如:CPU A、CPU B以及DDR都保存有同一cache line数据,如果CPU A想要对此cache line中的数据进行修改,那么总线会先使CPU B中的该 cache line无效,之后CPU A再对其cache line进行改写,此时DDR中该cache line的数据也成为了旧的不可用数据;如果CPU B需要使用该cache line的数据,则需要向总线发起读请求以重新获取新的数据,总线从CPU A的cache中获取改写后的新数据并发送给CPU B的cache;当CPU A和CPU B的cache不再保留该cache line时需要通过总线将其写回到DDR中。这要求总线需要具有管理各CPU cache一致性的功能(被称为一致性总线,Coherent Bus)。
在多处理器系统中,cache一致性又被称为存储一致性(coherence)问题。
分布式一致性
本节讨论几个具有相同本质的一致性问题,但名称与领域不尽相同,他们是:分布式一致性、存储一致性、缓冲一致性。
分布式一致性问题通常存在于分布式内存共享、分布式存储(例如:分布式文件系统、多级缓存)等分布式系统中。该问题可用如下列场景描述:
1. 节点N1和N2上都存放着数据X的副本(同一份数据多个副本);
2. 客户端A更新节点N1上的数据X;之后,客户端B从节点N2上读取数据X;
3. 在该场景中,客户端B从节点N2上是否可以读取到客户端A在节点N1上的数据更新?这就是分布式一致性问题。
与该问题相似的,还有分布式缓冲的一致性问题,同样是逻辑上的一份数据,在不同的存储层次都存在一份副本,因此面临某个副本被更新但其他副本未能被同时更新的情况。但是,分布式数据库系统中的数据一致性问题,却不与此相同,分布式数据库中主要是并发修改不同数据造成的数据异常的问题。
为了解决这些一致性问题,业界通常采用以下几种方法:
1. 缓存一致性协议(Cache Coherence Protocol):通过在多个处理器之间定义一套协议,来保证缓存中的数据一致性。常见的缓存一致性协议有MESI(Modified,Exclusive, Shared, Invalid)协议和MOESI(Modified, Owned,Exclusive, Shared, Invalid)协议等。
2. 写回(Write-back)和写直达(Write-through)策略:写回策略指的是将数据先写入缓存,然后在适当的时机再将数据写回内存;写直达策略指的是每次写操作都直接写入内存。通过选择合适的策略,可以保证数据的一致性。
3. 同步原语(Synchronization Primitives):通过使用同步原语,如锁、信号量等,来保证多个处理器之间的操作按照特定的顺序执行,从而保证数据的一致性。
4. 通常所谓的“一致性模型(Consistency Model)”,定义了对于多个处理器之间的操作,系统应该满足的一致性要求。常见的一致性模型有强一致性、弱一致性、顺序一致性等。通过选择合适的一致性模型,可以“一定程度”解决存储一致性问题。
以上方法都是为了保证多个处理器之间对共享数据的访问是有序的、一致的。
深度思考
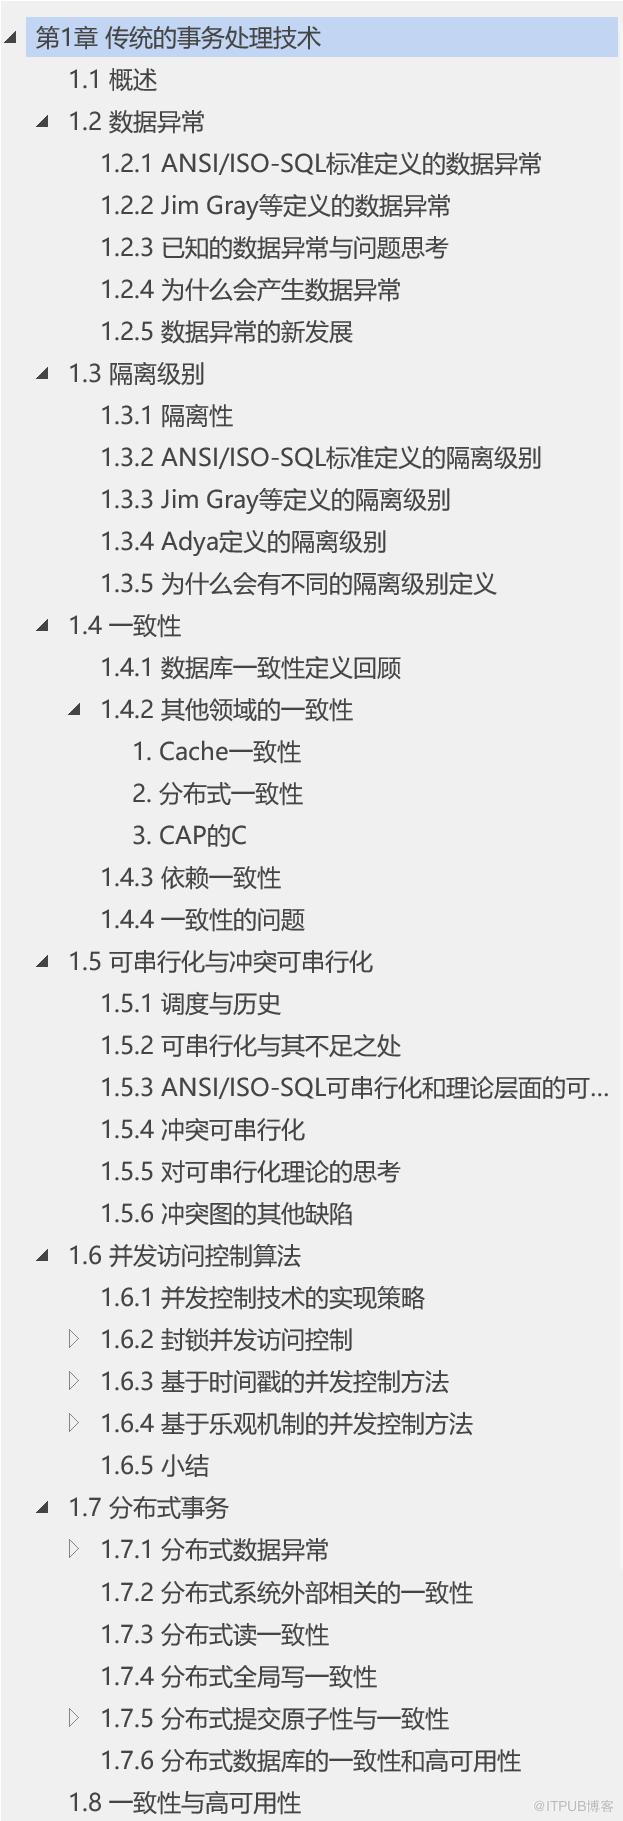
前述的《第三代分布式数据库》和《分布式原理》两个系列,讨论了很多问题,这些问题之间,存在这内在的逻辑关系,如果把这些问题能一一梳理清楚,必然会形成一种系统化的逻辑,一种能彻底理解一致性和异常之间关联关系的逻辑,从而对一致性、数据异常、并发访问控制算法等形成正确的理念。
如下图,可作为提纲,来梳理这两个系列提及的各种知识和内容,如果能深度思考,则必有所获。
一致性的未来
作者认为,一致性是信息世界中的至高境界,它代表着数据和信息的完整性、准确性和可靠性,也代表着指导人、系统、或机器人的行为的正确性。一致性是一种信仰,是对数据真实性的追求,是信息世界中的道德准则。在这个信息爆炸的时代,一致性更加显得尤为重要。随着人工智能、大数据、物联网等技术的不断发展,数据的产生和传播呈现出指数级增长的趋势,而一致性概念和技术的重要性也随之水涨船高。
未来,一致性概念和相关技术将成为信息社会的基石和支柱,它将贯穿于各个领域和行业,为人类社会的发展提供坚实的保障。一致性应用范围广泛,在互联网、金融、医疗、教育等领域,一致性将发挥越来越重要的作用,保障数据的真实性和可靠性;在人工智能、机器人等领域,一致性将约束非人智能的行为不会对人类造成伤害,使其行为和决策保持一致性,以确保其在不同情况下的表现是可预测和可控的,确保了机器人在执行任务时的可靠性和安全性。
未来,一致性将不断演进和完善,成为信息社会的核心价值和基本要求。人们将更加注重数据的一致性,技术和制度将不断完善和创新,以确保数据的一致性和真实性。一致性的未来前景是光明的,它将为信息社会的发展和进步注入强大的动力,为人类社会的未来带来更加美好的前景。
一致性扩展
一致性在许多不同的领域都有需求,并且具有各种类型的应用。以下是一些领域以及一致性的需求和应用类型的详细列举:
1. 数据库系统:
- 需求:在数据库系统中,一致性是确保数据的准确性和完整性的重要概念。当多个用户并发访问数据库时,需要确保事务的一致性,以避免数据损坏或错误。
- 应用:事务管理、ACID(原子性、一致性、隔离性、持久性)属性的保证、乐观并发控制和悲观并发控制等。
2. 分布式系统:
- 需求:在分布式系统中,一致性是确保不同节点之间的数据一致性的重要概念。当多个节点并发进行操作时,需要确保它们达成一致的共识。
- 应用:分布式一致性协议(如Paxos、Raft)、CAP定理(一致性、可用性、分区容忍性)、分布式事务处理等。
3. 云计算:
- 需求:在云计算环境中,一致性是确保不同云服务之间数据一致性的重要问题。当数据分布在不同的云服务中时,需要确保它们的一致性。
- 应用:分布式数据存储、数据同步、一致性模型(BASE理论)等。
4. 金融领域:
- 需求:在金融交易系统中,一致性是确保交易数据的准确性和完整性的重要概念。金融交易系统需要确保不同交易数据之间的一致性以避免错误和欺诈。
- 应用:交易处理、账务处理、数据同步等。
5. 人工智能:
- 需求:在人工智能系统中,一致性是确保不同模型之间的一致性和准确性的重要概念。当多个模型对数据进行处理时,需要确保它们的结果是一致的。
- 应用:模型融合、数据集集成、结果验证等。
6. 机器人:
在机器人安全领域,一致性是确保机器人系统的行为和决策与安全标准和规范保持一致的重要概念。以下是一些机器人安全领域中一致性的需求和应用类型的详细列举:
6.1. 机器人行为规范:
- 需求:机器人在执行任务和与人类互动时需要遵守一定的行为规范,以确保安全性和可预测性。一致性要求机器人的行为与制定的规范保持一致。
- 应用:行为规范的建模和验证、行为监控和反馈、遵守安全标准等。
6.2. 机器人协作与交互:
- 需求:在多机器人系统或者机器人与人类的交互中,需要确保机器人之间的协作和与人类的交互是一致的,以避免意外和伤害。
- 应用:协作行为的协调与一致性、人机交互的规范遵循、安全交互协议的设计等。
6.3. 安全决策一致性:
- 需求:在机器人系统中,需要确保安全决策的一致性,即在不同情况下机器人做出的安全决策是一致的,以确保系统的可靠性和稳定性。
- 应用:安全决策模型的建立和验证、安全决策的实时监控与调整、安全决策的自动化执行等。
6.4. 安全数据一致性:
- 需求:机器人系统中的传感器数据、环境数据等需要保持一致,以确保机器人对环境的理解和决策是准确的。
- 应用:数据同步与一致性保证、传感器数据融合与校准、环境模型的一致性维护等。
6.5. 安全标准遵循:
- 需求:机器人系统需要遵守各种安全标准和规范,以确保系统的安全性和合规性。一致性要求机器人系统的设计和实现符合安全标准的要求。
- 应用:安全标准的建模和验证、安全标准的自动化检测与执行、安全标准的合规性审计等。
这些只是机器人安全领域中一致性的一些需求和应用类型的例子。实际上,一致性的概念在机器人系统的安全设计和实现中扮演着重要的角色,关乎机器人系统的安全性、可靠性和用户的信任。
人类社会需要一致性的原因有很多,以下是一些主要的原因:
1. 社会秩序和稳定:一致性有助于建立社会秩序和稳定。当人们遵守相似的价值观和规范时,社会中的行为更加可预测,减少了冲突和混乱的可能性。
2. 合作和协调:一致性有助于促进合作和协调。当人们对于共同目标或价值观有一致的认同时,他们更容易进行合作和协调,从而推动社会的发展和进步。
3. 社会凝聚力:一致性有助于增强社会的凝聚力。共享相似的信念和价值观可以促进人们之间的联系和团结,形成更加紧密的社会关系。
4. 公平和正义:一致性有助于维护公平和正义。当社会中的规范和价值观是一致的时,人们更容易接受公正的法律和制度,从而确保社会的公平和正义。
5. 信任和稳定性:一致性有助于建立信任和稳定性。当人们对社会的规范和价值观有一致的认同时,他们更容易信任他人,从而促进社会的稳定和和谐。
总的来说,一致性在人类社会中具有重要意义,它有助于建立秩序、促进合作、增强凝聚力、维护公平和正义,以及建立信任和稳定性。这些因素都对社会的发展和健康起着至关重要的作用。
不需要一致性
在某些情况下,一致性可能不是绝对必要的,比如:
创意和艺术领域:在创意和艺术领域,个体的独特性和创新性往往比一致性更为重要。因此,艺术作品、文学作品、音乐作品等领域可能更注重个体的独特性和创新,而不是一致性。
个人品味和喜好:在个人品味和喜好方面,人们的多样性和个性化更加重要。不同人可能对于风格、口味、爱好等有着不同的偏好,因此在这些领域中,一致性可能不是首要考虑的因素。
-
科学研究的初步探索:在科学研究的初步探索阶段,可能会出现各种不一致的观点和实验结果。这些不一致性有助于激发新的思考和发现,因此在科学研究的初步探索阶段,一定程度上的不一致性是可以接受的。

分布式原理
1
扫码加关注,知数行云,专业有深度
声明:本文禁止用于开发“任何软件程序,包括但不限于训练机器学习或人工智能(AI)系统”。
原文作者:那海蓝蓝知数行云;如有侵权,请联系管理员删除。

