本文内容,源自:

四 新一代数据库的标准
前文,我们提到“数据库技术何以为代”的问题。
这个是开启新篇章的序曲问题。如果不建立标准,我们将无以为尺来度量数据库天地,我们不期望乱花和浅草来迷蒙了本欲高屋建瓴的双眼。因此我们尝试再抛个砖,提出三个点做尺。
基础核心问题:科学研究,始于问题。我们来反观数据库根技术建立的初衷,其所需要解决的重大问题,有些什么?例如,事务处理技术建立的初衷是应对并发环境下的数据正确性问题以及并发的效率问题,这是基础的、重大的、核心的问题。有了这样的问题,将形成有的放矢的导向。
有理论可依:第二,有了目标问题之后,需要有深入和广泛地研究,研究结果继而形成系统的、清晰的可演绎的体系化文字,因此而称为“理论”。这样的理论,能够把问题抽象且能对问题展开全面研究,能够使得我们的思路变得清晰,使得我们解决问题有算法可依。
有实践进行检验:第三,实践是检验真理的唯一标准。提出一套理论而不能践行,则尺不能用,无益。对于本次分享的内容而言,在“一致性与并发”理论(C2)的指导下,我们践行实现了“C2DB”的Database,这是一个数据库产品,旨在用新理论重构数据库的工程产品。
对于可串行化理论,其初始的目标是要正确且高效地解决并发环境下的数据正确性和系统的性能问题,即存在有基础的、核心的问题。但是,其没有完美(数据异常只提出有限的几个)且同时(用隔离级别把“正确且高效地”成功地变为了“正确或高效地”)解决这样的问题;因此其理论不够完美,不符合第二条标准;而实践中,数据库产品的隔离级别实现更是千差万别,距离初始的基础核心问题相去甚远;不符合第三条标准。但是,其毕竟是时代的开创者,是一个从0到1的开创者。尽管不完美,但依然伟大。


五 从问题出发
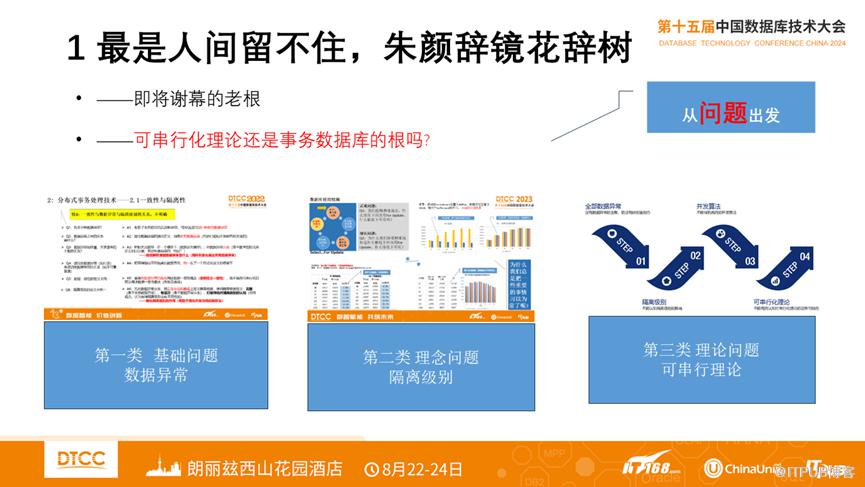
首先,我们在事务处理技术范围内,框架性的讨论四个问题,其中三个是需要从“科学研究始于问题”的角度进行研究的问题。这四个问题是事务处理技术C和I范畴内的问题,他们是:数据异常、隔离级别、办法算法、可串行化理论。
其次,我们来看,事务处理技术,这四大问题的现实情况是什么样的?
传统的教科书,并不明确描述这些问题,而且对其中的重要问题,并不单独开辟篇章进行重点描述,例如数据异常问题只被提及四个(ANSI-SQL标准中提及的Dirty Reads、Dirty Writes、Non-repeatable Reads、Phantom),但自20世纪90年代到现在,一直有人发现新的异常、发现在不同环境下如分布式环境下有别于单机环境的数据异常等。
如下我们逐一讨论传统的事务处理技术的四大问题:数据异常、隔离级别、可串行化理论、并发算法。
数据异常是数据正确性问题,是最为基础的问题。可惜的是,传统理论没有彻底把该问题研究清楚,这表现在:不知道数据异常有多少种,数据异常有什么样的特征、如何形式化定义数据异常、不同数据异常之间的关系与差异等。基础问题没有研究明白,这导致所能给出的解决方法单调、片面,也可能导致数据库领域产生了一些错误的、但普遍流行的认知。
隔离级别:这个概念的提出,是为了提高数据库的并发执行效率。因为事务处理技术实现的早期,根据实践中产生的数据库性能差的现象,得到一个经验性的结论:即并发时为保证数据正确性会导致性能剧烈下降,即鱼(正确性)和熊掌(性能)不可兼得。因此提出了隔离级别这样的概念用牺牲数据正确性的方式换取一定程度的性能提升。这是一种折中的方法,也是一种踢皮球的方式(把球踢出去踢给用户,把简单留给自己),数据库理论层面未解决这样重大的问题。可是,正确性和性能是否能够同时兼顾,在一直没有理论依据的情况下,只是基于工程实践中的一个现象(严重依赖实现方式和编码能力的现象)却得到一个“为众人所接受的(错误)认知(广为人知,成为了事实上的标准)” ,流毒甚深。
可串行化理论:为了解决并发下数据正确性和并发性能问题,可串行化理论应运而生。这个伟大的理论奠定了事务处理技术的根基,使得事务处理相关技术从技术升华为理论。但是,(初期的)可串行化理论的着眼点,首先在于串行,而串行严重损失性能;其次,“可串行化”改变了“串行”使得并发被允许执行提升了执行效率,但是忽略了并发事务执行的过程中的结果正确性而只注重一个调度执行结果的正确性,致使可串行化理论有了缺陷;之后发展出的冲突可串行化弥补了初期的可串行化理论只重结果正确忽略过程正确的问题,但是冲突可串行化只是弥补了可串行化理论的一部分问题(低效率方式解决了“数据正确性和性能问题”)而把自身融为了广义可串行化理论的有效组成部分(广义的可串行化理论成型)。如何高效率地、并且100%保证数据正确性的问题,未曾被解决,因此终将被提上议事日程。

六 并发算法
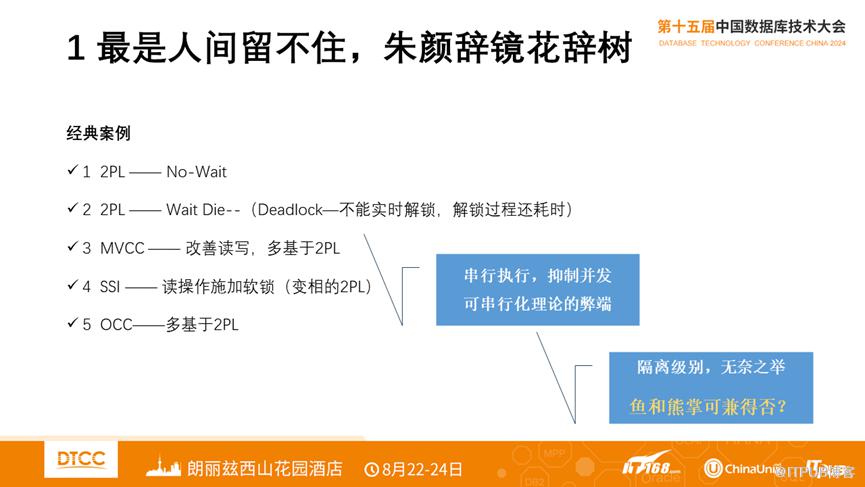
并发算法在可串行化理论的指导下,提供了解决问题的具体方法。我们知道,并发算法有很多,改进的并发算法也有很多。但是,如此多的并发算法之间,有什么联系和差异吗?或者说,并发算法之间有什么特定的规律?如何有效认知并发算法呢?
并发算法1—基础认知:并发算法在可串行化理论的指导下,用等价的可串行化调度,确保数据的正确性,并尽力提高并发度。在确保正确性的算法中,2PL算法的No-wait策略最为典型,其淋漓尽致地展示了“串行”的指导思想,只要有冲突即回滚一个事务以达到串行的目的;2PL算法的Wait-die策略则致力于提升并发性能,但是却出现了“死锁”现象,可惜的是,死锁现象被独立认知,而没有与数据异常建立联系。《一致性与并发》一书的成果之一,是证明了死锁的本质即数据异常,并能把各种死锁用数据异常进行形式化定义(这个内容本次分享会进一步讲述)。再回到2PL算法的Wait-die策略,该策略抛弃了遇到冲突就回滚的串行思想、而是尽力并发执行(但需要花费较大资源执行死锁检测),较好地展示了“可串行化调度”的思想精髓,但是死锁检测消耗了系统资源(CPU和内存),还使得事务执行周期变长,使得事务时延变得不可控,即并发效率难以进一步提升。
并发算法2——MVCC:如果世界是平面的,数据只有一个状态,没有历史数据可追溯,那么MVCC算法是没有发挥余地的。恰好数据存在过去、现在的状态,使得数据变得立体起来(当前数据状态和历史数据状态),这使得读操作可以只读取历史状态的数据而避免和当前改变数据状态的写操作发生冲突(一定程度地避免了死锁检测、事务回滚等耗时操作),因此能有效提升并发效率。但是如果没有锁的算法加持,读了历史数据又想改变某些数据状态的事务,势必与其他存在并发写的事务构成冲突而导致数据不一致;这是历史知识给出的认知。但是,导致什么样的不一致,如何就能导致不一致,历史知识没有给出答案。而《一致性与并发》理论和书系统地解决和描述了这样的现象,并用形式化的方式整体描述了数据异常、死锁的关系。
并发算法3——SSI:其他的并发算法,诸如SSI(可串行化快照),采用“谓词锁”的方式,其本质是一种“软”锁(把2PL中的锁的作用分开,一是构造加锁状态,二是互斥其他并发事务执行),只构造加锁状态不去互斥其他并发事务的执行,一定程度能改变串行执行的思路使得并发加强,但是因未解决死锁和数据异常之间的关系而割裂地分别去解决两者,使得并发算法割裂而凌乱。
并发算法4——算法之间的关系:各种并发算法,都如同盲人摸象,只见局部只能从局部角度出发解决并发问题。这究竟是为什么呢?这其实是一个相当令人困惑的问题,困惑之处在于:如果是局部角度,从局部角度出发构建的算法,为什么能完全解决正确性问题?如果不是局部角度(站在整体角度应已经能清晰地掌握问题全貌),为什么前述的基础问题如数据异常等尚没有完全有解?理解这些问题,需要我们非常深入地掌握问题的整体情况和其间的细节。《一致性与并发》理论和书的成果之一,提供了一致性的整体面貌和丰富的细节,并加以量化并发事务执行,使得对于事务处理技术可从“感性认知”进入到“量化认知”阶段。

七 C2——一致性与并发
前述我们讨论了数据库事务处理的黄金圣律——(广义)可串行化理论存在的主要问题。概括一下,主要是:
基础的核心问题没有研究清楚。这导致后续给出的解决问题的办法存在“一叶障目”的事情发生。
理论体系较为粗糙。可串行化理论能引导把数据正确性和一定程度的性能问题解决掉。但是,不能把事务处理技术引入量化时代,因而对很多问题的认知是不清晰的,这导致学习的人、使用的人,在掌握这一块知识体系的时候,始终处于懵懂状态。例如高校教学过程中,因难以把并发算法之间的关系讲明白而只单独地、孤立地讲数个并发算法后即结束相关内容。大家可以翻翻经典教材的目录结构和章节设置,即可看出这一点。
理论体系存在错误。可串行化理论要解决一致性问题,而其对一致性的认知,是建立在数据完整性的基础上的(目标),这显然和并发导致的数据异常(结果)造成的不一致是不同的,而后者又是ACID的C的实际含义。目标和结果不同,属于严重的精神分裂症,该症状导致我们无法理解——究竟什么是一致性?一个奇怪的逻辑是:在对一致性没有明确加正确的理解和形式化定义的情况下,数据库可串行化理论居然“又”能把正确性问题(指并发下的一致性)解决掉,这又是为什么?这一切的答案,都在《一致性与并发》理论与书中揭晓。可以想象的是:数据库工程系统对事务处理技术的实现,会是多么地混乱多么地不统一。
理论体系不能指导新应用。一套理论诞生后,除了能解决已知问题外,还应能应对新情况,使之真正具有普适性。可串行化理论则不具备这样的能力。这是因为遇到分布式环境,需要把CAP的C一并纳入,否则,所有现存在实现的分布式数据库其一致性能力必定会一直很弱,不能满足用户需求。但显然可串行化理论的“完整性约束”或ACID的C都不能包涵CAP的C。《一致性与并发》理论则系统地解决了这个问题,使得一致性被形式化定义,并统一了单机与分布式环境的一致性的异同,使得单机数据库与分布式数据库不再割裂,分布式数据库的实现从此有了理论依据不再盲道前行。
今天的分享,我们着重在新理论中的“一致性与并发”这个核心主题上。根据前述对传统的可串行化理论的分析,我们树立了一个极高目标:100%保证数据正确性的同时,最大化并发性能。这就是2个100%的由来。
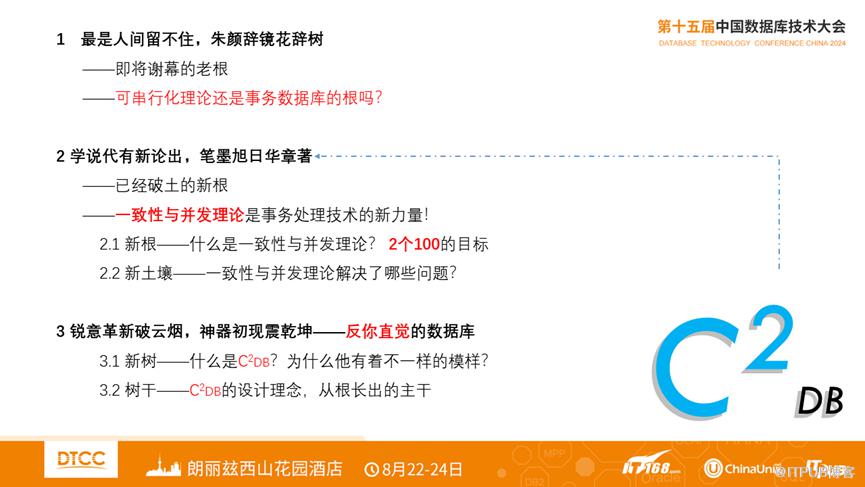
下图则展示了这两个100%的内容。

前述“数据库何以为代?”的讨论中,我们提出三点中的第一点是“问题,即科研问题究竟是什么?”。只有对要研究的问题弄清晰弄明白,才可能彻底解决问题。《一致性与并发》理论和书,全面分析了相关问题,参考下图。

未完,待续......


扫码加关注,知数行云,专业有深度
声明:本文禁止用于开发“任何软件程序,包括但不限于训练机器学习或人工智能(AI)系统”。
原文作者:那海蓝蓝知数行云;如有侵权,请联系管理员删除。

