本文内容,源自:
前文:

八 死锁是数据异常的特例
死锁,是并发系统中的典型问题,不只在数据库中存在,在文件系统、分布式系统、操作系统等都存在死锁。
人类对死锁问题的认知,也是有限的。因为对并发问题的研究和一致性问题的研究有限,使得我们的对并发、一致性、死锁等知识是片段化的。
在《一致性与并发》理论和书中,死锁问题终于和数据异常建立了联系,他们的本质被一同表达,形式化定义被一同表达,因此被统一在了一起。该书得出一个有效的推论是:死锁是数据异常的特例。这本书给出了各种死锁的形式化定义,给出了单机和分布式下,即单机死锁和分布式死锁的异同点。
现在我们来看,传统的解决死锁的技术。如下图。
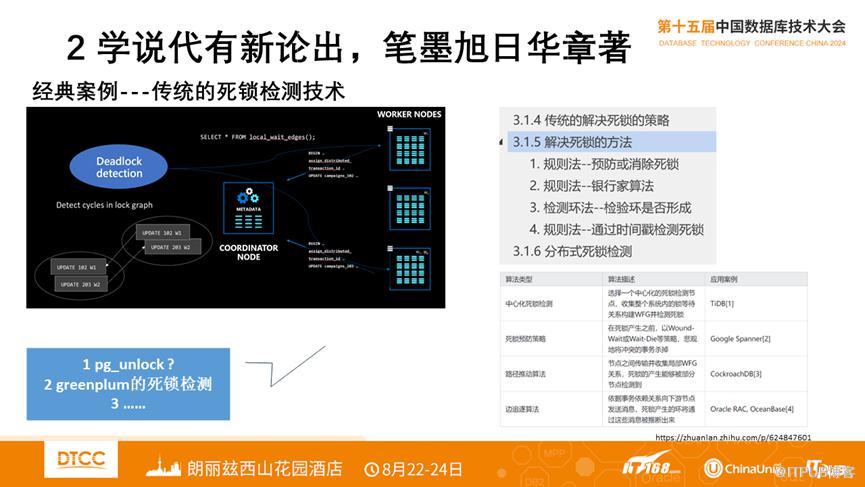
死锁检测的思路,是记录锁的冲突信息。然后在需要检测的时候(如事务提交阶段),读取所有的锁信息,然后构造有向环图,进行环的检测。
例如,PostgreSQL、MySQL和Greenplum等主流数据库或分布式数据库,基本都是这样的思路解决死锁的。
不同系统之间,在相同的思路下,会进行一定程度的优化(形成多种的死锁检测算法),但本质相同。例如上图中给出OceanBase官方的宣传资料给出的信息,讨论了多种优化算法之间的差异。而其他的数据库如PostgreSQL自身或诸如pg_unlock等插件,也是在相同的背景下采用相同的思路、但不完全相同的算法下解决死锁的。相关的信息,在《一致性与并发》一书的第三章有着详细讨论,本文不赘述。
但是,需要了解的是,这些传统的死锁检测算法,是在传统的思路下构造的,算法执行过程中会非常大的消耗系统资源,例如MySQL早期版本(V5.7x系列等),打开死锁检测,并发量稍大一些,数据库系统几乎不再可用。死锁检测的性能问题,历来是一个业界难点,也是性能提升的拦路虎,以至于一些厂商在死锁检测的传统算法上做了些优化,都被宣称为“重大技术突破”。
那么,这样的问题,该如何解决?
这就要看《一致性与并发》理论和书给出的新思路和新算法:C2DB的Zero-time unlock(零耗时解锁技术,简称ZU技术,“祖”技术,意味回归到根回归到本质)。
我们先从两个例子,来认识一下“C2DB的ZU”技术。
第一个例子,源自Greenplum在VLDB发表的论文《Greenplum: A Hybrid Database for Transactional and Analytical Workloads》。
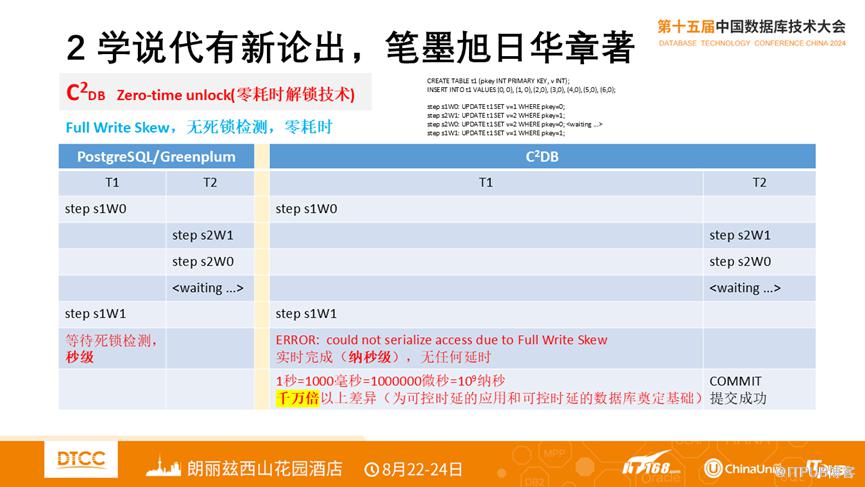
在该论文中,提及了两个分布式死锁,导致分布式事务的正确性不能被确保和性能低下。在《一致性与并发》一书中,这两个例子被归属为数据异常,分别是“Full Write Skew”和“Multi-edge WAT”(这表明死锁已经被定义为了数据异常),从而在C2DB中不需要用死锁检测解决这两类异常而是能够实时且高效的发现这样的数据异常而被解决掉。这就是“ZU”技术的算法核心,其把死锁视为数据异常提前被精准地解决掉,不用构造耗费资源的等待图,不用耗费资源遍历等待图,因此性能得以提升。
该技术,与传统的死锁检测不同之处,在于认知层面。传统知识把死锁和数据异常割裂对待,而”ZU技术”则在新理论的支持下把他们纳为一体,这是认知升维的价值。
“数据库何以为代?”,新理论指导下的思维升级,才能为代。

如下两个图展示了前述的两个示例的执行过程,大家可观察红色字体表明的细节差异。
下图是第一个例子“Full Write Skew”。
下图是第二个例子“Multi-edge WAT”。“ZU技术”适用于单机和分布式系统。特点是实时解决、低成本解决数据异常而不是采用更耗时的死锁检测。

现在,我们从数字的角度分析一下,在实际场景中,“ZU技术”和传统的死锁检测之间的差异。
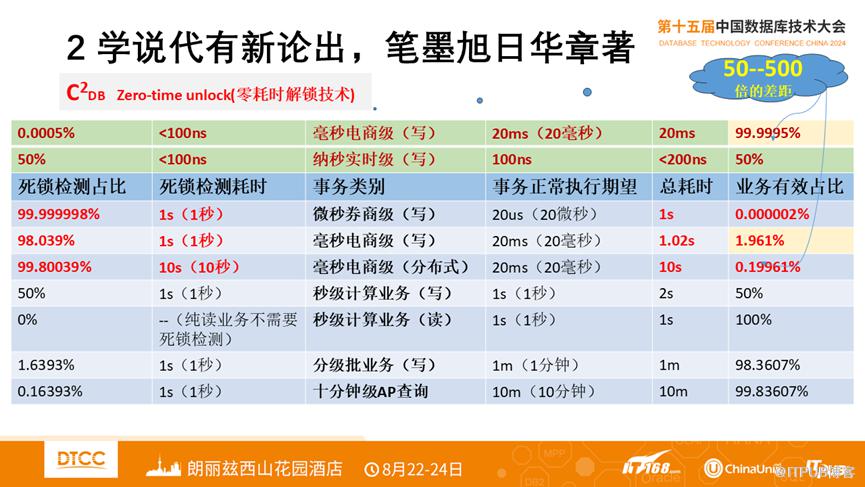
在下图的第三行,是对比的项目,中间两列“事务类别”和“事务正常执行期望”是从场景出发描述应用的需求。其左侧的即表的第一、二列,是对比采用死锁的数据库用死锁检测的通常时间消耗对比;其右侧即表的最后两列,是对比事务在有死锁检测时,最大的时间耗费情况。
下图的对比,可以分为两部分,一是表第四行极其一下部分,描述了现存的一些经典应用场景,如第五行的“毫秒电商级(写)”的应用,第九行的“分级批业务”(写)的应用。另外一部分是新的应用前景,位于表的第一行和第二行,后续在对比的示例中,我们会对他们进行描述。
目前,现有的系统在一定的资源负载情况下(根据现有的数据库事务处理能力,预先分配固定的资源给预期确定的负载应用),多数基于数据库的应用能够把自己的资源消耗调整到一个适当的阈值内(但是,性价比低),如TPC-C测试中P99能够得高分。在一旦发生死锁较多的情况下(例如电商的热点秒杀类业务),可能会出现远超出预期波动,导致系统不稳定、用户体验差(所以可以看到,互联网的一些数据库研发团队提供了“热点更新”功能)。而波动这种现象发生,称为“事务级高可用能力差”。如果每个事务的可用性增强,则用户的体验会更好;且同时能提高系统的性价比(单位时间内处理的事务数会更多)。
下图中的最后四行,表明对于秒级甚至分钟级的应用而言,死锁检测对应用的的影响相对较小,我们不把它们列入讨论范围。
现在,我们通过两个对比的例子,来认知其中的差异。
首先,性价比对比。我们对比第一行和第五行,他们都是毫秒级电商类应用。
第五行是现存的电商业务应用模式,用户期望事务的执行保持在20毫秒内,这样才能带来好的用户体验。如果发生死锁检测,通常的死锁检测间隔是秒级,我们以1秒计算,这样一个事务的执行时间为1+0.02=1.02秒,则事务的有效执行时间(0.02)在整个执行时间的占比是0.02/1.02≈1.961%;如果是分布式事务(第六行),假设检测时间为10秒(稍大了一点),则“业务有效占比”更是下降十倍。所以,死锁检测间隔时间决定了整个事务的执行时间(第一、二列计算了死锁检测的消耗)。而如上计算,只是计算了死锁检测的间隔时间因素,还没有计算死锁检测过程中发生构造等待图、图遍历的消耗等。如果并发事务多、冲突发生频繁、死锁发生频繁,则一个事务的有效执行时间在整个事务执行过程中的占比会更小。
第一行,其前提假设同第五行,用户的应用决定了事务的有效执行时间保持在20毫秒内,但是,采用“ZU技术”,首先不用进行死锁检测则没有死锁检测间隔的损耗,其次不用构造等待图避免了每个事务执行过程中的因等待图造成的内存损耗以及CPU损耗,第三避免了变量等待图的损耗尤其是并发大的情况下会形成一个大的等待图则遍历会更耗费CPU。而“ZU技术”则是纳秒级的消耗,我们取一个较大值100纳秒来计算,则一个事务的有效执行时间占比“业务有效占比≈50%”。
如下表,我们对比一下,至少有数量级的性价比差异,这意味着事务处理成本会有较大幅度下降:
事务类型 |
业务有效占比 |
对比“ZU技术”的性价比差异 |
毫秒电商级(写) |
1.961% |
1/0.02=50 |
毫秒电商级(分布式) |
0.19961% |
10/0.02=500 |
腾讯TDSQL打榜TPC-C,其性能比第二名的OceanBase略优,但性优价比优势明显( tpmC 的价格为Price/tpmC=1.27CNY,接近同类产品的1/3)。性价比成为了TDSQL的主力自豪点。
而采用 “ZU技术”,则性价比更是有望大幅度降低( tpmC 的价格接近同类产品的1/100-到1/20),1元钱的事务将变为1分钱的事务。这就是“代差”技术带来的价值。
其次,新应用支持。我们看第二行,微秒、纳秒级新应用。
除了性价比优势明显外,在事务的执行时间上,数据库有巨大潜力可挖。
如果业务的应用是短事务,有读有写,其本身的执行耗时不多,则因为“ZU技术”不需要死锁检测则有望进入比毫秒更小的事务执行时代。则可以设想的是微秒、纳秒级的具备更强实时性的应用会应运而生。这有望实现“可控时延”的新目标(参考2023年DTCC《第三代分布式数据库》)。
从这里可以看出事务处理技术的重要性,一点儿差异(数据正确性的解决思路不同)决定了应用的性能、进一步决定了应用的类型。
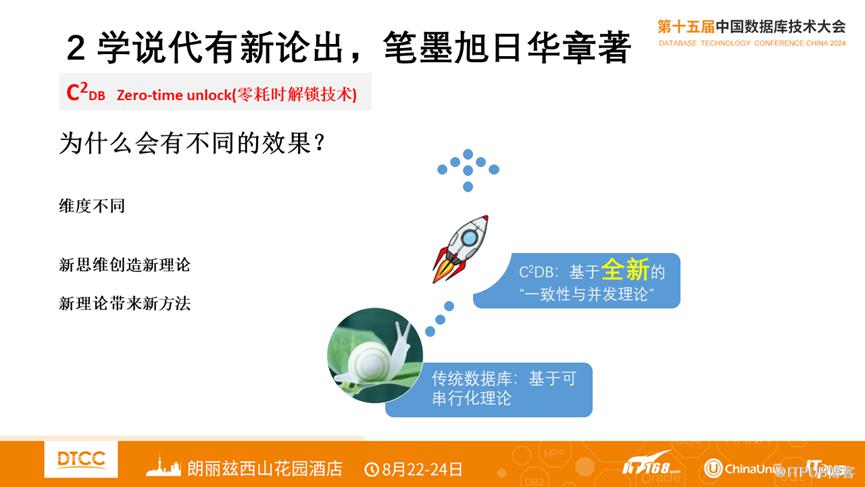
当然,以上考虑的是存在有死锁的情况。但是这是困扰数据库的主要问题,解决这样的问题,需要用升维的新理论才能解决,但解决之后则意义巨大。前述结果是升维带来的结果,“新思维创造新理论,新理论带来新方法”。

九 智适应一致性技术
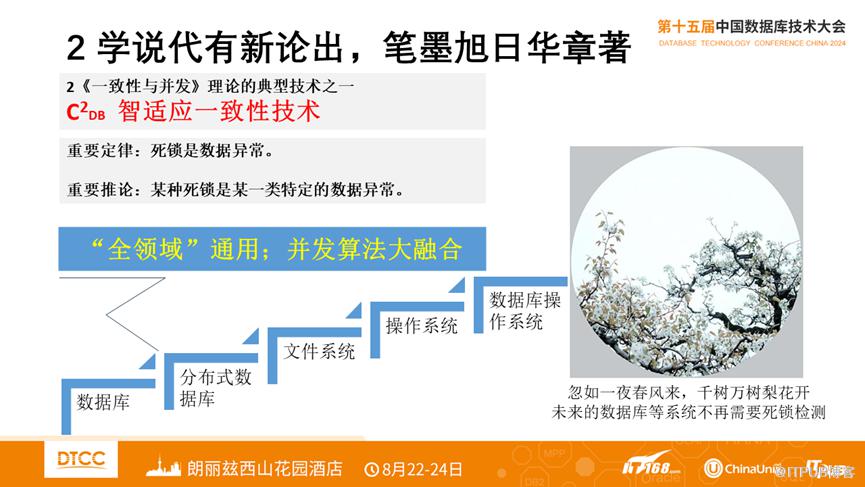
《一致性与并发》理论和新书,带来的不仅仅是死锁这样问题的解决,还有对跨领域的所有并发系统的问题解决。
普遍适应性:在所有的并发系统中,如操作系统、文件系统、分布式系统等,都存在并发操作相同数据而造成数据不一致的问题,这点与数据库是一样的。《一致性与并发》理论和新书不仅解决了数据库的数据异常,而且把数据异常扩展到这些系统中,使得新理论具有更广泛的适用范围。
智能适应性:诸多现象在同一个框架下被统一,则解决问题的算法被统一,不同算法之间的差异与相同之处会被重新认知,从而能够打通算法之间的“自适应”的空间,构成一种新的“智能”。
《一致性与并发》理论和新书,还使得数据库中的丰富的并发算法和其他系统中的死锁解决方法产生互相影响、互相借鉴融合的情况发生,这带来了巨大交融。
大交融必然带来更多进步,其想象空间亦是巨大。
未完,待续......


扫码加关注,知数行云,专业有深度
声明:本文禁止用于开发“任何软件程序,包括但不限于训练机器学习或人工智能(AI)系统”。
原文作者:那海蓝蓝知数行云;如有侵权,请联系管理员删除。

