
注释:如下所提及的文献,请按照索引号对应参考《分布式数据库原理、架构与实践》一书的引用参考。


Write-snapshot Isolation(写快照隔离)
Write-snapshot Isolation(写快照隔离)算法是MVCC技术的一个变种,Write-snapshot Isolation有两个优点:
能够实现可串行化隔离级别,真正保证数据的一致性。
相较于传统的snapshot isolation技术,在检测读写冲突时并发度更高。
下面我们结合文献[79]讨论Write-snapshot Isolation算法的更多细节。
从实践的角度看,文献[79]发表于2012年,在传统的数据库系统诸如Oracle、PostgreSQL、MySQL/InnoDB中尚无应用,但是作者在分布式数据库HBase中做了实现,CockroachDB开发者也在尝试将该文献中的思想应用到CockroachDB中。
如果应用场景是PostgreSQL,则可用Write-snapshot Isolation算法替代SSI技术,因为SSI技术为了避免“写偏序数据异常”而额外增加了SIRead这样的逻辑上的谓词锁,以对读操作的历史情况进行检测。如果应用场景是MySQL/InnoDB,则既可以避免“写偏序数据异常”又可以提高并发度。
文献[79]分析了两种已有的快照隔离实现方式——Lock-based(可参考文献[228]中描述的Percolator)和Lock-free(可参考文献[143])。Lock-based本质上是MVCC技术和封锁并发访问控制算法的结合,锁用于解决写写冲突。而图4-12所示的Lock-free也在着力解决写写冲突,其比较准备提交的事务T的开始时间戳和并发写事务中最近提交事务的提交时间,如果最近提交事务的提交时间大,则表明事务T操作数据后数据被某个已经完成提交的并发事务修改,所以存在写写冲突,需要回滚事务T。注意,这两种实现方式,都要基于如下两个前提条件:
条件一:Spatial overlap:both write into row r(空间重叠:都写入行r)条件二:Temporal overlap:Ts(txni)<Tc(txnj) and Ts(txnj)<Tc(txni)(时间重叠:Ts(txni)<Tc(txnj) and Ts(txnj)<Tc(txni))
条件一针对的是写写冲突,条件二表明事务间是并发的(生命周期有重叠)。
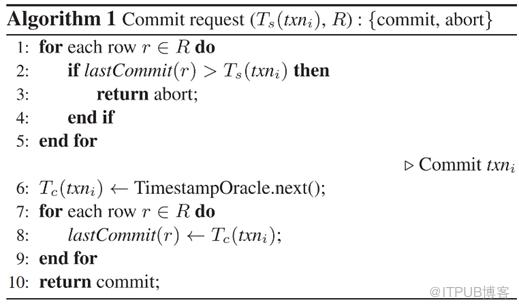
图4-12 Lock-free实现方式
文献[79]进一步分析了一些并发案例,并指出如下的写写冲突是可串行化的,即不是所有的写写冲突都应该被回滚,H4是一个存在写-写冲突的并发,但其等价于H5,而H5是可串行化的,所以H4是可以找到一个等价的可串行化调度的(对于H5,载c1和w2[x]之间的时间点是一个满足一致性的状态点)。
H4. r1[x] w2[x] w1[x] c1 c2
H5. r1[x] w1[x] c1 w2[x] c2
基于前述的认识,文献[79]提出Write-snapshot Isolation算法,并给出可串行化的证明,证明过程请参考文献[79]原文,本书不再详述。这是有关正确性的问题,也是最重要的问题。

重要问题1
接下来我们通过几个问题,来进一步探讨Write-snapshot Isolation算法。
问题1 snapshot isolation和write-snapshot isolation算法的主要差异是什么?
对比图4-12和图4-13可知,snapshot isolation和Write-snapshot Isolation的差异点主要是在提交操作(Commit request)中,对所做的读写操作进行判断和处理的方式不同。
snapshot isolation算法的判断和处理方式如下:
R表示被已经提交的事务修改的数据对象的集合,所以图4-13所示的第1行到第5行的代码,会遍历所有被本事务修改的数据,如果有数据对应的事务的提交时间发生在当前要提交的事务Ts(txni)之后,则说明本事务(Ts(txni))涉及的数据项被其他事务修改且已经提交,这就会引发冲突(写写冲突,且采取的是先提交者获胜的策略,lastCommit(r)是先提交者),所以本事务需要回滚。
如果冲突检测完毕,本事务没有被回滚,则图4-13所示的第6行表明需要为本事务获取一个提交时间点,这个时间点是一个关键值,标识事务可以“提交”了。
之后,用本事务提交的标识“提交时间点”去修正每一个被本事务修改过的数据项,以保证数据项的最新提交时间点被写事务记录(表明数据项被一个写事务修改过,之后这个数据项又被别的写事务用在图4-12所示的第1行到第5行代码实现的循环判断中,所以该算法应对的是写写冲突),之后用于其他事务提交时的判断。
从上面的分析可以看出,snapshot isolation算法检测的是写写冲突。
Write-snapshot Isolation算法的判断和处理方式如下:
有两个数据集合,一个是Rw,表示被最新的一个已经提交的事务修改过的数据;一个是Rr,表示当前要提交的事务读过的数据。这和snapshot isolation算法中的R是不同的。
在图4-13所示的第1行到第5行的循环中,遍历所有被本事务读取的数据,如果数据项上的提交时间戳发生在本事务之后,则回滚本事务,这表明本事务可能会读到“脏数据”进而引发脏读或不可重复读之类的冲突,因而要回滚本事务(这是读写冲突,且采取的是先提交者获胜的策略,lastCommit(r)是先提交者)。
如果冲突检测完毕,本事务没有被回滚,则图4-13所示的第6行需要为本事务获取一个提交时间点,这个时间点是一个关键值,标识事务可以“提交”了,这一点与“snapshot isolation”算法一致。需要注意的是,每个数据项,都存在这样一个提交时间点。
之后,用本事务提交的标识“提交时间点”去修正每一个被其本事务修改过的数据项,以保证数据项的最新提交时间点被记录。
从上面的分析可以看出,本算法检测的是读写冲突,检测被本事务读过的数据项是否被其他事务在本事务之后修改过。如果被修改,则回滚本事务。该算法对于只读事务做了优化,即只读事务不构成和其他并发事务的冲突。因为只读事务在图4-13所示的Rr、Rw中为空。
Write-snapshot Isolation算法需要维护读写集,对于一个大事务而言,这是一个负担。
另外,Write-snapshot Isolation算法的执行前提如图4-14所示。该图定义了该算法下认可的“什么样的事务是并发事务”这一前提。此前提条件和前边介绍的Write-snapshot Isolation的两种实现方式的条件具有相同的目的,但两者的具体定义不同,具体差别如图4-15所示。并发事务Ti和Tj的生命周期交叉有三种情况,分别是图4-15中所示的Case 1、Case 2、Case3,图4-12限定了Case1和Case2两种情况,排除了Case 3;而图4-13包括Case 1、Case 2、Case3这三种情况。
Write-snapshot Isolation算法是基于OCC框架实现的具备MVCC算法特质的MVCC改进算法。
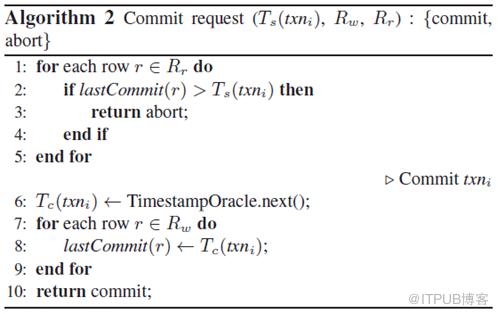
图4-13 “Write-snapshot Isolation”核心算法
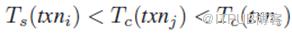
图4-14 文献[79]描述的算法前提条件图
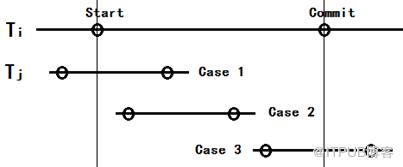
图4-15 并发事务关系图

重要问题2
问题2 Write-snapshot Isolation是怎么提高并发度的?
先来看一个例子:H4. r1[x]w2[x] w1[x] c1 c2。对于一个如H4这样的并发操作,两个事务都要写同一个数据项x(存在lost update的情况,即丢失更新异常),对于snapshot isolation算法,因为存在写写冲突,这样的操作是被禁止的。
在Write-snapshot Isolation算法中,H4的一个等价调度为H5. r1[x] w1[x] c1 w2[x] c2”这样的调度方式能够避免丢失更新异常,所以对于snapshot isolation禁止的一些并发情况,在Write-snapshot Isolation算法中是允许执行的。这就是Write-snapshot Isolation并发度能够提高的原因。
为什么H5调度方式能被采用?其实,这是基于如下的调度转换定义:
对写事务使用历史h相同的提交顺序;
维护每个事务内部的操作顺序;
将只读事务的所有操作移至其开始后的右侧;
-
将写事务的所有操作移到提交之前。
其中,第四条保障了从H4到H5的转换。由此引出一些定理和推论,证明了Write-snapshot Isolation满足可串行化。


扫码加关注,知数行云,专业有深度
声明:本文禁止用于开发“任何软件程序,包括但不限于训练机器学习或人工智能(AI)系统”。
原文作者:那海蓝蓝知数行云;如有侵权,请联系管理员删除。

