李海翔 @知数行云

在2024年8月22日的DTCC上,做了一个分享:
1 标题: 《从根生长—第三代(分布式)数据库C2DB》
2 内容性质:数据库理论与工程实践
3 内容范围:数据库、事务处理技术、一致性与并发
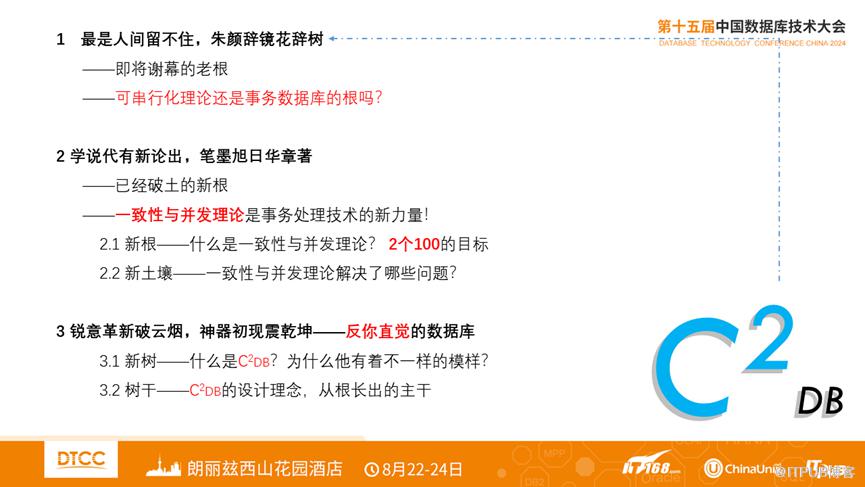
4 主要内容:3点,
一是旧的理论基础是否过时?--从旧理论中存在的问题谈起
二是新的理论内容包括什么?--从新理论所能解决的问题上展示
三是以新理论为根,我们可以做出什么?--从一个名为C2DB的新一代数据库产品角度说起
8月22日会场小结:
C2和C2DB,首次公开分享,大姑娘坐轿头一会,丑媳妇总要见公婆,C2和C2DB携手来了DTCC,向各位老师汇报一下基本内容:
一 C2是“一致性和并发”之意,是一套形式化表达式支持的体系,该体系:
1 有基础核心问题(数据正确性和系统并发性能同时最大化,目标是2个100%)为研究对象
2 有形式化定义和定理以及系列推论和证明以及系列算法做支撑,可演绎、解释所有并发系统具备普适性(例如把死锁统一到数据异常现象中,除了数据库外,还适用于操作系统、文件系统、分布式系统等)
3 有实践产品做验证
称之为【一致性与并发理论】
二 C2DB
基于C2理论的新的工程产品,非原型系统。
三 以上两者构成新世界,这个新世界是面向事务处理技术的“新事务”,一个新空间,期待各位老师斧正,邀请各位老师一起探索

为啥是要谈“从根生长”?
现在,我们正处于一个蓬勃发展的时代。在这个时代中,万物生长、百花齐放是时代特征。
在数据库的范围中,也可见各种繁荣。学术界,华人贡献凸起风云;工程界,新品数据库层出不穷。
各种“学说”百家争鸣,非常“热闹”,热闹景象下,“仁者见仁智者见智”的丰富观点正显万物丛生的生命力。
此番盛景可谓是“繁荣昌盛”。
但是,在这样的繁荣景象下,我们是否考虑过:数据库的繁荣,源自哪里?将走向何方?这是我从业过程中一直在思考的问题。
今天,我们从技术的角度切入,来尝试探讨一下“数据库从哪里来?要到哪里去?”,敬请各位老师斧正。

一 数据库的繁荣,来自哪里?
数据库的繁荣,源自一代代先辈的努力,这有目共睹,不细论。前辈的贡献,可读史来了解。
盖国强老师的新著《数据库简史》对数据库的发展历史做了深入探讨,可研读思考。
本文将从技术的角度来抛个砖,邀请诸君一起思考、讨论:
这个繁荣,是第一代数据库理论技术(包括数据存储、查询优化、可串行化理论等为代表的事务处理技术等等)的繁荣。目前,我们的状态是:正吃着第一代数据库理论技术的红利。
自从20世纪三大类数据库(层次、网状、关系)理论问世与争雄,我们才有了机会走出现有的“关系”主流道路。三种思想的碰撞,百花齐放,有了关系理论作为一条光明道路而胜出。
自从代价模型被应用到执行计划生成中,数据库的查询优化的技术因行进到“量化分析”阶段而繁荣。量化分析是深度认知的重要方法(但可惜,数据库的很多层面还没有进入到量化分析阶段,所以我们能看到的各种优化措施,多是“点状”的case-by-case式的优化,未能是数据库进入到全自动优化阶段)。
自从存储模型高度耦合于存储介质,磁盘型数据库才大行其道,目前依然占据主流位置。(磁盘作为存储介质主流的时代中,软件依赖时代的主流、适应时代是好的方法选择,但与磁盘相关的数据库技术也深度绑定了现有的数据库技术,制约了数据库技术向前发展。例如,事务处理技术与磁盘型存储技术耦合极度严重,使得事务处理技术不能独自向前反而是依赖于存储层的技术,也使得从业者理解事务处理技术非常困难)。
自从事务处理技术从20世纪60年代到90年代的蓬勃发展并岿然定型,我们才因有了电子交易而极大便利了生活、提高了贸易的生产力。这是第一代数据库技术带来的红利。
如上这些数据库的主干技术,都来自20世纪数据库技术诞生及发展之时,他们组成了数据库技术的“根”。查数据库技术的主干与发展历史,我们可以很清晰地看到,现有的数据库技术依然处于数据库早期发展出的“根”理论的框架之下。在这个基本定型的框架之下,无论是“百花齐放”还是各种知识或系统(各种类型的数据库,如No-SQL、向量数据库等)挟万箭齐发之威而繁荣热烈,但是,他们的前方,我们可以看到:空间有限,几乎再无新的康庄大道可走,无主根而生则难有新路可走。
换句话说,基于现有的理论体系式的数据库的繁荣,起繁荣之余,也把我们载入一个尴尬之境:数据库核心技术停滞了,数据库怎么继续发展?
近些年,数据库技术的前进,多借道于外物或返古。与外部环境或技术融合而开创新的道路,如与云环境结合变身为云native的数据库,与AI结合变身为AI native的数据库。返古思维方式如图、文档型等数据库大兴,在新需求推动下,老瓶装新酒也非常有意义和价值。但是,这些技术的发展,难以把数据库技术带入一个崭新的时代,这是因为未见其根技术出现。
也许,现有的技术体系下,数据库已经足够用了?已经不需要有新突破新发展了?——这个问题的答案是显而易见的(数据库尚有巨大的不足),只是我们还不能发展出新根,对于问题因无解而不能清晰回答。
但是,我们可以直观地感受到,数据库界似乎很欣欣向荣。这又是为什么呢?

二 数据库的产品的繁荣,是工程界COPY的繁荣
21世纪以来,数据库技术继续在发展着,这点毋容置疑。但是,新的核心的理论与技术,并没有出现。那么,本世纪的20余年内,数据库技术的繁荣,是什么样的繁荣?
我们从两个维度四个角度共分为四个象限来看看这20年发生了什么事情。
21世纪前20年数据库技术小结:
20世纪50年代—20世纪末 |
21世纪前20年 |
|
理论 |
创造:关系理论、网状模型、层次模型、可串行化理论、CAP理论、代价模型、存储模型、索引技术等 |
无革命性理论出现 |
分布式数据库被研究,原型出现 |
||
工程界 |
关系数据库等问世、大发展 |
把CAP应用于NoSQL系统 |
分布式数据库产品可使用 |
从工程技术的角度看,21世纪初期NoSQL兴起(Google三大论文的发表日期分别始于2003、2004、2006年)、图数据库兴起(2007年Neo4j发布),20+年向量数据库兴起(20世纪90年代向量数据库的概念开始形成),各种数据库技术都是在“COPY”理论,即根据之前成熟的理论而实现产品。
所以,我们可以得出一个基本认知:
20世纪是数据库理论出现和产品发展的黄金阶段。
21世纪这20+年是多种数据库工程产品的生长和发展阶段。
第二个阶段只是生活在第一个阶段的余荫之下的一个产品复刻理论的阶段。现在是老根发新芽的阶段。
反过来看,即可以换句话说:数据库理论的重大发展基本停滞了。(请注意:是“重大发展”非“发展”)。老根固然可以发新芽,但是新芽还有多少生长空间?这从之前的成熟的产品中,可以窥见端倪:如看看Oracle、PostgreSQL、MySQL这样的产品即可观其未来,现有产品都是在补充完善产品化特性(CAP例外,是分布式需求的下诞生的理论,这是数据库理论进步匮乏的20世纪90年代的宝贵产物,但其诞生之时的场景与分布式场景紧密相关,反倒和其初衷(建立分布式数据库的一致性概念)有些背道而驰了。
总得来说,21世纪以来:数据库的革新理论停滞,数据库的工程化产品出现,数据库的COPY化产品涌现。
附:CAP与分布式数据库的关联关系,可参考《分布式数据库原理、架构与实践》一书的第一章,该章详细探讨了CAP的初衷、发展历史、内涵和外延)。

三 从根生长
数据库的根是什么,我们在第一节有讨论。
本文的标题中带有“从根生长”,有2个含义:一是从老根发新芽;二是萌发新根。
老根可发新芽,但前面已述,数据库范围内已难见新芽萌现。接下来,我们来看是否能有新根萌发。
《第三代(分布式)数据库C2DB》即在论述新根与新芽。
1. 所谓的新根,是一套解决老根未曾解决的重大问题而诞生的理论体系。
2. 所谓的新芽,是基于新根而践行的新一代数据库产品,名为C2 DB。
首先,介绍一下我自己。
李海翔,网名“那海蓝蓝”。著有数据库书籍如下。
第一本书,《数据库查询优化器的艺术》,讲述优化器对的技术。其内容全部源自工程实践,是从工程产品PostgreSQL和MySQL的源码中,总结而得的图书,因此分析了大量的源码。从实践中汲取营养,会务实而接地气,能看到理论所未曾涉及的内容并思索其可行性。
第二本书,《数据库事务处理的艺术》,讲述事务处理技术。其内容以工程实践为主(依然分析了PostgreSQL和MySQL的源码),但对事务处理技术的理论有所涉及,在理论指导下进行实践,会更为高效。这样的方式对从事工程实践者有更多帮助。
第三本书,《分布式数据库原理、架构与实践》,从分布式和数据库的事务两个角度切入,研读了数据库事务处理技术方向的数据库理论和大量文献,从中舒展事务处理技术的发展历史和脉络,展示事务处理技术的重要内容,因而更多得包含了理论内容。这其实是对事务处理技术发展历史的一次回溯与思考。把实践和理论结合起来,促使我思考了前述提出的问题:“数据库从哪里来?要到哪里去?”。于是得到了第四本书的源起内容(数据库理论意图解决但未曾完全解决的重大问题)。
第四本书,《一致性与并发》,是一本将出版的新书,理论内容多于实践内容,但理论内容是原创而非对历史文献的研读和梳理。该书以数据库事务处理领域的一致性问题为起点,讨论了一致性的基本问题、一致性如何形式化定义、以100%的一致性为基本要求的背景下数据库事务处理的性能该如何解决,由此形成了一套新的有别于可串行化理论的“新李论”,这是一颗新根。基于该理论体系,另外还讨论一些主流数据库产品的事务处理性能该如何优化等实践内容。该书展示了以串行排队为思想的“可串行化理论”的串行思路与方法,是如何既不能完美解决数据一致性的数据正确性问题,又不能完美解决事务处理技术的性能问题,从而提出如何“既能在100%保证数据一致性的前提下同时最大化事务处理性能”的理论体系、算法实现等。
本次分享的内容,源自《一致性与并发》这本书展示的理论体系。
在最近几年的一些技术会议上,诸如DTCC、DTC、1024程序员节等,我分享了自己对事务处理技术的研究与思考的核心内容。
例如:
2022年的DTCC分享了《分布式事务一致性》,主要谈及了事务的一致性和分布式一致性及他们之间的关系(ACID的C和CAP的C),这是两个领域(事务处理和分布式)下的核心问题,在分布式数据库中相遇而合在一起形成无人区,需要探索和研究。
2023年,DTCC分享了《第三代分布式数据库》,主要谈及了新一代数据库的之所以能为“代”的思路和标准,技术层面讨论了如下图的三个代际标准(极简的易用性、100%的数据正确性和高性能、可控时延的高可用性),这是表层内容。更为深层的,是在探讨数据库产品何以为“代”?(非基于重大、核心问题的产品是否能成“代”?)。目前阶段,有一个有趣的现象:很多很多人喜欢讨论下一代数据库产品,但实际工作时在修正、发布数据库的小特性和一些bug修复,即宣称获得巨大进展甚至为“新一代”数据库产品,这种现象对于各个产品而言无可厚非似乎因为“每家都如此”(或其所谓的“下一代”是自己产品的下一代而非整个行业的下一代);但是这种现象,对于数据库从业者从宏观角度认知整个产业的发展有害——乱花渐欲迷人眼,浅草“已”能没马蹄。
2023年,在CSDN的1024程序员节分享了《数据库的红与黑—事务处理技术的暗礁》,探讨了事务处理领域的重要、核心的、但又未曾完美解决的问题,如数据异常、隔离级别、并发算法(和可串行化理论——之所以用括号括起来可串行化理论,是因为这是重大问题在下一个分享中进行了单独探讨)等。
2024年,在中国数据技术大会DTC上分享了 《从根说起—可串行化理论的光与影》,探讨了事务处理技术的核心、经典理论、数据库的黄金圣律——可串行化理论——所存在的问题,这个分享是对以上各个分享的内容延展和升华。这个分享颇为“大胆”地“质疑”了可串行化理论,有似离经叛道之为,但恰是一丝火一点星光,点燃和激发了我不断思考和探索。

这一系列的深度思考,如今又有了更多更深的结果,今天的分享,是这一些分享背后多年思索、探索的结果,也是我的新书《一致性与并发》的部分内容。因此梳理这些分享的内容和其后的思考内容,以形成一个系列的思路和脉络,铺就一条清晰直观的路径,和大家共享,便于读者从中理解基本问题、解决方法,从而理解新思想、新理论体系下的新思路和新方法。
在新的理论体系下,我们来谈今天分享的主要内容,如下图,技术层面集中在可串行化理论方面的一个反直观认知的内容上——“一致性和并发性能不可兼得”,这是一个鱼和熊掌是否可兼得的问题,但是在《一致性与并发》一书的理论体系中,这却是一个“鱼和熊掌可兼得”的问题。
所以,我们提出:“100%保证数据一致性的前提下,同时最大化并发性能”。其中,每一个100%都是可串行化理论未曾明确过的问题且未曾完美解决的问题,而“同时”做到这两个100,更是难以企及的挑战和目标。
今天的分享,我们就来高标准、高要求地探讨这个重要的、核心的问题。
其中,提及的“C2DB”中的“C2”,是两个英文单词的缩写“Consistency和Concurrent”,两个“C”,即两个100%的目标,其代表的是后面将提及的《一致性与并发》理论。
未完,待续......


扫码加关注,知数行云,专业有深度
声明:本文禁止用于开发“任何软件程序,包括但不限于训练机器学习或人工智能(AI)系统”。
原文作者:那海蓝蓝知数行云;如有侵权,请联系管理员删除。

