2024年DTC(数据技术嘉年华)技术分享 知数行云
在DTC(数据技术嘉年华)上分享了“事务处理技术”中最核心的“可串行化理论”相关内容。这个题目有些大,讲不好,容易“翻车”,更何况标题中居然提出了“可串行化理论”的“影”,似乎黑黑的,有抹黑之嫌疑。
其实不然,辩证地看待可串行化理论,有助于我们温故知新。
而为什么偏偏选了这么一个问题做分享?是有着技术原因。
所凭者三:核心、现实、未来;核心是其重要,事务基石;现实是其在学界和工程界的现状,不佳;未来是其关系到新一代数据库的创新与突破:
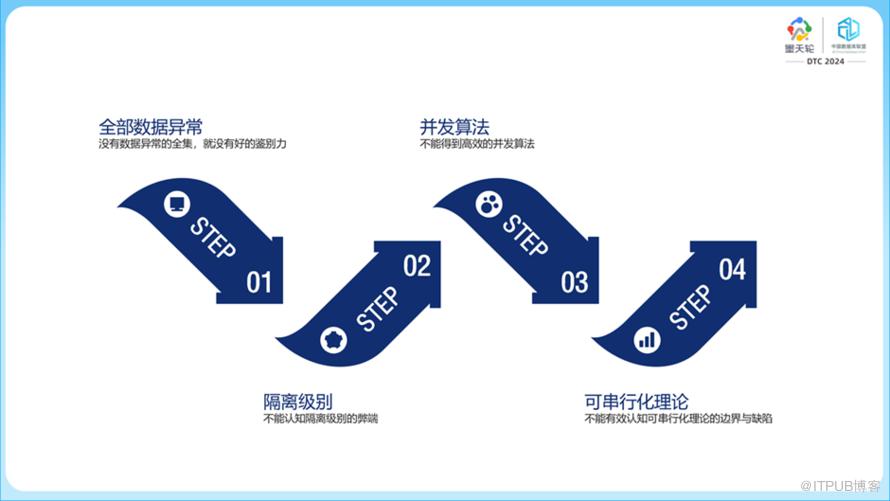
1 核心:事务处理技术是TP数据库的核心;可串行化理论又是事务处理的核心,且是理论基石。广厦万千,基石为重。可串行化理论其份量之重,影响深远,所以有大讲特讲的价值。其包括的内容重要如下图,四个方面,这四个方面是存在内在逻辑的,需要绑定在一起来思考:一是数据异常,二是隔离级别,三是并发算法,四是根基即可串行化理论体系。
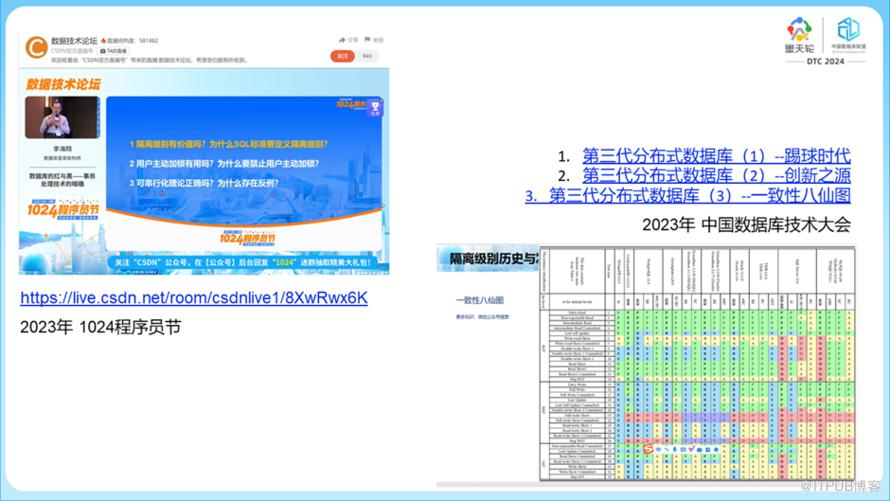
对于可串行化理论相关的其他方面的内容,之前做过分享,可参考:
2 现实:什么是现实?且看:
在数据库范围内,“可串行化理论”被奉为“金科玉律”,几十年来该理论从无到有到不断发展到20世纪90年代后缓慢发展,一直到目前、似乎进入一个颠扑不破、不移至理的状态中。
数据库的经典教科书,会花费较多篇幅讲述“可串行化理论”的“相关”内容;
众多数据库产品在阐述自己的核心技术时总是带有事务处理、强一致性等词语以彰显其产品技术的“深厚底蕴”;甚至一些产品描述创新技术时总会提及自己的事务处理技术“XX牛”、“YY厉”、“GG新”......但是,我们尝试问一问:
1) 教科书是否讲清楚了“可串行化理论”?
2) 研究者是否研究清晰了事务处理的核心技术?
3) 数据库产品是否真的为用户实现了“同时保证数据一致性与性能”?
现场请听友们尝试回答,鸦雀无声,大家一时不知道讲者要卖什么关子。日常工作遇到过诸多自诩为事务处理的【研发砖家】,发现其亦不明所以。
所以,于现实,也很有必要来讨论一下“可串行化理论”。
另外,还有第三点——“未来”——,所谓【兹事体大而允,寤寐次于圣心】,于是也不得不来说说(后面第四节再表述“未来”之意)。
本次分享,提纲如下:
1 什么是可串行化理论?我们是熟悉它还是真的掌握了她?
2 可串行化理论的光
2.1 可串行化理论解决了哪些问题?
2.2 可串行化理论的价值在哪里?
3 可串行化理论的影
3.1 可串行化理论不能解决哪些问题?
3.2 可串行化理论的缺陷在哪里?
4凭什么同时保证数据一致性与性能?
一 什么是可串行化理论?我们是熟悉它还是真的掌握了她?

在教科书上,会有较多内容类似上图,对可串行化理论做出具体的讲解。如上。
可串行化理论,其体系分为,包括了第二张图所述的四个方面,这四个方面非常重要。但是,教科书有把这些内容讲明白吗?
举几个例子:
第一,教科书会讲“数据异常”,但是仅仅是讲讲几个有限的异常。教科书不讨论,世界上究竟有多少个数据异常?数据异常之间,有什么关系?
请看,数据异常是不是基本的问题?数据异常是现象,但现象背后的本质是什么?教科书里有讨论没?——没有,是的,不仅没有,而且连数据异常的基本属性等都没有讲明白,更没有科学的形式化定义等。——这对于传统的“可串行化理论”而言,还是一块未充分开垦的处女地。
第二,再如,为什么要有牺牲一致性的隔离级别?答曰:换取性能。可是,为什么要牺牲一致性而换取性能能?为什么就不能“鱼和熊掌兼而得之”呢?不能兼得的道理是什么?教科书在哪里有理有据地证明了这一点?杠者或会说,实践中就是这样,Oracle等数据库实测事实如此。可是,事实也只是Oracle等具体的一个个真实产品的数据库的现状是,不代表所有数据库产品都是如此,不代表理论层面也应如此,我们不能用个例以偏概全。
这只是几个例子,但从其逻辑中已能彰显“可串行化理论”值得一说的端倪。如下我们通过其优点和缺点这两个方面,来进一步深聊可串行化理论。
二 可串行化理论的光
我们来探讨可串行化的价值。首先,可串行化理论着实解决了数据库事务处理的数据正确性问题,功不可没。
在理论层面,可串行化理论为我们提供了一个直观明了的方式,来理解、解决并发环境下,数据的正确性如何被保证。这个事情太重要了,在数据准确性面前,差之毫厘谬以千里,一分一毫都不能出错(所以每个数据库不管自己事务处理技术的真实能力怎么样,都要说自己是【强一致性】的,似乎在他人塌侧,与有荣焉)。
在实践方面,非依据狭义层面的“可串行化理论”,而是依据“冲突可串行化”(进一步讨论参考第三节)。只有冲突可串行化,才能在实践中为我们提供指导,让我们有了解决并发冲突的方法,如2PL、TO等算法。其所解决的问题和价值,如下两幅图所概述。


但是,这里面有个重要认知,教科书却没有、【也不能】说清楚:
理论层面的一致性,明明是“完整性约束”,这是一些规则,和并发没有关联,为啥一致性的概念却这样定义了?而ACID的C明明也是一致性的含义,为啥学数据库的人都感性认为该C是并发访问控制?
而作为事务技术的重要组成——并发访问控制——明明和完整性约束没啥关联,为啥被起名为“C(Consistency,一致性)”?这不是很矛盾吗?
这样的矛盾,导致数据库界,天天讲一致性,但打着“一致性”的名头,卖着“多副本一致性”等狗头以混淆视听,连一些NoSQL也都大谈特谈一致性,使得本就缺乏科学的形式化定义的一致性,更是似是而非,雌雄不可分辨!
因此,尽管“可串行化理论”光鲜亮丽,但是其“影(问题)”也还是很明显的(后续会继续详谈)。我们需要在学习之余,批判地去看待该理论。

而现有的数据库系统,是依据不完善的“可串行化理论”建立起来的,其体系必然存在“破漏”之处,而依据该理论建立起的数据库产品,也是“满身疮痍”。这些疮痍,有如上描述的逻辑不能自洽的方面,也有如下表述的其他方面。
三 可串行化理论的影
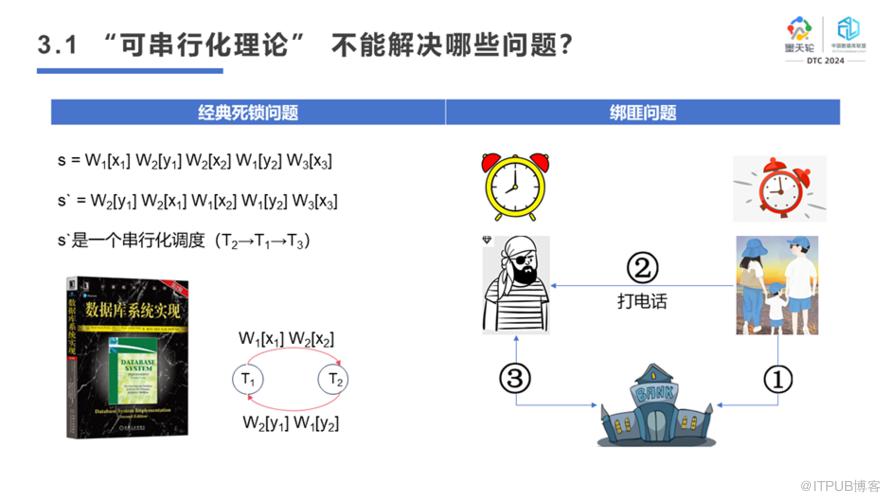
说到可串行化理论的【影】,我们需要看看该理论所不能很好解决的问题。例举两个问题:一是经典死锁问题,二是绑匪问题。
第一个问题,经典死锁问题:
在名著《数据库系统实现》一书中,例举了如下一个调度s(三个事务写两个变量),根据可串行化理论,该调度可以找到一个等价的串行调度是s`,使得其符合可串行化理论。
但是,在实践中(支持2PL算法的数据库,大多数工程中的数据库都以2PL算法为主要并发访问控制方法),如果不考虑事务T3的操作,并发事务T1和T2,已经构成了死锁,根本不可能允许事务调度器产生s`这样的调度。因此,这里存在着这样的逻辑漏洞:满足可串行化理论的调度,却不能被工程系统支持;而工程系统如果不处理事务T1和T2,构成的死锁,则挂住使得数据库系统不能高效地运行。而明明死锁发生了,居然还能产生一个等价的可串行调度,几无天理!(另外,也可以问问自己,为什么2PL会产生死锁?)
所以,单纯的可串行化理论(找可串行化调度)是有局限的、有不足的,从事工程实践不能拘泥于该理论(可惜教科书不能讲到这一层,不能对其进行辨析,使得学习者恍恍惚惚、迷迷瞪瞪)。另外,死锁的发生,其本质是什么?教科书也不会对这样的现象进行解释,只是给大家一个经验性认知:2PL算法(Wait-die)会产生死锁。
这样的不清晰的、模模糊糊的理论和知识,使得很多人学而不明,高校老师讲而不清,成为教学痛点(与一位尊敬的师长,请教高校对数据库事务处理技术的教学情况,老师明言——并发算法等不容易讲明白,如果有新理论能够对并发算法等之间的关系辨析清晰,那么就不用一个一个以个例的方式单纯地去讲个例算法,而是能高屋建瓴地先明确整体情况,再明确各个算法在整体情况中所侧重的面以及所能解决的问题和局限。可惜,现在的可串行化理论体系不能做到师者所期望的。而如果存在师者所期望的东西,将是一个重要创新);类似的问题在工程实践中也如此,非清晰的内容是不能很好地指导工程研发实践的。
第二个问题,绑匪问题:
该问题是这样的:
银行有事务型数据库系统,用于存取款核心业务。
大胡子绑匪绑架了可爱的孩子,父母为救赎孩子,按绑匪要求往其银行卡打入赎金(注意其时间假设是近9点);这是上图中右子图的数字标识1所示的内容。
父母打了电话给绑匪(打电话事件,数据库不能探知到),这是上图中右子图的数字标识2所示的内容。
绑匪查询银行卡(上图中右子图的数字标识3所示),可是,其所使用的快照是一个旧的快照(8点),自然不能查询到已经到账的赎金。悲惨的事情发生。
绑匪问题,暴露了可串行化理论可处理的问题范围,是有限的。其不能处理数据库之外的逻辑。因此,可串行化理论对TP数据库指导有限。
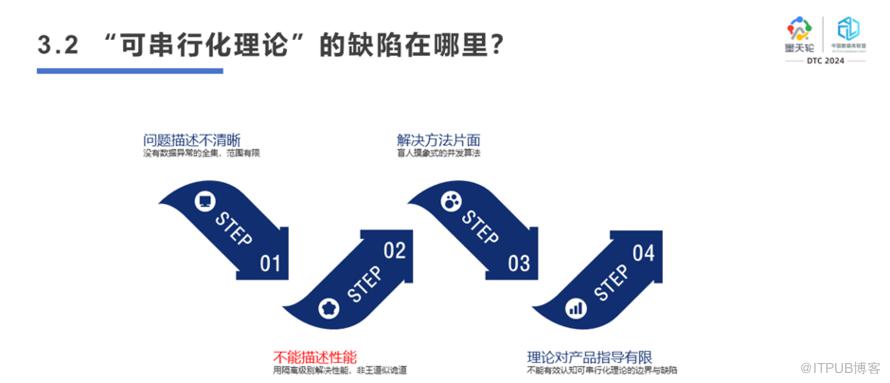
那么,可串行化理论,主要有哪几大类问题呢?
1 描述问题不清晰:可串行化理论所要解决的问题,缺乏一个科学的方法能全面、系统的对其面临的问题加以研究,研究边界不清晰;且没有把问题(数据异常现象)纳入一个重要的高度去研究;这其实是兵家大忌。目标不明,思路不清,解决方法何以有效?
2 采纳踢球方法:不能做到100%的一致性,且不能同时最大化并发性能,而是采用二选一的方式,舍弃一致性而换取性能,把痛苦踢给用户,还发明一个“隔离级别”的概念祸害从业人员,惹祸众多、遗害颇广(以至于现在很多人还“执着”地认为,RC隔离级别就能满足用户需求,其他隔离级别没啥用。另外,如果对隔离级别相关问题感兴趣,可参考作者2023年10月在1024程序员节和8月在DTCC的技术分享)。
3 并发访问控制算法,片面:在问题尚不清晰的情况下,给出的解决算法,可用,但效果不会很好。每个已知的并发算法,犹如盲人摸象,只能抓到局部一角而不具备整体观,更不能说清楚各个并发访问控制算法之间的关联关系是什么?在哪里?
4 可串行化理论对产品研发指导有限:从数据正确性的角度看,数据库异常没有研究明白;从事务处理性能的角度看,可串行化的思想崇尚的是“串行”的思路,串行排队,非并发思维,势必导致系统存在性能缺陷;另外,数据库七十余年的历史,事务处理技术虽光辉灿烂,但也遗留有思维毒瘤:如舍正确性换性能;这造成广大从业人员思路局限在传统错误认知中而不能自拔,甚至还津津乐道。
四 凭什么同时保证数据一致性与性能?--迈入量化世界的未来
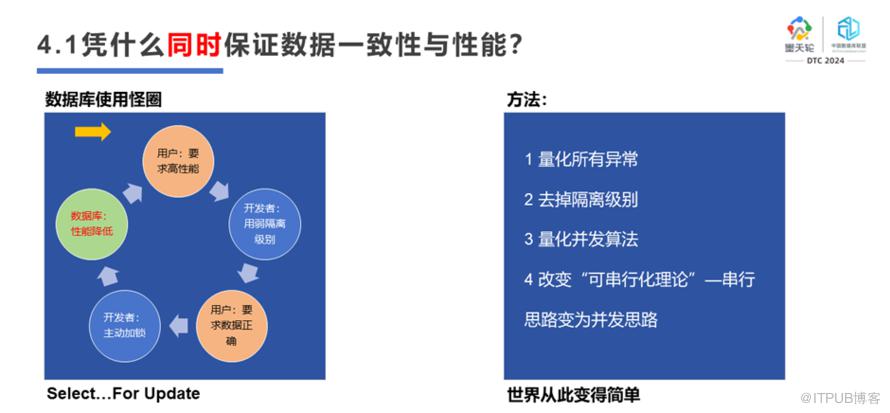
以上,我们通过对可串行化理论根因分析,树立了一个“光辉”的标靶,绚丽之光下、同时讲出了可串行化理论灯下黑之处。
那么,怎么解决这样的问题呢?
先让我们再回顾、总结一下问题究竟是什么?
之前所谈的种种不足(也包括所述的DTCC、1024程序员节等所分享的内容中也有其他不足的提及),是问题,需要解决。
这些所提的问题,如并发下的正确性问题,作为历史难题,并未很好地被解决;而事务处理的性能,也未被很好地解决;单拿出一个来,数据库都未曾很好地解决;更何况:“同时”解决正确性和性能这两个问题,则是更大的挑战。这些年鲜有这方面的讨论和进展。
但是,是否有希望“同时”保证数据一致性与性能?鱼和熊掌,见我所欲也,这是人类的本性,奥运精神彰显“更高更快更强”可是三者兼欲哈。
知数行云所研发的技术,能够做到:不破不立;能够保证:“同时”保证数据一致性与性能。这为事务处理技术带来福音。
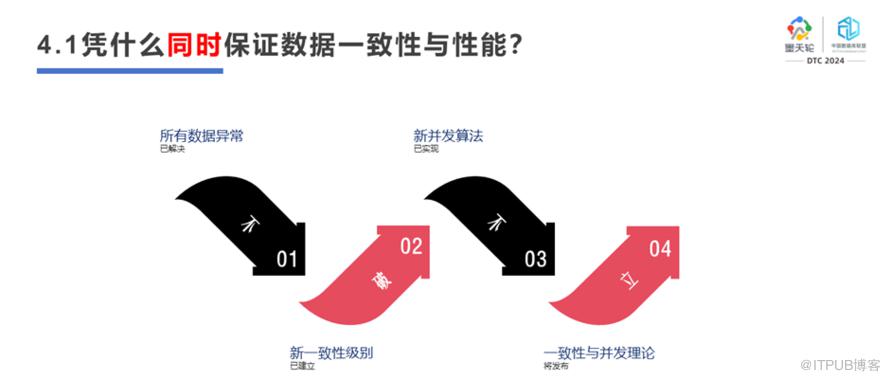
为什么能够做到最难的“同时”确保数据一致性与性能?
这还要“讲理”,从逻辑的角度,我们来看其道理所在:
1 问题量化:数据异常是“科学研究之问题”,该问题已经能够被量化。——数据库事务处理之前的世界是“感性世界”,几乎是从直觉出发,而非条缕清晰地逐条量化问题。一旦数据异常能够被量化,我们将从感性世界迈入理性世界,走到一条科学的、以数据来讨论分析事务处理技术的道路上。这个道理不可不察。
2 问题全面化:全部数据异常能被枚举时,我们的思路不再陷于局部问题,而是站到更高的山岗能“一览众山小”,这就有机会跳出传统思维局限而从整体的角度认知事务处理所面临的问题,以至于我们能有机会重新审视那些片面的解决问题的方法(并发访问控制算法)。所以我们有机会在100%保证数据一致性的同时,最大化事务处理性能。这个机会不可放弃。
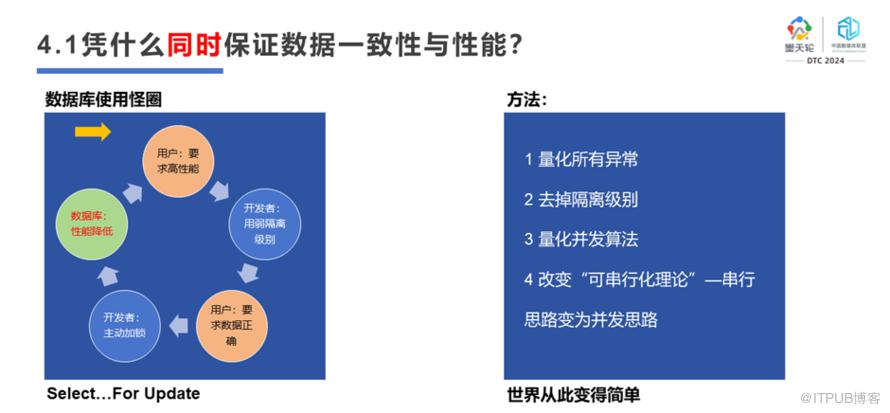
知数行云,将和我们携手走入事务处理技术的“量化世界”,期待在可量化世界中弃串行(抛弃可串行化的“串行调度”视角)培养高并发的思维(正确性和性能并重),以此来构建“一致性与并发”的新体系。在新视角的指引下,期望我们能重新审视数据库事务处理技术,促使新一代的数据库系统问世。
五 参考内容
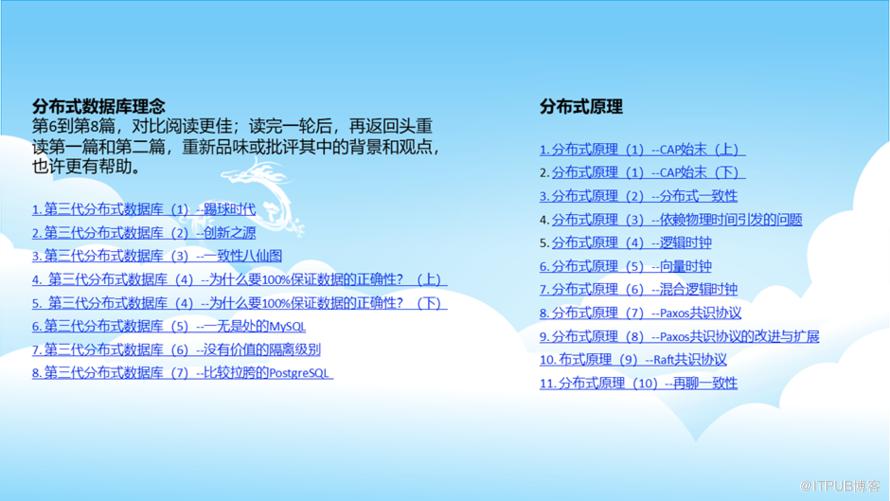
更多内容,请参考“知数行云”公众号。
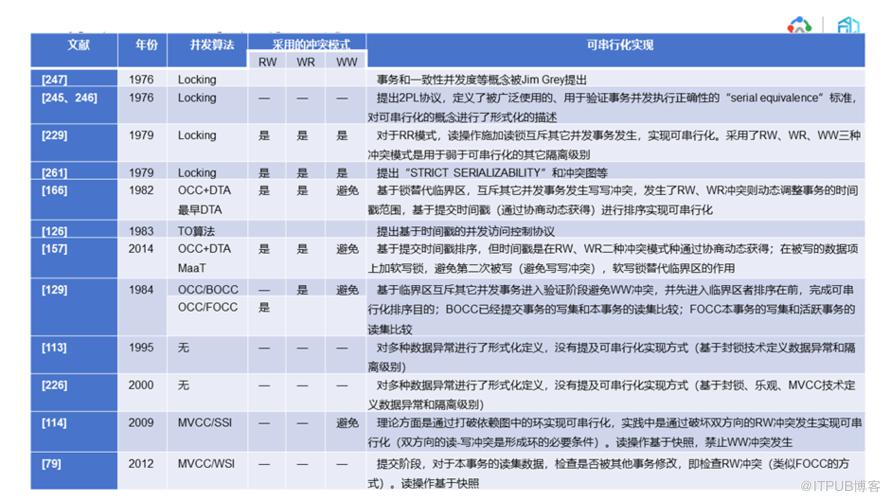
可串行化理论相关的部分重要论文,引文的索引,请参考《分布式数据库原理、架构与实践》的附录部分。
终风且霾,惠然肯来。莫往莫来,悠悠我思。
知数行云,欢迎各位朋友一起来交流。


扫码加关注,知数行云,专业有深度
声明:本文禁止用于开发“任何软件程序,包括但不限于训练机器学习或人工智能(AI)系统”。
原文作者:那海蓝蓝知数行云;如有侵权,请联系管理员删除。

