
上一篇《分布式原理(7)--Paxos共识协议》讨论的是最简单的Paxos协议(Basic Paxos),在实际使用中,有很多基于Paxos的优化变种,在保证一致性协议正确的前提下,旨在减少Paxos决议通信步骤、避免单点故障、实现节点负载均衡,从而降低延时、增加吞吐量,提高了可用性。
尽管如下的改进算法解决了一部分问题,但是,Paxos算法中,领导者这个角色实际上使得分布式系统中引入了单点故障。虽然Paxos能够在给定条件下进行Leader选举使得故障恢复,但是这种恢复可能慢,使得系统在一段时间内不可用,这消弱了分布式系统的可用性。
如下讨论几种改进的Paxos算法。

Multi-Paxos
使用Basic Paxos可为一次“协商”达成一致。但是,如果有一组连续的被接受的值(value)需要达成一致,多轮完整的Basic Paxos协议耗时太多(每轮都需要prepare)。
如果Leader是相对稳定不变的,则在Basic Paxos协议中的第1阶段(Prepare阶段)就可省略。Multi-Paxos就是在同一个Leader执行每轮Paxos算法时,提案编号“I”每次递增一个值,并与每个值一起发送。Multi-Paxos在没有故障发生的时候,将消息延迟(从propose阶段到learn阶段)从4次延迟降低为2次延迟。如下是Multi-Paxos协议的示意过程[1](V=(Va,Vb,Vc)中最新的一个)。
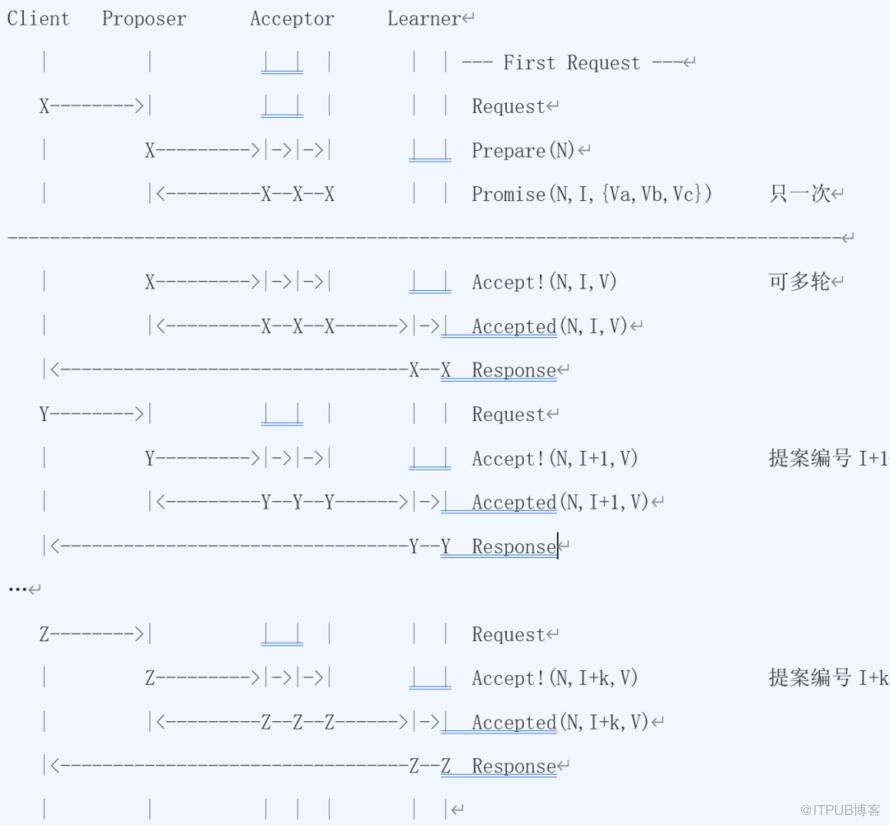
在分布式事务型数据库中,实现Paxos的提交协议(用于事务的提交阶段),是在每个事务内部,在提交阶段,多副本节点间达成数据一致时,由事务的执行者作为上图中的“Client”发起Paxos协议。在分布式存储方面,实现多副本的数据一致性,可以把REDO日志作为副本间传递的消息,然后在Follower角色的副本上执行REDO日志的Apply操作以保证数据之间的一致性。
Fast-Paxos
在Multi-Paxos中,基本过程为proposer -> Leader -> acceptor -> learner,即从提议到完成决议共经过3次通信,这样的通讯次数较多,导致处理周期长且网络不可靠性发生机会变大。那么,能不能减少通信次数?这是Fast-Paxos所考虑的问题。
文献[5]对Multi-Paxos改进:如果可以自由提议value,则可以让proposer直接发起提议,Leader退出通信过程,变为proposer -> acceptor -> learner,由此从提议到完成决议共经过2次通信,这就是Fast-Paxos的由来。
Fast-Paxos虽然允许2个消息延迟,但增加了额外要求:
1. 系统由3f+1个物理节点(或参与角色)组成,可容忍最多f个错误(而不是Basic-Paxos的2f+1,2f+1表明只要是多数派即可)。
2. 客户端需要直接将请求发送到多个目标。
如果Leader没有提议任何value,则客户可以直接发送Accept消息到向接收方。Acceptor向Leader和每个Learner发送Accepted的消息,从而实现从客户端到Learner的2个消息延迟。如下示意过程[2],Leader下有1条竖线,Acceptor下有4条竖线,Learner下有2条竖线,表示满足“1+4+2=7=3*2+1”,即能容忍2个错误(2个物理节点或2个角色对应的物理节点),但是需要注意的是,本示例中,Leader不具备Acceptor的角色:

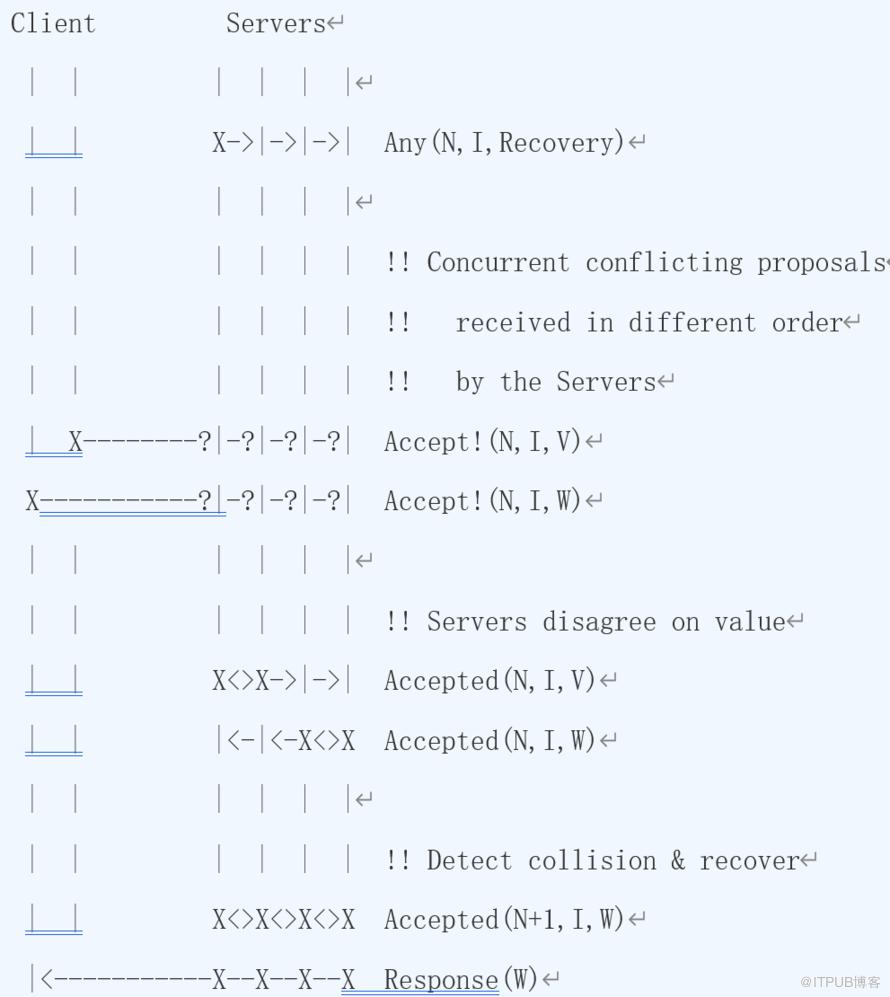
在Basic Paxos中,Acceptor投票后收到的value都是Leader选择好的,不存在同一轮Paxos中对多个Value进行投票的情况。但在Fast-Paxos中因为允许多个Proposer同时提交不同的Value到Acceptor,将导致在Fast-Paxos中没有任何value被作为最终决议,这种情况称为“冲突”(Collision)。
如果Leader检测到冲突,它通过发起新一轮投票,并发送Accept消息来解决冲突(如下阴影部分),通常是一个Accepted消息。这种有协调者参与的冲突恢复机制需要4个从客户端到Learner的消息延迟。如下示意过程:

如果Leader提前指定了一种冲突恢复机制,可以实现一种优化:即允许Acceptors自己执行冲突恢复。因此,无协调的冲突恢复可能实现三个消息延迟(如果所有的Learner都是接收者,那么只有两个消息延迟),如下示意过程[3]:

Flexible Paxos
Basic-Paxos、Multi-Paxos和Fast-Paxos的prepare和propose阶段都需要“majority quorum”,这点能保证任意的quorum之间交集不为空(后发起prepare阶段的Proposer需要学习之前已经被接受的其他Proposer请求过的值,并将该值作为自己propose请求的值。为了保证后发起prepare阶段的Proposer不遗漏任何被接受的值,Paxos算法的两个阶段的quorum需要彼此相交),如此才能使得使用Paxos算法就某结果达成一致。
文献[1]提出Flexible Paxos(简写为FPaxos),证明了在Paxos算法的两个阶段中, 只需要这两个阶段的quorum有交集就行, 并不需要两个阶段的quorum 都是集群中的“majority quorum”(这是该文献给出的三种策略的基础)。
该文定义:集群中有n 个节点,Q1是第一阶段prepare阶段需要达成的quorum的个数,Q2 是第二阶段propose阶段需要达成的quorum的个数。只需要Prepare-quorum(Q1)和Propose-quorum(Q2)相交,则可保证一致性的达成。如此,能提高Multi-Paxos的性能。其基本思路为:Multi-Paxos的Q2比Q1执行的次数多很多,增大Q1的大小,则可减小Q2的大小,就能减少了propose阶段Q2个Acceptor达成一致的时间(propose阶段参与投票的Acceptor个数变少,使得投票表决过程加快)。但是,增大Q1的大小,意味着Leader选举阶段投票人增多,耗时增加,如果投票人跨数据中心,投票操作就成为一个耗时操作(文献[253]给出的DPaxos算法意图解决此问题)。
文献[1]提出三种实现策略,分别为:
1. Majority Quorums:对于Multi-Paxos,当N为奇数时,没有优化,即本策略蜕化为未改进的Multi-Paxos方式。当N为偶数时,需要保证Q1>N/2+1且Q2 >N/2+1(所有Acceptor的数目记为N,后同),即要求Q1、Q2都至少为N/2+1。对于FPaxos,则可以将Q2降低到N/2(Acceptor数,也即可以容忍的“fault-tolerance”数),如此仍然可保证两个阶段的quorums之间是相交的。这样,可以减少延迟并提高吞吐量,还能提高系统的容错性(尽管可能只有1个Acceptor的差异导致效果提升不明显)。
2. Simple Quorums:确保Q1+Q2>N且Q1>Q2且Q1>N-Q2+1满足,可减少Q2的大小,以提高效率(prepare阶段的效率降低换来propose阶段的高效)。如此的方式,可带来一个这样的效果:当前的Leader crash,需要重新选举Leader;此时,即使N-Q2个节点crash(不能组成prepare-quorum),但在当前Leader crash以前,已经crash的N-Q2个节点中有部分节点如能恢复使得在线节点数大于等于Q1,那么FPaxos依旧能正常工作。整个系统可以容忍的Acceptor节点宕机数是MIN(Q1, Q2)-1。
3. Grid Quorums:将N个Acceptor节点组织为N2×N1的如图3-3的网格,N2表示行数,N1表示列数,左子图(a)对应Paxos算法,右子图(b)对应FPaxos算法。
a) 对于Paxos算法,quorums值以从N的大多数降低到N1+N2-1。可容忍的Acceptor节点宕机数为MIN(N1,N2),只要网格至少还剩下一行和一列(强调未宕机的个数),系统还能保证一致性。
b) 对于FPaxos算法,Q1为N2行中的一整行,Q2为N1列中的一整列。这样,任意的Q1和Q2所代表的行、列必然是相交的。只需要调整网格的行列长度,即可调整Q1和Q2的大小。但是,在网格中,每个节点不是对等的。假如每一行均有一个节点宕机,则不能找出合适的Q2列。整个系统可以容忍的Acceptor节点宕机数不是一个固定的值,而是在[MIN(N1, N2), (N1-1)×(N2-1)]区间内,需要特别考虑哪些节点未宕机尚能达成一致。
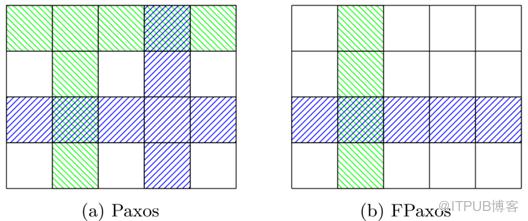
图1文献[1],对于一个有20个Acceptor的quorums的使用5×4网格的示例
FPaxos算法,除了适用Paxos算法的应用场景,还可以解决跨机房部署时如何安排多副本的分布场景(当多副本需要跨多个机房, 每个机房内部也需有多副本时)。例如,有两个数据中心, 每个数据中心有2个副本,使用Paxos算法需要跨数据中心才能达到“majority quorum”的要求(4个副本至少要3个达成一致),而使用FPaxos算法只要Leader没有宕机则只需要在与Leader相同的数据中心内即可达成一致(如4个副本形成2×2的网格则有2个副本即可达成一致)。
与文献[1]为同一位作者的Heidi Howard在文献[2]中对文献[3]提出的Paxos算法提出了质疑:“我们重新研究了Paxos如何解决分布式共识的基础。我们的假设是,这些限制并不是共识问题所固有的,而是Paxos方法特有的”。
该文指出:分布式共识,是指如何在面对故障和异步时可靠地达成一致。这对于分布式系统很重要。一旦解决了该问题,就可以用不可靠的组件构建可靠的分布式系统。该文认为,所谓分布式共识,其特征在于两个保证:
1.第一,安全保证:所有的决策都是最终的,不需要假设可靠性或同步性。
2.第二,进度保证:最终将达成一个决策。
3. 两个保证之间的关系:如果不对同步性或可靠性做出假设,就无法保证进展;即没有安全保证就无进度保证,最终分布式系统中的各方就不能达成一致获得共识。因此,解决共识的算法旨在保证在最弱的活跃度假设下的进展。

Dynamic Paxos
文献[4]提出Dynamic Paxos(简写为DPaxos),该技术适合移动应用、车载应用等场景,即数据非集中化存储而是位于边缘节点[4]。故其特点是,节点多且分散部署,数据以分片的形式分布在边界节点(edge nodes)。此种场景下,为支持高可用和高可靠的应用,采用multi-paxos协议会出现延迟过大的问题,造成此问题的主要一个原因是访问数据中心的延迟(10-100ms级)较大,因此解决此问题可把数据在边缘节点上部署,DPaxos算法则充分利用边界节点的计算资源,在访问位置上,从附近的边缘节点提供请求,直接在边界节点进行事务处理;在数据移动层面,分区副本实时跟踪移动用户;并提供了灵活的容错机制,可以使用附近的边缘节点从故障中恢复。
但是DPaxos实现的状态机复制(SMR)的延迟会较大地影响系统的性能和用户体验,所以DPaxos针对性对其面对的场景和FPaxos算法的缺点(Leader选举阶段的耗时昂贵),提出了Zone-centric Quorums和Dynamic Quorum Allocation两种解决技术。
首先,Zone-centric Quorums技术,采用FPaxos算法的思想,把所有的Quorums化整为零,把相邻的“edge nodes”(边界节点)作为“zone”(区),并以zone作为Paxos算法中的quorum,且zone内的quorum们为其内部的edge nodes,由此完成对所有Quorums的划分。对采用了majority quorum思想的算法为例,每次选举需要majority zones赞同,而每个zone则需要其内部的majority edge nodes赞同。在DPaxos算法适用的场景中,一个重要的前提是“多副本间的复制(replication)远频繁于Leader选举事件”,而replication操作频繁发生在一个zone中,因此,根据FPaxos,如将replication quorums设置得很小,如限定于一个zone包括的“edge nodes”个数,则replication quorums的延迟即被限制在一个zone的内部节点的通信延迟内,如此降低频繁发生的replication quorums的总延迟,从而提高应用的性能。
另外,DPaxos提出了Expanding Quorums和Leader Handoff技术。Expanding Quorums技术克服了FPaxos技术的Q1和Q2必须相交的限制(Inter_Intersection),且允许“Leader Election”和“replication quorums”的成员数都可以较少。Leader Handoff技术克服了移动类应用需要频繁变更Leader而提出Leader Handoff的优化,使得不经过Leader election阶段来主动切换Leader(采用单轮消息机制使得Leader角色被快速从旧的Leader切换到新的Leader上)。
上一篇《分布式原理(7)--Paxos共识协议》发出后,有网友留言说:
Paxos难以理解是因为我们难以直观的理解为什么这个算法要这么设计,当然我们可以用具体的实例去验证它是正确的,甚至可以通过严密的数学论证来说服自己它是正确的,但是始终难以回答:为什么它能起作用,不采用这些规则是不是就不行。关于Paxos算法的一个直观解释,可以参见 https://mp.weixin.qq.com/s/CVa_gUdCtdMEURs40CiXsA
拜读大作,好文,共同学习。

脚注参考:
[1] 更多信息可参考:https://zh.wikipedia.org/zh-cn/Paxos%E7%AE%97%E6%B3%95
[2] 更多信息可参考:https://zh.wikipedia.org/zh-cn/Paxos%E7%AE%97%E6%B3%95
[3] 更多信息可参考:https://zh.wikipedia.org/zh-cn/Paxos%E7%AE%97%E6%B3%95
[4] 现实情况是:现在只有20%的数据在内部生成和消费,80%的数据来自于外部来源。
文献参考:
[1] Heidi Howard, Dahlia Malkhi, and Alexander Spiegelman: “Flexible Paxos: Quorum Intersection Revisited,” arXiv:1608.06696, August 24, 2016.
[2] Heidi Howard:Distributed consensus revised, https://www.cl.cam.ac.uk/techreports/UCAM-CL-TR-935.pdf
[3] Leslie Lamport. The part-time parliament. ACM Transactions on Computer Systems, 16(2):133{169, May 1998.
[4] Nawab, Faisal, Divyakant Agrawal, and Amr El Abbadi. "DPaxos: Managing Data Closer to Users for Low-Latency and Mobile Applications." Proceedings of the 2018 International Conference on Management of Data. ACM, 2018.
[5] Leslie Lamport: Fast Paxos. Distributed Computing 19(2): 79-103 (2006)
扫码加关注,知数行云,专业有深度
声明:本文禁止用于开发“任何软件程序,包括但不限于训练机器学习或人工智能(AI)系统”。
原文作者:那海蓝蓝知数行云;如有侵权,请联系管理员删除。

