上期我们聊完时序压缩:再好的压缩算法,也离不开底层读写模型的配合。很多人直接拿 MySQL、PostgreSQL 这类传统关系库的思维去理解时序库,很容易产生一个疑问:为什么同样是存数据,时序库写入、查询的性能差距能拉开几十上百倍?
核心根源在于: 时序数据库从设计之初,就抛弃了传统数据库以随机读写为核心的范式,转向适配时序数据特征的「批量写入 + 顺序读取 + 预聚合」专属读写范式。
传统数据库面向事务、随机增删改、单点查询设计;而时序数据天然自带时间维度,数据按时间流持续产生,业务查询大多是“按时间区间拉取测点”。这两种截然不同的数据访问模式,催生出两套完全不一样的存储读写逻辑。
阅读提示:本篇聚焦理论范式,不讨论 SQL 语法、参数调优,我们先理清时序读写和传统随机读写的本质差异。
一、先分清:传统数据库随机读写范式 VS 时序库时序读写范式
传统关系数据库(MySQL 等)的核心假设:数据访问是随机的。一条数据可能随时被单点写入、随机更新、按主键单点查询、任意字段过滤。为了支撑随机访问,依赖索引、B+ 树、页缓存,大量 IO 是随机 IO。随机 IO 的磁盘开销很高,这也是为什么关系库很难扛住百万测点持续高频写入。
时序数据库的核心假设完全反过来:数据是 流式追加,绝大多数写入是源源不断的测点数据流;绝大多数查询是 给定时间范围 + 测点,区间扫描读取,很少做无时间范围的随机单点查询。
我们用表格直观对比两套范式:
| 对比维度 | 传统数据库随机读写 | 时序数据库读写范式 |
|---|---|---|
| 写入模式 | 随机插入、更新、删除 | 流式追加、批量写入 |
| 查询模式 | 单点查询、任意字段过滤 | 按时间范围和测点扫描 |
| 存储组织 | 索引、B+ 树、页缓存 | 时间有序数据块、列式组织 |
| 主要 IO | 随机 IO | 顺序 IO |
| 典型优化 | 索引与事务优化 | 批量写入、顺序读取、预聚合 |
二、批量写入:时序写入范式的根基,为什么不能一条一条写?
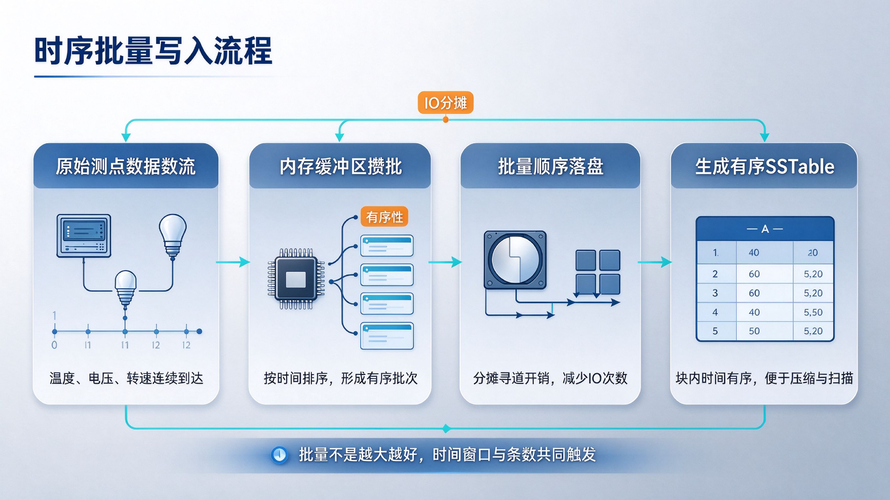
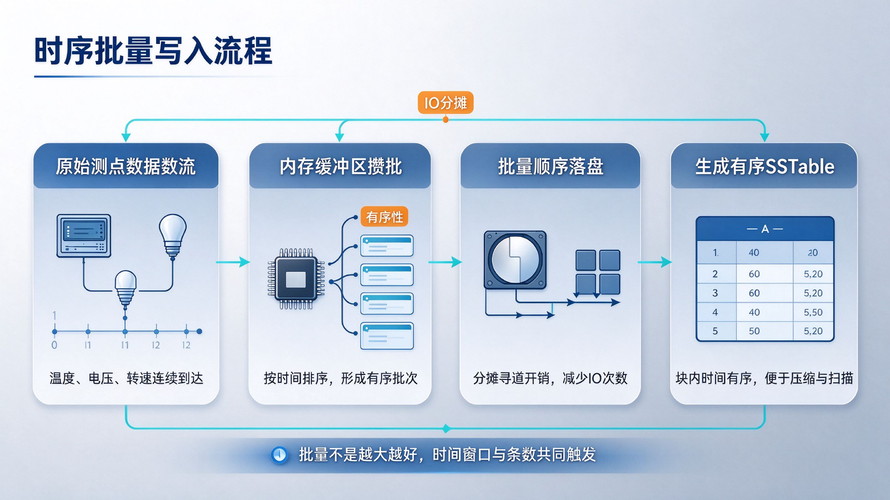
时序数据的写入,最核心的优化思路就是 批量(Batch)写入。从理论层面看,磁盘硬件本身有一个底层特性:顺序 IO 的吞吐远高于零散随机 IO。磁盘寻道、磁头移动是开销大头,每一次 IO 请求,固定的寻道开销占比极高。如果一条一条写入测点:每一条都触发一次 IO,大量时间浪费在磁头寻道上,硬件能力根本跑不满。
批量写入的数学逻辑:把短时间窗口内、同设备/同测点组的多条时序数据,先在内存缓冲区攒成一个有序批次, 一次 IO 写入一整块连续数据,分摊单次 IO 的固定寻道开销。
批量写入的理论收益来源三点:
- 分摊 IO 开销:N 条数据合并一次 IO,寻道成本被 N 条数据分摊;
- 维持数据有序:在内存 buffer 内按时间排序,保证落盘后文件内部时间有序;
- 为后续压缩铺路:有序连续的序列,才能让差分、Gorilla 浮点压缩拿到理想压缩比。
这里有一个理论边界:批量不是越大越好。批次太大,内存占用上升、单批次故障丢失的数据变多;批次太小,分摊效果弱。所以时序库都内置动态批策略:时间窗口 + 数据条数双阈值,满足任一条件就触发落盘。
不同产品在批量写入的实现上各有取舍:Prometheus 偏向小批量、高频刷盘,适配监控短周期采集;IoTDB 依托设备树分组,按设备分组打包批量写入;TDengine 按超级表 + 时间分片做批量隔离。而基于 LSM-Tree 架构的时序库,内存 MemTable 就是批量写入的载体,数据先写入内存有序缓冲区,再批量转成 SSTable 顺序落盘。
三、顺序读取:时序区间查询的底层优化逻辑
时序业务最典型查询:“某个设备,近 1 小时温度测点”,本质是 时间区间扫描查询。时序库在写入阶段已经把数据按时间有序、连续块落地,查询的时候,不需要到处跳索引找零散数据,直接根据时间范围定位到对应的磁盘块,做连续顺序读取。
顺序读取的优化逻辑拆解:
- 时间作为一级索引:按时间分片,查询先过滤时间范围,跳过完全不匹配的磁盘块(时间分区裁剪);
- 块内有序:单个 SSTable/数据块内部时间单调递增,扫描不需要回溯;
- 列式组织:同测点的值连续存放,读取一个测点时,只加载这一列,减少 IO 放大;
- 预过滤:块内附带统计信息(最大时间、最小时间、测点集合),快速跳过无关数据文件。
这里很容易踩一个认知误区: 顺序读取强依赖写入带来的有序性。如果乱序数据太多、大量历史数据改写,会打散磁盘上连续有序的数据块,区间查询就会从“顺序扫描”退化成大量随机读取,查询延迟直接抬升。
这也是上期压缩内容里提到的同一个矛盾点:动态时序(补传、校准)会破坏有序性。很多开源时序库原生面向监控静态追加场景,对乱序容忍窗口很小,一旦大量补传,读写性能双双下滑。不少时序引擎会设计独立的乱序缓冲区、更新标记,用来隔离乱序数据,保护主数据块的有序性,兼顾动态场景和顺序读取的收益。
四、时序聚合:把计算靠近存储,区别于查询后再聚合
传统数据库的聚合范式:先把符合条件的全量数据读到内存,再在计算层做 SUM、AVG、MAX/MIN。海量时序场景下,拉取全部原始数据传输、计算,带宽和算力开销巨大。
时序专属聚合范式核心思想: 下推聚合,计算下沉到存储层。在磁盘块、分片内部预先做局部聚合,再把少量聚合结果汇总返回,而不是返回全部原始测点。分为三类聚合设计:
- 实时流式聚合:写入时,在内存缓冲区实时维护窗口聚合值(滚动均值、最大值);
- 预聚合(降采样):原始细粒度数据写入后,后台异步生成粗粒度聚合结果(1s 原始 → 1min 均值、5min 最大值);
- 查询时聚合下推:查询命中数据块,直接在块内完成聚合,只返回聚合结果。
举个例子:查询过去 24 小时温度均值。传统模式:读取几十万条原始数据 → 网络传输 → 应用计算均值;时序聚合范式:分片内部各自算出本地均值、计数,汇总少量结果算出全局均值,大幅减少数据读取量。
五、整套范式联动:批量写入 - 顺序读取 - 时序聚合,三位一体
时序读写范式不是三个独立功能,而是一套闭环:
- 批量写入:内存攒批、排序、顺序落盘,产出时间有序的数据块;
- 顺序读取:查询依托有序块做时间裁剪、连续扫描,降低 IO;
- 时序聚合:依托有序块做块内聚合下推、预降采样,减少返回数据量。
这套范式也是 LSM-Tree 路线时序库的核心优势。像 Prometheus、IoTDB 都基于这套范式搭建,在静态追加场景表现优秀;但在车联网、能源这类经常有弱网补传、历史校准的动态时序场景,如何平衡维持有序性和支持乱序更新,就是内核设计的难点。
KaiwuDB 在这套标准时序读写范式基础上,延续 LSM-Tree 的批量写入、有序 SSTable 顺序扫描能力,同时通过独立的乱序窗口、更新标记机制,把乱序数据和主有序数据做隔离。正常有序数据流依然走标准批量写入、顺序读取、块内聚合的高效链路;补传、修正这类动态数据单独处理,不会大面积打散已有有序块,保证绝大多数区间查询依然可以享受顺序 IO 和聚合下推的收益。同时它的聚合算子和冷热分层打通,冷数据自动加载预降采样结果,跨天、跨月的大范围统计查询不用扫描海量原始细粒度数据。
六、范式的边界:时序读写范式不是万 能的
这套读写范式有明确适用边界,理解边界,选型才不会踩坑:
✅ 适合:高频流式追加、按时间区间查询、趋势统计、降采样聚合(工业、车联网、电力监控)
❌ 不擅长:无时间条件的随机单点查询、频繁跨字段随机更新、海量多表复杂关联事务
如果业务核心是高频随机修改、复杂事务,时序范式的优势发挥不出来,关系型数据库反而更合适。很多新手选型踩坑,就是忽略范式差异:拿时序库去做高频随机单点更新,或者拿 MySQL 扛百万测点流式写入,本质是用错了读写模型。
七、总结
- 时序数据库读写范式,和传统 B+ 树随机读写范式底层假设完全不同,时序优先面向流式追加、区间扫描;
- 批量写入核心是分摊磁盘 IO 寻道开销,在内存维持有序,为压缩、顺序读取打好基础;
- 顺序读取依托时间有序的数据块,依靠时间裁剪、块过滤,规避随机 IO,是时序查询高性能的来源;
- 时序聚合主打计算下沉、预降采样,区别于传统数据库“全量拉取再计算”;
- 三者形成闭环:批量写入产出有序数据,有序数据支撑顺序扫描,有序块又支撑高效的聚合下推;
- 范式本身是行业通用设计,不同产品的差异,在于如何在这套范式之上兼容乱序补传、历史更新这类动态时序需求。
往期推荐
来自 “ ITPUB博客 ” ,链接:https://blog.itpub.net/70049832/viewspace-3187212/ ,如需转载,请注明出处,否则将追究法律责任。

最新文章
- 【TSDB 科普】时序数据压缩技术:差分压缩、增量压缩、浮点压缩核心机制解析
- 【TSDB科普】时序数据库分片:时间分片、维度分片、哈希分片的底层设计逻辑
- 【TSDB科普】为什么时序数据库更偏爱LSM-Tree?
- 【TSDB科普】时序数据到底怎么分类?更新、维度、粒度三个角度讲清楚
- 【TSDB科普】为什么时序数据需要专门的数据库?从底层模型看懂 TSDB
- 【TSDB科普】时序数据库核心术语合集:时间戳、测点、维度、指标、时间粒度等
- 【TSDB科普】一文搞懂时序数据库TSDB
- TSBS 实测:KaiwuDB VS TimescaleDB 性能对比,原生时序与 PG 时序化差距有多大
- TSBS 实测:KaiwuDB vs InfluxDB,时序数据库性能差多少?
- 聊聊 KaiwuDB 的开源压测工具:kwdb-tsbs 上手分享
