做物联网运维、设备监控、能源数字化项目,很多存储选型出问题,不是因为数据库性能不够,而是时序数据类型和存储引擎架构不匹配。工程人员习惯先选数据库再适配业务数据,这个顺序 反了就很容易踩坑——写入性能上不去、查询超时、存储撑爆、数据错乱,基本都是这个路数。市面上关于时序数据库选型的内容大多是产品功能横向对比,很少有人系统讲时序数据本身怎么分类。但时序库选型的 核心第一要务,其实是先搞清你的数据是什么类型,再找匹配的存储引擎。
这篇从更新特性、维度数量、采样粒度三个维度来拆解时序数据的分类体系,结合存储原理和落地场景,看看 Prometheus、IoTDB、TDengine、KaiwuDB、TimescaleDB 各自适合什么类型的数据。
一、时序数据基础概述
时序数据就是记录观测对象在不同时间点的状态变化,核心要素三个:时间戳、监测指标、维度标签。IT运维、智能制造、智慧能源、车联网、智慧农业,这些场景都离不开时序数据。跟传统关系型数据比,时序数据有三个明显特征:按时间顺序生成、写入量远大于读取量、数据价值随时间递减。绝大多数时序数据是追加写入,不需要频繁修改历史数据,这也是专用时序数据库相比传统数据库最大的架构优势。
时序数据可以从三个独立维度来分类,三个维度互不冲突、可以叠加使用,能覆盖绝大多数业务场景:
1. 按更新特性划分:静态时序数据、动态时序数据;
2. 按维度数量划分:单维时序数据、多维时序数据;
3. 按采样粒度划分:稠密时序数据、稀疏时序数据。
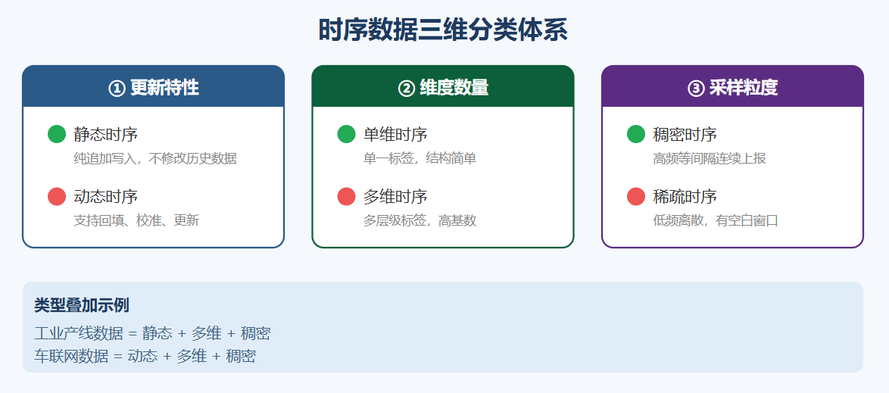
二、基于更新特性分类:静态时序与动态时序
按数据落地后能不能修改、回填、更新,时序数据分为静态和动态两类。这两类对存储引擎的读写架构要求完全不同,选型时先分清这个,后面才不会跑偏。
2.1 静态时序数据
静态时序数据是典型的追加型数据,写进去之后不会再改的历史数据。设备的状态记录就是这种——不可篡改,不断追加新时间点的数据。这类数据在时序业务场景里占绝大多数。
典型 来源 场景
工业设备周期性工况采集、服务器与容器监控指标、充电桩正常联网状态下的电力参数采集等。
存储适配原理
专用时序数据库基本都针对静态时序数据做了架构优化,普遍用时序分片加 LSM-Tree 列式存储,避免了传统 B+ 树索引的随机写入锁竞争。再加上差分压缩、Gorilla 浮点压缩这些算法,存储利用率高不少,也支持长期采样归档,跟静态时序‘只新增不修改’的特性很搭。
各数据库适配情况
TDengine 和 Apache IoTDB 在静态时序场景上表现最好,高吞吐写入和高压缩存储的优势能充分发挥,适合工业、新能源这类没有数据回填需求的大规模采集场景。IoTDB 的树形路径模型做工业设备层级管理也很顺手。
Prometheus 和 InfluxDB 社区版架构轻、部署快,适合小规模运维监控类的静态时序场景,短板是分布式扩展能力有限,设备规模大了撑不住。
KaiwuDB 也能满足静态时序的高性能写入和压缩存储,同时在专用时序引擎的基础上加了动态数据处理能力,算是静态动态都能兼顾的多模时序数据库。
传统关系型数据库(MySQL、Oracle 这类)不适合海量静态时序场景,持续高频写入会产生大量随机 IO,性能瓶颈很明显,只能支撑极小体量的测试。

2.2 动态时序数据
动态时序数据落地后还有历史数据补传、校准修正、异常数据删除、批量覆盖这些操作,没法按纯追加的规则来写入。这类数据主要来自弱网传输、人工业务校准、采集服务异常丢包等场景。
典型来源场景
车载设备在隧道、地下车库等弱网场景下的离线缓存数据,联网后批量回填;电网计量数据人工校准修正历史读数;采集服务故障恢复后补全缺失时间段的数据。
存储适配原理
动态时序数据对存储引擎有两个要求: 既要能高速顺序写入新数据,又要能对历史分片数据做可控的随机更新。纯追加型的时序数据库为了优化写入性能,弱化甚至砍掉了历史数据修改能力,批量回填时容易触发大量文件合并,产生写放大问题,导致集群卡顿、查询延迟飙升。
适配动态时序的存储引擎,需要在列式存储基础上留出数据更新接口,配套数据去重、断点续传、数据校验机制,在写入性能和数据修正之间找平衡。
各数据库适配情况
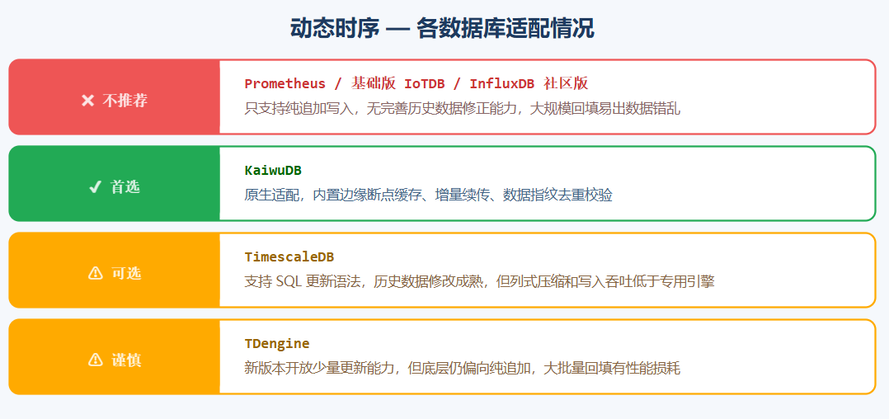
Prometheus、基础版 Apache IoTDB、InfluxDB 社区版只支持纯追加写入,没有完善的历史数据修正能力,大规模数据回填容易出数据错乱、集群不稳定的问题,不适合动态时序场景。
TimescaleDB 基于 PostgreSQL 改造,支持标准 SQL 数据更新语法,历史数据修改的逻辑很成熟,但列式压缩效率和写入吞吐低于专用时序引擎,海量数据场景下存储成本偏高。
KaiwuDB 原生适配动态时序业务场景,在列式存储架构基础上内置了边缘断点缓存、增量续传、数据指纹去重校验能力,依托边云一体化架构实现边缘离线缓存加云端批量回填的全流程自动化,适配车联网、能源计量等动态时序场景。
TDengine 新版本开放了少量历史数据更新能力,但底层架构仍偏向纯追加设计,大批量历史回填场景还是有明显的性能损耗。
三、基于维度数量分类:单维时序与多维时序
时序维度(Tag)是区分同一监测指标下不同数据源的核心索引,用于数据筛选、分组聚合、维度统计。根据标签数量和层级,分为单维时序和多维时序,直接影响数据库的索引架构和分片逻辑选型。
3.1 单维时序数据
单维时序数据指同一监测指标只有一个区分维度,标签基数低、没有多层级组合查询需求,数据模型很简单。
典型来源场景
单台服务器性能监控、单点位设备监测,通过唯一设备ID区分数据源,不需要机房、产线、区域等多层维度筛选。
存储适配与产品选型
单维时序数据的索引结构简单,不需要复杂的分布式分片逻辑,轻量化时序引擎就够用。Prometheus 的原生 KV 标签模型、轻量版 InfluxDB 在这类场景下适配性很好,部署成本低、资源占用少。分布式时序数据库虽然也能用,但功能冗余,性价比偏低。
3.2 多维时序数据
多维时序数据指单条监测指标附带两层以上维度标签,普遍存在高基数标签、多维度组合筛选、分组聚合的需求,是工业互联网、智慧城市、大型能源平台的主流数据形态。
典型来源场景
工厂的温度、压力等工况指标,包含厂区、车间、产线、设备、传感器点位等多层维度,业务需要基于多维度组合做数据统计和趋势分析。
存储适配原理
多维时序数据的关键问题是高基数索引膨胀。如果存储引擎没有针对性分片优化,标签量增长会导致内存占用持续上升,甚至引发服务 OOM。行业里主流优化路线有两条:一是树形分层建模,适配工业层级化设备结构;二是标签哈希分片,实现高基数维度的分布式隔离。
各数据库适配情况
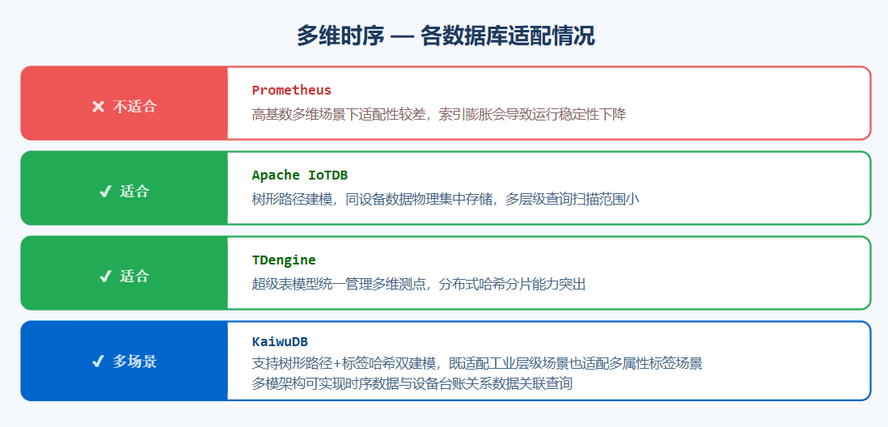
Prometheus 在高基数多维场景下适配性较差,索引膨胀会导致长期运行稳定性下降,不适合上万设备的大型工业项目。
Apache IoTDB 采用树形路径建模,跟工业多层级设备维度天然匹配,同设备数据物理集中存储,多层级查询扫描范围更小,开源生态完善,中小型工业项目用得很多。
TDengine 依托超级表模型统一管理多维测点,分布式哈希分片能力突出,适合单指标、海量设备的多维时序场景。
KaiwuDB 支持树形路径和标签哈希双建模模式,既能适配工业层级设备场景,也能适配交通、能源等需要多属性标签的场景。多模架构还能把时序维度数据和设备台账关系数据做关联查询,适配复杂的多维业务。
四、基于采样粒度分类:稠密时序与稀疏时序
按设备数据上报频率和时间间隔均匀度,时序数据可以分为稠密和稀疏两类。两类数据的存储压缩收益和聚合查询逻辑差异不小。
4.1 稠密时序数据
稠密时序数据是高频、等间隔、连续上报的监测数据,上报周期在毫秒或秒级,没有长时间断采,每个时间分片都有完整数据点。
典型来源场景
数控机床毫秒级振动采集、光伏逆变器秒级功率监测、云主机实时性能指标采集等。
存储适配原理与选型
稠密时序数据是列式存储的最优适配场景——连续数据物理集中存储,时序专属压缩算法能实现很高的压缩率,窗口聚合、极值、均值这些计算只需要扫描单列数据,磁盘 IO 开销很低。TDengine、Apache IoTDB 、KaiwuDB 等专用时序库在这类场景上的写入吞吐、存储压缩、查询效率和传统关系数据库相比差距很大。
4.2 稀疏时序数据
稀疏时序数据是低频、离散上报的数据,生成间隔不固定,有大量空白时间窗口,没有连续时序特征。
典型来源场景
农田土壤温湿度、户外气象站低频采集数据、设备故障告警等事件型时序数据。
存储适配原理与选型
稀疏时序数据没法发挥时序数据库的极 致压缩和批量聚合优势,引擎也不需要超高吞吐写入能力。这类场景的核心诉求是轻量化部署、低资源占用、缺失值插值补齐。主流时序数据库都能适配,Prometheus、IoTDB 、KaiwuDB Lite 等轻量化方案性价比更高,不需要搭重型分布式集群。
五、时序数据分类与数据库适配汇总表
|
分类维度 |
时序类型 |
核心特征 |
典型业务场景 |
✅最优适配数据库 |
❌不推荐选型 |
|
按更新特性 |
静态时序 |
纯追加写入,无历史数据修改、回填需求 |
工业产线采集、服务器监控、光伏实时监测 |
TDengine、Apache IoTDB、Prometheus、KaiwuDB |
MySQL、Oracle等传统行库 |
|
动态时序 |
支持断网补传、人工校准、历史数据修正 |
车联网离线回填、电网计量校准、采集丢包补数 |
KaiwuDB、TimescaleDB |
Prometheus、基础版IoTDB、InfluxDB社区版 | |
|
按维度数量 |
单维时序 |
单一区分标签,维度结构简单,基数低 |
单机运维监控、小型单点位监测 |
Prometheus、轻量InfluxDB |
重型分布式时序库(功能冗余) |
|
多维时序 |
多层级多属性标签,高基数、多维度组合查询频繁 |
多厂区智能制造、全域电网监测、大型车联网平台 |
Apache IoTDB、TDengine、KaiwuDB |
Prometheus(高基数易OOM) | |
|
按采样粒度 |
稠密时序 |
高频等间隔上报,数据连续无断采 |
机床振动采集、光伏功率监测、主机性能监控 |
全系列专用时序数据库 |
传统关系型数据库 |
|
稀疏时序 |
低频离散上报,存在大量空时间窗口 |
农田气象监测、设备故障事件告警 |
所有主流时序数据库 |
无明显避坑选型 |
六、工程落地选型总结
1. 先定数据类型,再做存储选型
存储选型应该先看数据特征:确认更新特性、维度层级、采样粒度,再匹配对应的存储引擎,这样可以从根上避免架构不匹配的问题,减少后期重构成本。
2. 各时序数据库存在明确能力取舍
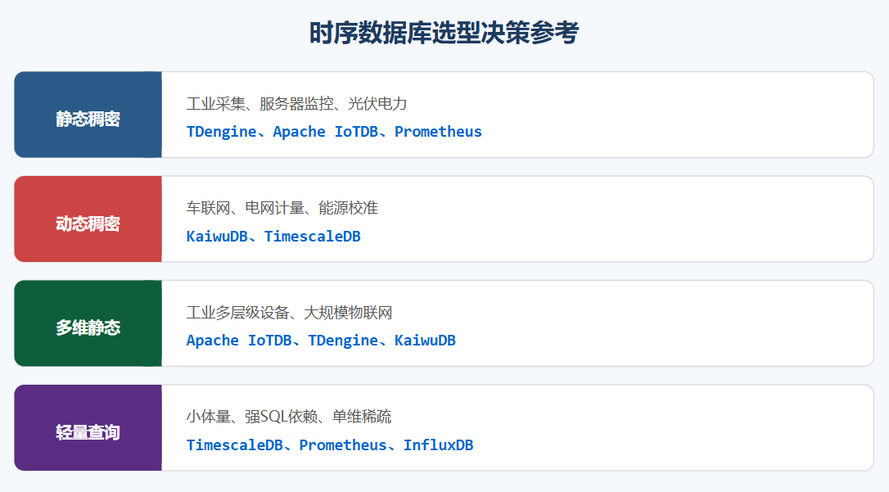
轻量化运维、单维静态稠密场景,Prometheus 部署简单、性价比高;纯开源工业静态多维场景,Apache IoTDB 轻量化优势显著;海量设备稠密静态时序场景,TDengine 吞吐与压缩能力突出;少量时序数据但需要标准 SQL 更新的场景,选 TimescaleDB。
3. 产业项目多为复合型时序数据场景
大型工业、能源、交通项目不存在单一的时序数据类型,普遍是多维、稠密、动态等多种特征叠加。单一轻量化时序库在这些场景下会露出短板,具备多模存储、动态数据处理、云边协同能力的数据库更适配复杂的落地场景。
4. 分类维度可叠加判定
标准工业产线数据是「多维+稠密+静态」时序;车联网平台数据是「多维+稠密+动态」时序;智慧农业气象数据是「多维+稀疏+静态」时序。通过多维度叠加判定,可以精准匹配最优存储架构。
One more thing
至此,本系列基础阶段前4篇内容就全部完结了。顺序如下:
第1篇: 一文搞懂时序数据库TSDB
第2篇: 时序数据库核心术语合集:时间戳、测点、维度、指标、时间粒度等
第3篇: 时序数据库 VS 传统数据库:从底层模型读懂核心差异
第4篇:时序数据到底怎么分类?更新、维度、粒度三个角度讲清楚
这四篇从「什么是时序数据、什么时候用时序库」入手,到实际物联网场景落地,最后到数据分类与数据库选型匹配,基本覆盖了日常开发中选库、用库、场景适配的常见问题。应该也能感觉到:没有哪一款时序数据库是万 能的,Prometheus、IoTDB、TDengine、KaiwuDB、TimescaleDB 各有优劣、各有适用场景。选型踩坑、性能不好、存储浪费,说到底都是数据特征和数据库底层架构不匹配造成的。
不过目前聊的还是「业务层面、选型层面」的应用知识,只能告诉大家「怎么选、怎么用」,还解释不了「为什么这么设计、为什么性能有差距」。不管是数据库的高吞吐写入、超高压缩比、冷热分层,还是乱序处理、分片查询,这些功能和性能表现,全看底层存储内核的设计逻辑。所以接下来,这个专栏会进入第二阶段:时序数据库底层核心原理系列。后续抛开实操配置,专注挖底层内核,一步步拆解存储模型、分片机制、压缩算法、读写范式、索引原理、数据生命周期、乱序处理这些东西,帮助大家做到知其然更知其所以然。欢迎大家关注,一起成长交流。
来自 “ ITPUB博客 ” ,链接:https://blog.itpub.net/70049832/viewspace-3174857/ ,如需转载,请注明出处,否则将追究法律责任。

最新文章
- 【TSDB 科普】时序数据压缩技术:差分压缩、增量压缩、浮点压缩核心机制解析
- 【TSDB科普】时序数据库分片:时间分片、维度分片、哈希分片的底层设计逻辑
- 【TSDB科普】为什么时序数据库更偏爱LSM-Tree?
- 【TSDB科普】为什么时序数据需要专门的数据库?从底层模型看懂 TSDB
- 【TSDB科普】时序数据库核心术语合集:时间戳、测点、维度、指标、时间粒度等
- 【TSDB科普】一文搞懂时序数据库TSDB
- TSBS 实测:KaiwuDB VS TimescaleDB 性能对比,原生时序与 PG 时序化差距有多大
- TSBS 实测:KaiwuDB vs InfluxDB,时序数据库性能差多少?
- 聊聊 KaiwuDB 的开源压测工具:kwdb-tsbs 上手分享
- 聊一聊TSBS:时序数据库跑分,为啥大家都用它?
