深耕工业物联网、车联网、智慧能源等时序数据场景的落地实践后,我发现一个普遍且容易被忽视的核心问题:多数时序项目踩坑、返工、验收出问题,往往不是卡在架构设计、性能调优、设备高并发接入等硬核技术难题,而是源于 团队内部时序术语不统一、基础数据认知不一致。
在日常项目协作中,研发、算法、产品、交付以及对接甲方的不同角色,对测点、指标、维度、时间粒度这些基础概念,常常存在各自的理解偏差。不少人混淆物理采集点位与业务指标的定义、分不清标签与维度的使用边界、对采集频率和聚合粒度的统计口径模糊。这种看似微小的认知差异,会引发一连串连锁问题:数据建模逻辑混乱、多维度统计口径冲突、前后端报表数据对不齐、设备告警规则矛盾,甚至导致前期建模大规模返工、后期数据分析失真、跨系统数据对接失败,直接影响项目落地效果与验收进度。
时序数据库(TSDB)和关系数据库(RDB)最大的区别,是拥有一套 完全独立、自成体系、行业通用的标准术语与数据模型。如果基础概念混淆,后续做数据分层、边云协同、冷热存储、聚合分析都会根基不稳。
本篇是【TSDB科普】系列的基础入门篇章,我会带大家系统梳理时序数据库的核心常用术语,帮大家理清行业里各种容易混淆的概念。用通俗的讲法拆解时序数据核心的「三元组」底层逻辑,统一时间戳、测点、指标、维度、时间粒度这些高频概念的含义和用法。全文内容都贴合行业通用标准和实际落地经验,不夸大、不杜撰,不管是做时序数据开发、运维,还是做方案设计,都能直接拿来参考、统一团队认知。
一、时序数据底层根基:标准三元组理论模型
所有时序数据库,无论开源IoTDB、InfluxDB,还是商业化KaiwuDB、TDengine,底层数据结构都遵循行业统一的 时序数据三元组模型,这是所有术语、建模、查询、聚合的底层根基,也是区别于MySQL、PostgreSQL等关系库的核心特征。
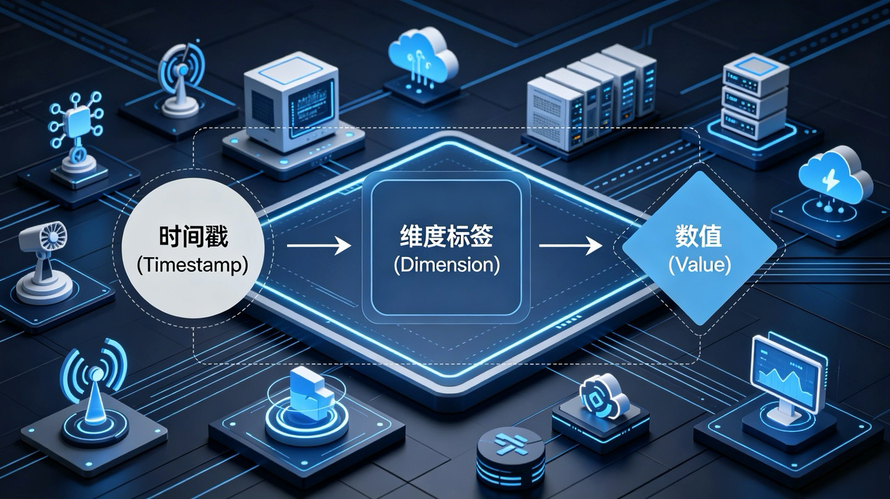
标准三元组公式:时间戳(Time) + 维度标签(Dimension) + 数值(Value)
通俗拆解:任何一条时序数据,本质都是 在什么时间、哪个对象、产生了什么数值。
-
时间戳:定义数据的「时间位置」,解决“何时产生”的问题
-
维度标签:定义数据的「归属对象」,解决“谁产生、在哪产生”的问题
-
数值:定义数据的「具体物理量」,解决“产生了多少、是什么状态”的问题
我们日常说的测点、指标、粒度,全部都是基于这套三元组模型衍生出来的业务与技术概念。理解三元组,就彻底打通了时序数据的底层逻辑。
二、核心术语标准化拆解:理清行业常见认知混淆点
时序行业术语混乱的核心原因,是很多人混淆了 物理硬件概念和 软件数据概念。为了方便大家直观理解整套时序数据底层逻辑,我简单整理了一张概念示意图。图中完整展示了时序三元组核心结构,同时标注了测点、维度、时间戳、时间线等关键要素的对应关系,帮助大家快速理清各类概念之间的从属联系。

1. 时间戳(Timestamp):时序数据的唯一时间锚点
时间戳是时序数据的核心主键,是标识数据采集、上报、生成时刻的精准时间标识,也是时序数据库能够快速分区、裁剪、回溯、聚合的核心依据。行业内严格区分两类时间概念,这是绝大多数项目出错的关键点。
-
绝对时间(标准落地唯一口径):指具体的UTC时间、北京时间时间戳(毫秒/微秒级),例如 1719283200000。所有工业、车载、能源、交管项目, 必须统一使用绝对时间,保证跨设备、跨区域、跨云端的数据时间对齐,是合规统计、故障溯源、轨迹回放的基础。
-
相对时间(纯业务查询口径):指“近1小时、近7天、昨日全天”这类模糊时间语义,仅用于前端查询、报表筛选, 绝对不能落地存储。相对时间每次查询都会动态换算为绝对时间,不存在持久化能力。
落地常识:时序数据库所有分区、索引、排序,全部基于绝对时间戳构建,相对时间仅为上层业务封装,不参与底层存储建模。
2. 测点(Point/Series):物理世界的真实采集点位
测点是 偏硬件、偏物理的概念,对应现场真实存在的采集终端、传感器、监测点位,是数据的来源载体。
-
物理测点:真实部署在设备上的采集点位,例如光伏逆变器电压测点、车载车速测点、车间设备温度测点、农业土壤湿度测点。物理测点固定绑定硬件位置,硬件不更换,测点位置不变。
-
逻辑测点:基于物理测点二次计算、聚合生成的虚拟点位,例如小时平均车速、日平均能耗、设备波动方差。逻辑测点无硬件对应,是软件计算衍生数据。
核心区分:测点回答的是「 数据从哪个采集点来」,是时序数据的基础载体,一条时间线对应一个唯一测点。
3. 指标(Metric):业务可统计的量化数值
指标是 偏软件、偏业务的概念,是对测点采集数据的业务定义与量化归类,也是报表、统计、分析、告警的核心对象。很多人会把测点和指标混为一谈,行业标准区分方式非常清晰:
同一个 物理测点,可以衍生多个 业务指标。比如车载车速测点(物理点位固定),可以衍生瞬时车速、最大车速、平均车速、超速时长多个业务指标。简单总结: 测点是数据源,指标是数据应用。测点偏向硬件采集,指标偏向业务统计。
4. 维度/标签(Dimension/Tag):时序数据的分类主键
维度(行业日常统称标签)是时序数据区别于普通日志数据的核心能力,是附着在时序数值上的 静态元数据,用于数据筛选、分组、聚合、关联。
常见标准维度包含:设备ID、设备型号、区域、车间、车辆VIN码、传感器类型、部署位置等。维度数据具备 更新频率低、长期稳定、唯一标识对象的特征。没有维度的时序数据毫无业务价值。比如同样是温度25℃,通过维度可以区分是“一号车间设备温度”还是“二号车间设备温度”,实现多设备、多点位数据的精准拆分与独立统计。
5. 时间粒度(Interval/Granularity):时序数据的聚合精度
时间粒度是时序数据分析、报表统计的核心标准,定义数据的时间聚合精度,行业统一分为固定粒度与动态粒度两类,适配不同业务场景。
-
固定时间粒度:行业最常用、可标准化落地的粒度,例如1秒、10秒、1分钟、5分钟、1小时、1天。适配绝大多数物联网、能源、车载场景,数据规整、统计口径统一,适合长期报表、趋势分析、合规存证。
-
动态时间粒度:无固定间隔,根据数据变化、事件触发自适应调整,例如设备状态变化瞬间上报、故障毫秒级触发上报、车速突变即时采样。适配故障告警、事件溯源、异常研判等高精度场景,不适合常规报表统计。
落地常识:原始采集粒度决定数据精度,聚合粒度决定业务效率。高频原始粒度保证溯源精准,粗聚合粒度保证查询高效、存储低成本。
三、高频易混概念辨析:规避项目落地常见误区
结合工业、车载、能源真实落地场景,我把项目中最容易踩坑的几组概念做标准化对比,帮大家进一步理清边界。
1. 测点 VS 指标
测点是物理采集入口,是数据的源头,一一对应硬件传感器;指标是业务量化结果,由测点原始数据计算衍生而来。 一个测点对应多个指标,一个指标归属唯一测点来源。建模时先定义测点,再衍生指标,顺序不可颠倒。
2. 绝对时间 VS 相对时间
存储层只认绝对时间,保证数据唯一、不重复、可对齐;业务层只用相对时间,降低查询门槛。所有数据错乱、报表对不齐、重复统计问题,基本都是混淆两类时间导致。
3. 采集频率 VS 聚合粒度
采集频率是边缘端硬件上报频率(原始数据精度),聚合粒度是云端/边缘预处理后的统计精度。例如1秒采集一次原始数据,1分钟聚合一次报表数据,就是典型的「高频采集、低频统计」最优架构。
四、行业标准建模规范:基于术语体系的落地范式
基于以上全套标准术语,行业通用的时序数据建模范式相对来说比较清晰了,也是目前包括IoTDB、KaiwuDB等在内的主流时序数据库统一适配的底层建模逻辑:
-
唯一时间线 = 测点 + 全量维度标签组合
-
业务数据 = 唯一时间线 + 多粒度时序指标
-
数据治理 = 原始高频采集 + 分层粒度聚合 + 维度分组统计
这套范式适配工业物联网、车联网、智慧能源、城市交管全场景,无论采用哪种时序数据库,底层建模逻辑通用。但在遵循统一行业范式的基础上,不同产品的建模实现各有细微差异化设计:
Apache IoTDB 主打树形层级建模,高度适配工业设备分层架构,适合层级复杂的设备集群场景;TDengine 采用极简设备-测点扁平建模,结构轻量化、写入吞吐极 致,适配大规模高频采集设备场景;KaiwuDB 支持时序+关系多模融合建模,可在时序模型中关联设备台账、静态档案数据,更适配复杂混合数据治理的规模化场景。
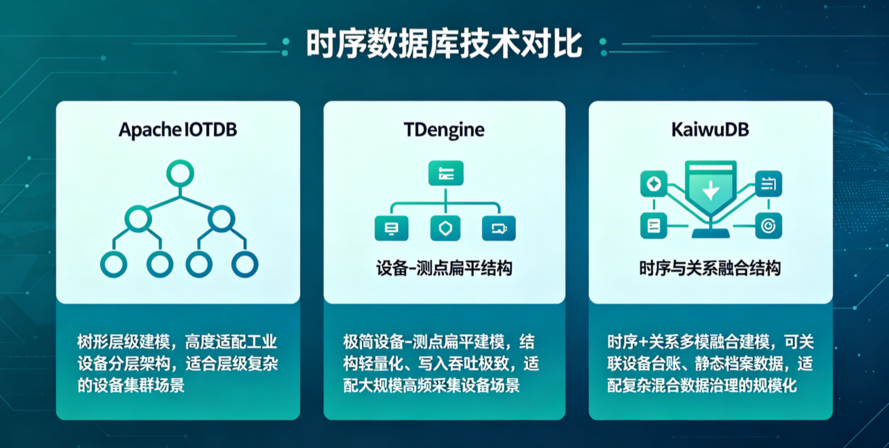
总结来说,时序数据库的核心门槛,不在于复杂架构,而在于 标准化的术语体系与严谨的数据建模逻辑。三元组模型是底层根基,时间戳保证时序唯一性,维度标签保证数据可区分,测点指标体系保证业务可落地,时间粒度保证数据效率与精度平衡。厘清这套基础体系,后续做时序建模、边云协同、数据预处理、冷热分层、报表聚合、故障溯源,都能做到逻辑统一、口径标准、少走弯路。
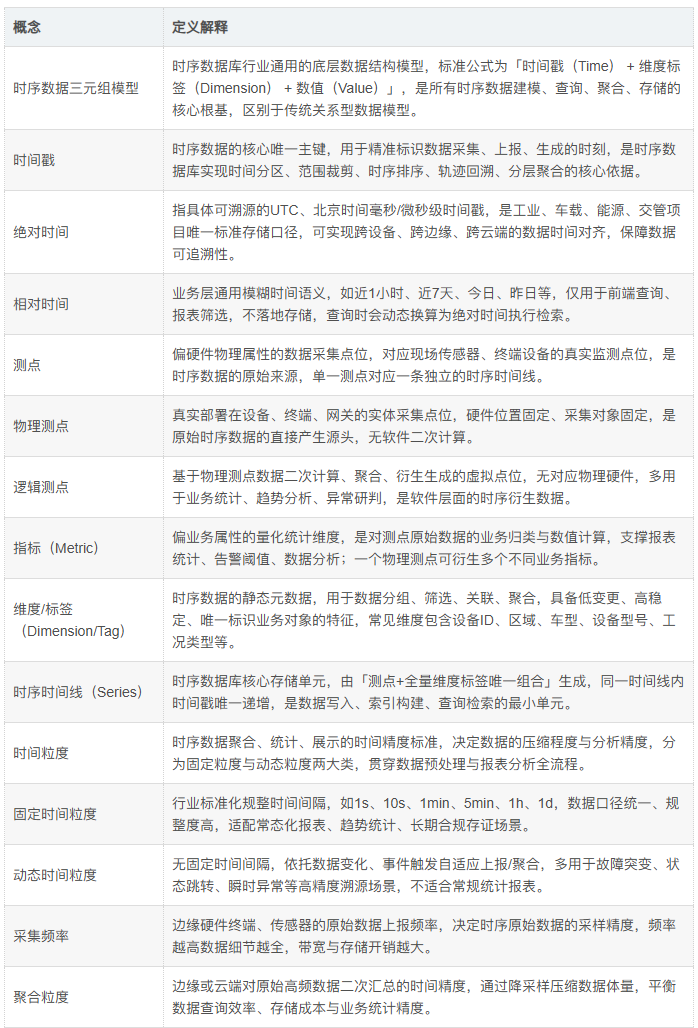
五、相关核心术语汇总表
为方便大家快速查阅、统一术语口径,本文核心时序相关概念汇总如下:

下期预告:下一篇将聚焦时序数据库建模实战,拆解工业、车载、能源三大场景的标准建模方案,对比宽表建模、窄表建模、层级建模的优劣与选型要点,分享可直接落地的建模规范。
来自 “ ITPUB博客 ” ,链接:https://blog.itpub.net/70049832/viewspace-3174274/ ,如需转载,请注明出处,否则将追究法律责任。

最新文章
- 【TSDB 科普】时序数据压缩技术:差分压缩、增量压缩、浮点压缩核心机制解析
- 【TSDB科普】时序数据库分片:时间分片、维度分片、哈希分片的底层设计逻辑
- 【TSDB科普】为什么时序数据库更偏爱LSM-Tree?
- 【TSDB科普】时序数据到底怎么分类?更新、维度、粒度三个角度讲清楚
- 【TSDB科普】为什么时序数据需要专门的数据库?从底层模型看懂 TSDB
- 【TSDB科普】一文搞懂时序数据库TSDB
- TSBS 实测:KaiwuDB VS TimescaleDB 性能对比,原生时序与 PG 时序化差距有多大
- TSBS 实测:KaiwuDB vs InfluxDB,时序数据库性能差多少?
- 聊聊 KaiwuDB 的开源压测工具:kwdb-tsbs 上手分享
- 聊一聊TSBS:时序数据库跑分,为啥大家都用它?
