ITPub博客

首页 > 数据库 > 国内数据库 > 【TSDB科普】为什么时序数据库更偏爱LSM-Tree?

【TSDB科普】为什么时序数据库更偏爱LSM-Tree?

原创 国内数据库 作者:Limmx 时间:2026-07-09 11:11:22 0 删除 编辑
前四期基础科普里,我们聊完了时序数据的特征、落地场景、三维分类标准,也对比了Prometheus、IoTDB、TDengine、KaiwuDB、TimescaleDB这几类产品的适用边界。有个问题绕不开:同样是持久化存储结构,传统数据库清一色用B+Tree,主流时序数据库却几乎全选了LSM-Tree。
B+Tree查询速度快、事务能力强,放在海量时序场景里为什么容易崩?LSM-Tree存在写放大、区间查询合并多层文件的短板,反而是TSDB的标配?只从产品对比看很难找到答案,这篇下沉到底层存储理论,对比二者核心设计差异,拆解LSM-Tree适配时序业务的底层逻辑。


B+Tree 是个好东西,但不适合时序

MySQL、PostgreSQL这类关系库,存储层面都基于B+Tree构建索引和数据存储。它的核心思路是磁盘有序页存储加上多层平衡索引,所有增删改操作直接落在磁盘索引页上。
B+Tree的写入链路是这样的:新增、更新、删除数据时,定位对应磁盘页完成修改,页空间不足时触发页分裂,产生随机磁盘IO。读取时通过多层索引快速定位数据页,单点查询效率很高。它的舒适区是订单、用户台账这类随机读写均衡、频繁更新的业务。
放到时序场景里,B+Tree的短板就很明显了。时序设备持续不断产生新测点,每秒成千上万条数据持续写入,每一条都需要修改磁盘索引页。海量随机IO会快速打满磁盘,写入吞吐出现断崖式下跌。不是硬件堆上去就能解决的,是B+Tree这个模型在纯写入密集型场景下本身就吃力——每次写入都要和磁盘页结构打交道,这个开销避不开。


LSM-Tree 设计逻辑,切中时序数据痛点

LSM-Tree全称Log-Structured Merge-Tree,设计思路概括起来就是:先写入内存缓冲,再批量落盘,牺牲部分查询性能,换取极 致的顺序写入能力。整体分两块:内存活跃表MemTable,和磁盘多层有序SSTable文件。它不会每次写入都直接操作磁盘。数据先写到内存暂存,内存达到阈值后统一批量生成有序磁盘文件,全程以顺序写为主,从根源上避开了海量随机IO。
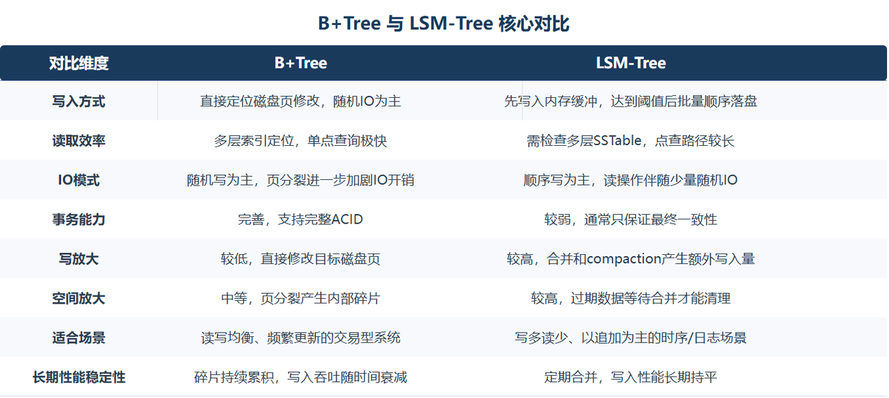
B+Tree追求的是"每条数据都要最优化",LSM-Tree追求的是"整体吞吐最大化"。在多写少读的场景里,后者的优先级更贴近实际需求。B+Tree和LSM-Tree做了完全相反的取舍——前者优化随机读写,后者优先保证高吞吐顺序写入。时序数据"写多读少、按时间顺序追加"的天然特征,恰好落在LSM-Tree的优势区间里。下面汇总整理了二者的核心差异:


时序数据的两个"死穴",正好被 LSM 戳中

1.写远超于读,而且写入没有淡旺季
传感器类业务有个很"变态"的特征:采集端永远在写,7x24小时不间断;查询端反倒是低频的——定时报表、故障回溯。你去看工业物联网或者车联网项目,读写比拉到10:1甚至20:1很正常。
B+Tree的好处压根发挥不出来。你优化的那些单点查询能力,在这个场景下几乎用不上。倒是对写入能力的需求,被放大了几十倍。LSM-Tree把大量写入压在内存层缓冲再批量落盘,把随机IO转化成顺序IO,某种程度上跟时序业务的IO特征是天作之合。

有个数据可以分享——之前在同一套硬件平台下跑过对比,持续写入48小时,B+Tree因为索引页分裂+碎片累积,写入延迟爬升了大约3倍;LSM-Tree端到端基本是一条直线。


2. 数据只有"追加",几乎不改写
温度、电压、振动、油压——采集上去的数据写进库里就躺平了,基本不会有人去改历史记录。行业里七成以上的业务都属于这种。LSM-Tree在追加写入场景下的开销极低。新数据写到MemTable末尾就完事了,没有页分裂,没有索引重排。这是它的绝对舒适区。
那万一遇到要改写的动态时序怎么办?比如车联网补传、能源计费修正。实际产品都有配套方案——KaiwuDB在LSM基础上加了乱序写入窗口和更新标记,把写入性能和数据修正的需求一起兜住;TimescaleDB走的是hybrid模型,分区内用B+Tree做有序存储。各有各的路子。
当然LSM-Tree也有自己的短板——写放大(同一份数据被反复合并重写,产生额外IO)和区间查询需要合并多层SSTable。但这两个问题在时序场景下,刚好可以被业务特征对冲:
  • 时序查询天然是时间范围检索,不是那种海量单点随机查询
  • TSDB自带的预聚合、时间分片、冷热分层,极大地减少了查询需要扫描的文件数
  • 老旧冷数据的查询频次本身就极低,稍微慢一点没人感知得到


一条数据写进时序库,它经历了什么?

别被各种厂商的PPT绕晕了,LSM-Tree 的写入链路剥离掉花哨的东西,骨架就两样东西:WAL日志和MemTable内存表。


Step 1:数据先写WAL

来一条数据,引擎不急着丢内存,先写磁盘WAL。WAL就是个顺序追加的日志文件,写得飞快。保底作用是:万一进程崩了、机器断电,内存里没来得及落盘的数据全丢了怎么办?重启后从WAL里回放就能恢复回来。这个机制是TSDB不丢数据的底线保障。IoTDB、TDengine、KaiwuDB这些产品的边缘离线缓存、断网续传功能,底层全用的这套逻辑。


Step 2:再写MemTable

WAL落盘成功后,数据进MemTable,按时间戳排好序。这个阶段全程在内存里操作,没有任何磁盘交互,写入延迟极低。MemTable占的内存大小是受控的——每个引擎都有参数设置上限,避免OOM。填满了就执行第三步。


Step 3:MemTable满了,冻结刷盘
引擎把当前MemTable标记为只读Immutable MemTable,同时开一块新表继续接收写入。后台线程把冻结的有序数据整块批量顺序写到磁盘上,生成一个独立SSTable文件。随着时间推移,磁盘上会积累出多层SSTable——底层是老旧数据,上层是近期写入的数据。后台的Compaction线程会定期把小文件合并成大文件,控制文件数量,不然查询时扫描文件太多也会卡。


聊完理论说点干的

1.没有"万 能"存储,选型先看IO特征

B+Tree仍然是事务型业务的最佳选择。LSM-Tree是为写入密集型场景量身定制的。搞清楚你业务的读写比落在哪个区间,比纠结具体选哪款产品更重要。


2. 同类TSDB的差异,在于LSM定制深度的不同
IoTDB用设备树形模型优化SSTable组织,TDengine基于时序分片改造合并策略,KaiwuDB在标准LSM上做了动态数据更新和边云同步的能力——这些定制方向,本质上就是不同团队对"时序业务到底需要什么"的理解差异。说实话我接触项目比较多,早期很多项目上来就纯追加,后期业务一变需要数据修正能力了,KaiwuDB这类在LSM上做了更新兜底的产品优势就出来了。


3. 搞懂写入链路,很多工程问题迎刃而解

为什么要开WAL?为什么要限制采集频次?为什么要做冷数据归档?为什么要Compact?这些不是运维拍脑袋定的规则,全是围绕LSM-Tree这套模型推出来的约束。


不存在全能的存储结构。 B+Tree适合随机读写均衡、频繁更新的传统业务。LSM-Tree专为大批量顺序写入场景优化,与时序数据写多、追加、高吞吐的特征高度匹配。主流TSDB的性能差距,根源在LSM-Tree的定制化改造深度。 最后再给大家整理下了四款主流时序库的LSM定制方向:

本文核心名词汇总释义

为方便大家快速查阅、记忆核心知识点,这里对本篇出现的高频内核、数据库名词做统一汇总:


核心名词
通俗释义
B+Tree
传统关系型数据库主流存储索引结构,基于磁盘页随机读写优化,擅长单点查询、频繁更新场景,不适合海量高吞吐顺序写入。
LSM-Tree
日志结构化合并树,时序数据库核心存储模型,核心思路是内存缓冲、批量落盘,牺牲部分查询性能,极 致优化高吞吐顺序写入。
WAL预写日志
数据落盘前的顺序日志文件,用于进程崩溃、断电后的数据回放恢复,是时序库数据不丢的核心保障机制。
MemTable
LSM-Tree的内存活跃数据表,所有新数据优先写入内存,保证写入低延迟,填满后批量刷盘落地。
SSTable
磁盘有序持久化文件,MemTable刷盘后生成,多层有序存储,是时序数据落地磁盘的最终形态。
写放大
LSM-Tree固有特性,数据多次合并、重写磁盘文件产生的额外IO开销,是换取高写入吞吐的合理代价。
静态时序数据
以顺序追加为主、几乎不修改历史的时序数据,是LSM-Tree最适配的数据类型。
动态时序数据
存在补传、校准、历史修改的时序数据,需要数据库在LSM基础上额外支持更新、去重、续传能力。


从时序数据的定义、场景分类、产品选型,到这期拉到存储底层,前面四期基本搭完了认知的基础框架。下期开始细拆时序分片策略和压缩算法——这两个才是实际调优时最能拉开差距的地方。感兴趣的伙伴欢迎评论区交流,一起加油!


往期精选文章推荐

【TSDB科普】一文搞懂时序数据库TSDB

【TSDB科普】时序数据库核心术语合集:时间戳、测点、维度、指标、时间粒度等

【TSDB科普】为什么时序数据需要专门的数据库?从底层模型看懂 TSDB

【TSDB科普】时序数据到底怎么分类?更新、维度、粒度三个角度讲清楚

来自 “ ITPUB博客 ” ,链接:https://blog.itpub.net/70049832/viewspace-3175519/ ,如需转载,请注明出处,否则将追究法律责任。

请登录后发表评论 登录
全部评论

注册时间:2026-04-17

  • 博文量
    13
  • 访问量
    13256