前一期我们聊完了LSM\-Tree为什么能成为时序数据库的标配存储结构。但存储模型解决的是单节点上数据怎么落盘的问题,一旦数据量上来、节点数变多,就绕不开另一个核心问题: 数据怎么拆到不同机器上去?这就是分片(Sharding)要干的事。时序数据库的分片策略看起来选择不少,但归根结底就三种思路:按时间分、按维度分、按哈希分。每种思路的底层逻辑不同,适用的场景也不同。选错了,轻则查询变慢,重则扩缩容直接翻车。这篇从底层设计逻辑出发,把这三种分片策略理理清楚。
一、为什么分片对于时序数据库那么重要
工业物联网、车联网、能源监测这些场景,数据写入是持续不断的。一台设备一天可能产生几万条时序点,十万台设备就是几十亿条。单机存储和写入能力总有天花板,CPU、内存、磁盘IO、网络带宽,哪个先扛不住都不好说。分片的目的就是把 写入压力、存储容量、查询负载分散到多个节点上。但时序数据有个很特殊的属性:它自带时间戳,而且写入顺序基本和时间正相关。这个特征让时序分片和电商订单、社交网络这类数据的分片思路很不一样。
传统数据库分片,核心目标是让数据均匀分布,避免热点。时序数据库分片,除了均匀,还要考虑 时间局部性和 查询模式。因为时序查询十有八九是查某段时间内某个设备的数据,如果分片策略和查询模式对不上,查询时就要跨很多节点拉数据,网络开销会拖死整个集群。所以时序分片不是怎么把数据拆开这么简单,对时序数据库而言,分片策略直接决定了:
- 写入吞吐能否线性扩展
- 范围查询是否需要跨分片聚合
- 冷热数据分离是否自然
- 扩容时数据迁移的成本
- 监控指标(Metrics):CPU、内存、网络流量等
- IoT 传感器数据:温度、湿度、位置上报
- 日志类数据:应用日志、审计日志
接下来我将分别介绍下比较主流的三种分片方式:时间分片、维度分片和哈希分片。

二、时间分片(Time-based Sharding)
核心原理
按时间范围划分分片边界 。比如按天、按小时、按固定时间窗口(如 7 天)把数据切分到不同的分片。这是最常见的做法,时序数据天然自带时间主键。底层实现一般是在时间戳上做一个简单的范围判断:shard_id = floor((timestamp - epoch) / shard_duration)
适用数据模型
这些模型的共同点是: 查询模式高度时间局部化。运维查监控,通常只看最近 1 小时或某一天的曲线。

- 写入:理论上是顺序写,磁盘 I/O 友好。但如果分片粒度太粗,单分片写入并发会成为瓶颈。
- 读取:时间范围查询性能最优,因为可以精确路由到目标分片。但跨分片查询需要额外的 Merge 操作,延迟呈亚线性增长。
- 聚合:单分片内聚合(如单天的平均值)很快;跨分片聚合需要二次计算,网络传输和内存消耗是分片数量的函数。
- 多租户 SaaS 平台:不同租户的数据物理隔离
- 多设备 IoT 场景:按设备 ID 分片,单个设备的历史数据集中存储
- 多地域部署:按 region 分片,实现数据就近存储
对读写和查询聚合可能产生的影响
当前主流产品对比:
- InfluxDB 的 Shard Group 是典型的时间分片,默认按 7 天一个窗口,实现简单,但粒度固定,高峰期容易单分片膨胀。
- TimescaleDB 的 Hypertable Chunk 也是按时间范围切分,Chunk 大小可配置,但需要 DBA 根据业务特征手动调参。
- KaiwuDB 在这块做了自适应动态分片,系统会根据写入吞吐自动调整时间窗口大小。这个思路的好处是低峰期不会分片过细浪费元数据资源,高峰期又能自动拆分避免单点瓶颈。不过动态调整是否会增加元数据管理的复杂度,以及分片合并/拆分过程中的查询一致性如何保证,还需要在真实场景下验证。
三、维度分片(Tag-based / Dimension Sharding)
核心原理
按业务维度(Tag/Label)划分分片 。例如按device_id
、
region
、
tenant_id
等维度,把同一维度的数据路由到同一个分片。底层通常是基于维度值的范围或前缀来做分片映射:
shard_id = hash(tag_value) % num_shards // 或者按 tag 范围划分
适用数据模型

- 写入:如果维度选择得当(如按设备 ID 哈希),写入可以均匀分散。但如果维度本身有热点(如某个超大盘口),写入会严重倾斜。
- 读取:带维度过滤的查询性能极佳;纯时间范围查询退化成全分片扫描,性能最差。
- 聚合:同维度内的聚合(如某租户的总消耗)是本地聚合;跨维度聚合(如全平台总消耗)需要全局 Shuffle,网络开销大。
- 通用时序场景:没有明显的时间或维度查询偏好
- 超高并发写入:需要把写入压力均匀打散到所有节点
-
对查询模式不确定的系统:无法预判用户主要按时间还是按维度查询
对读写和查询聚合的理论影响
当前主流产品对比:
- TDengine 的超级表(STable)+ 子表设计,本质上是一种维度分片的变体——按设备维度把数据拆到不同的子表(vnode)中。这种设计在设备查询场景下性能很好,但代价是纯时间范围查询必须带设备过滤,否则就是全 vnode 扫描。
- IoTDB 在最新版本里引入了时间分区 + 设备分区的混合策略,试图缓解纯维度分片的问题。
- KaiwuDB 的做法是时间分片为主、标签维度为辅的二级分片:先按时间窗口切分,再在时间窗口内按 Series(标签组合)做路由。这种混合思路相当于在时间查询和维度查询之间取了一个平衡,但实现复杂度也更高,二级路由的元数据开销需要关注。
四、哈希分片(Hash Sharding)
核心原理
对数据的某个键(通常是复合主键或时间戳\+标签的组合)做哈希,取模映射到分片 。shard_id = hash(timestamp, tag1, tag2, ...) % num_shards
哈希函数通常选择一致性哈希(Consistent Hashing),以最小化扩容时的数据迁移量。
适用数据模型
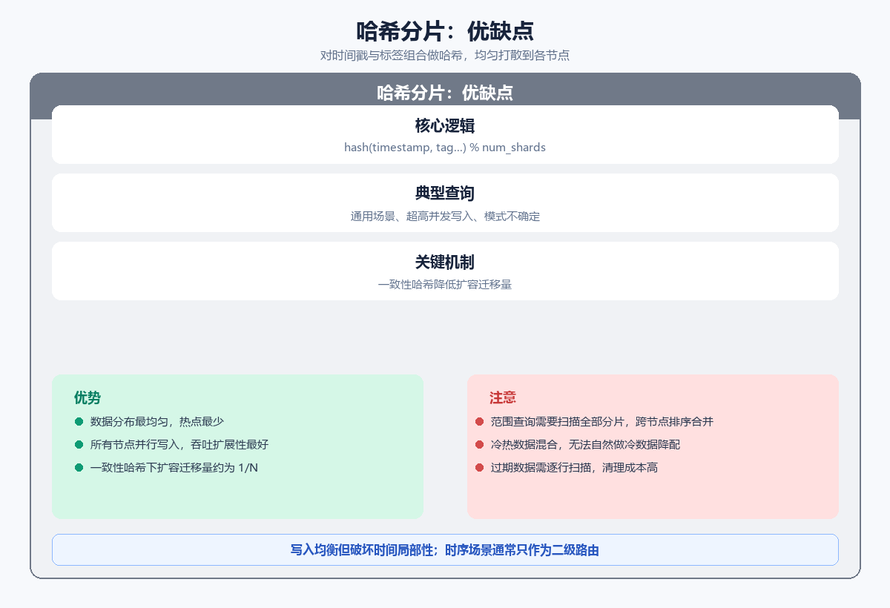
- 写入:理论最优,所有分片并行承接写入,吞吐随节点数线性扩展。
- 读取:点查(精确匹配某条记录)性能好;范围查询性能最差,因为需要跨分片扫描\+排序合并。
- 聚合:任何聚合查询都需要全局 Shuffle,即使是很小的时间窗口也无法利用局部性优化。
- 识别自己的数据模型和查询模式
- 预判不同策略在扩展性上的瓶颈点
- 在分片粒度和边界上做精细化调参
对读写和查询聚合的理论影响
当前主流产品对比:
- Cassandra 和 HBase 在时序场景下常采用哈希分片,因为它们的底层存储引擎(LSM\-Tree)对顺序写友好,但对时序查询的局部性没有特殊优化。
- VictoriaMetrics 虽然主要按时间分片,但在集群模式下对 Series 做了哈希路由,属于一种折中方案。
- 纯哈希分片在时序数据库中其实越来越少见,因为时序数据的查询模式高度时间局部化,哈希的均匀恰恰破坏了这种局部性。目前主流产品要么完全放弃纯哈希(如 InfluxDB、TimescaleDB),要么只在二级路由中使用(如 KaiwuDB 在 Series 层面的哈希路由)。
五、分片粒度与分片边界
聊完三种策略,再深入两个容易被忽视但对性能影响极大的参数。
1. 分片粒度(Shard Granularity)
分片粒度指的是 单个分片覆盖的数据量或时间跨度。
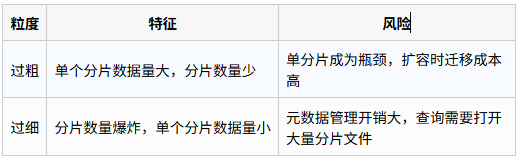
理论上的最优粒度 :让单个分片的大小稳定在单机内存能缓存其索引的量级。时序数据库中,这个值通常在几百 MB 到几 GB 之间。太小的分片会导致查询时文件句柄和索引的内存开销失控。
产品实现对比:
- InfluxDB 的 Shard Group 默认 7 天,对于高频写入场景(如每秒百万点)这个粒度偏粗,单分片很容易膨胀到几十 GB,查询时索引无法完全缓存进内存。
- TimescaleDB 的 Chunk 可以配置得更细(比如 1 天),但配置太细又会导致元数据膨胀,需要 DBA 在粗和细之间手动权衡。
- KaiwuDB 的自适应分片机制也是为了解决这个问题:系统持续监控每个分片的写入速率和存储大小,当检测到单分片压力接近阈值时自动拆分,低峰期又自动合并。这种自调优机制降低了运维门槛,但动态调整带来的分片生命周期管理复杂度,也是一把双刃剑。
2. 分片边界(Shard Boundary)
分片边界决定了 相邻分片之间的分界规则。以时间分片为例,边界可以按固定时间窗口(如每天 00:00),也可以按滑动窗口(如每 1000 万条记录)。固定边界的问题在于 时间边界处的写入热点——所有系统在 00:00 同时切到新分片,旧分片的写入瞬间归零,新分片瞬间承压。有一种优化思路是 预创建分片 \+ 写入缓冲:在边界到来前提前创建好新分片,并让写入层在边界处做短暂缓冲,平滑过渡。
当前主流产品对比:
- 大部分时序数据库(包括 InfluxDB、OpenTSDB)在分片边界处都没有做特殊处理,切分瞬间容易出现写入抖动。
- TDengine 在 vnode 层面做了预分配,但时间分片的边界问题依然存在。
- KaiwuDB 的做法是在时间窗口结束前提前创建下一个分片,并在边界处维护一个双写缓冲期(通常几秒到几十秒),让写入流量平滑迁移。这个细节对生产环境的稳定性有一定帮助,但缓冲期内的数据一致性保障机制(如双写去重)会增加写入路径的复杂度。
---
六、总结
三种策略不是互斥的,很多生产系统会采用 混合分片:先按时间做一级分片,再在时间分片内部按维度或哈希做二级分片。这里我整理了几家主流数据库厂商的分片策略。

七、写在最后
分片策略是时序数据库架构设计的根,它影响了存储格式、查询优化器、扩容机制、甚至冷热分级方案。理解三种分片策略的底层逻辑,不是为了背概念,而是为了在选型时能够:
如果你的系统还在用随便哈希一下的方式分片,而业务查询 90% 都是时间范围查询——那大概率还有很大的优化空间。
这篇写得比较干,主要是理清楚自己的思路。如果大家对某个具体策略想深入聊,或者对 KaiwuDB 的自适应分片机制、 TDengine 的 vnode 设计、 TimescaleDB 的 Chunk 调优感兴趣,可以留言,我后面可以挑几个方向单独展开测一波。
---
本文核心名词汇总释义

往期精选文章推荐
【TSDB科普】一文搞懂时序数据库TSDB【TSDB科普】时序数据库核心术语合集:时间戳、测点、维度、指标、时间粒度等
【TSDB科普】为什么时序数据需要专门的数据库?从底层模型看懂 TSDB
【TSDB科普】时序数据到底怎么分类?更新、维度、粒度三个角度讲清楚
【TSDB科普】为什么主流时序数据库都用 LSM\-Tree?底层存储逻辑拆解
来自 “ ITPUB博客 ” ,链接:https://blog.itpub.net/70049832/viewspace-3181137/ ,如需转载,请注明出处,否则将追究法律责任。

最新文章
- 【TSDB 科普】时序数据压缩技术:差分压缩、增量压缩、浮点压缩核心机制解析
- 【TSDB科普】为什么时序数据库更偏爱LSM-Tree?
- 【TSDB科普】时序数据到底怎么分类?更新、维度、粒度三个角度讲清楚
- 【TSDB科普】为什么时序数据需要专门的数据库?从底层模型看懂 TSDB
- 【TSDB科普】时序数据库核心术语合集:时间戳、测点、维度、指标、时间粒度等
- 【TSDB科普】一文搞懂时序数据库TSDB
- TSBS 实测:KaiwuDB VS TimescaleDB 性能对比,原生时序与 PG 时序化差距有多大
- TSBS 实测:KaiwuDB vs InfluxDB,时序数据库性能差多少?
- 聊聊 KaiwuDB 的开源压测工具:kwdb-tsbs 上手分享
- 聊一聊TSBS:时序数据库跑分,为啥大家都用它?
