



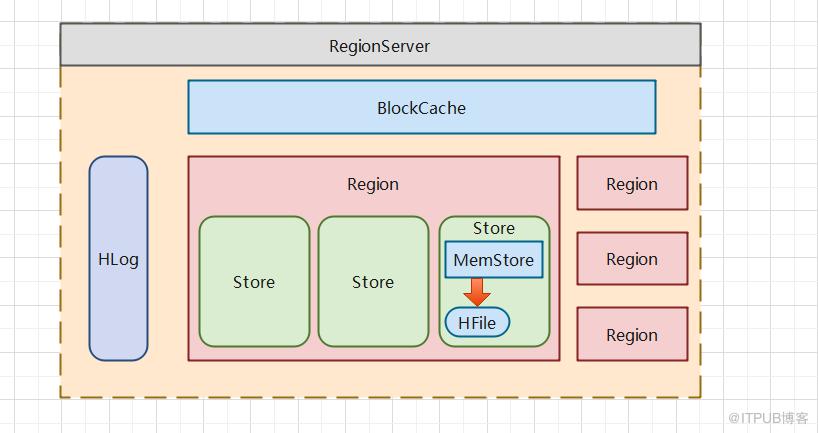
RegionServer是HBase中最核心的组件,主要负责数据写入,读取等基础操作,一个RegionServer由一到多个HLog,一个BlockCache和多个Region组成,然后一个Region里面又含有多个Store,每个Store存放对应列簇的数据,然后,每个Store里面又包含一个MemStore和多个HFile,在进行数据写入时会将对应列簇数据写入相应的MemStore,当写入的数据内存超过系统设置阈值,救火落盘形成HFile文件,HFile存放在HDFS上,是一种定制化格式的数据存储文件,方便进行数据读取。
架构如下:


HLog用途:
1).故障恢复
当进行写入,更新,删除操作时,数据先以追加的形式写入HLog,然后再写入MemStore中,正常情况下,HLog不会被读取,但是如果RegionServer发生宕机,已经写入MemStore但是还没来得及flush到磁盘的数据就会丢失,此时通过回放HLog便可找回丢失的数据。
2).主从复制
如果HBase实现了主从复制,实现主从数据同步时,需要主集群将HLog日志发送给从集群,从集群在本地执行回放操作,便可实现集群之间的数据复制。
HLog文件结构:
HBase默认只有一个HLog,从1.1版本开始支持多个HLog,每个HLog由多个Region共享,在HLog中,为了保证行级事务的原子性,日志单元表示一次行级更新的最小追加单位,即一个行级事物的写入表示为一条记录。
HLog文件存储:
HBase中所有数据存储在HDFS的指定目录,具体可以查看配置文件,其中,/hbase/WALS目录下存储未过期的日志,/hbase/oldWALS存储已经过期的日志,/hbase/WALS下通常包含多个子目录,每个子目录对应一个对应的RegionServer.子目录下存储该RegionServer内的所有HLog文件。可通过hbase hlog命令查看HLog文件内容。
HLog生命周期:
HLog生命周期包含四个阶段 ,创建阶段,此时会将记录写入HLog中,滚动阶段,HBase后台会定时滚动线程来进行日志滚动,便于删除过期日志。HLog失效,HLog中的数据一旦从MemStore中落盘,对应的,日志数据便会失效。日志文件失效后,不会被系统立即删除,而是从WALs文件夹中移动到oldWALs文件夹中。HLog删除,Master后台进程会定期检测oldWALs下的所有失效文件,确认是否满足删除条件,一般如果该HLog文件不再参与主从复制并已经在odlWALS目录下存在10分钟,便可删除。


先简单了解下BlockCache的相关知识点吧。
BlockCache方案:
HBase实现了三种BlockCache方案,LRUBlockCache(默认),SlabCache(0.92版本实现),BucketCache(0.96版本实现),其中LRUBlcokCache是将所有数据放入JVM Heap中,交由JVM进行管理,后两种方案允许将部分数据存储在堆外。
BlockCache的功能:
在HBase中,BlockCache的存在就是为了优化读取性能。如果打开了BlockCache,读取数据时会优先查询BlockCache,如果查询失败,才会去查询MemStore + HFile的数据。
演变缘由:
LRUBlockCache方案中JVM垃圾回收机制经常会导致程序长时间暂停,使用堆外内存对数据进行管理可以有效缓解系统长时间GC,SlabCache是堆外内存管理方案的最初尝试,但是实际应用时发现存在很多弊端,于是又促进了BucketCache方案的诞生。
具体的LRUBlockCache等算法后面再进行专门的学习吧,刚开始学习时太深入会造成难以理解,需要循序渐进。

MemStore的层级:
在HBase中一张表会被切分为多个Region,每个Region独立负责自己区域的数据读写请求。每个Region中有多个Store,HBase将不同列簇的数据存储在不同的Store中,每个Store中含有一个MemStore和多个HFile。
MemStore的结构:
在HBase中,HBase采用了跳跃表的数据结构。使用了JDK自带的数据结构ConcurrentSkipListMap。
跳跃表有以下优点:
1).保证了数据的有效性。
2).可以保证数据写入,查找,删除操作的时间复杂度低于O(logN)。
3).是线程安全性的。
4).底层采用CAS原子性操作,避免了多线程访问造成的锁开销,提升了多线程访问场景下的读写性能。
MemStore由两个ConcurrentSkipListMap实现,简单区分为ConcurrentSkipListMap A,ConcurrentSkipListMap B。A,B之间形成一个循环交替的关系。
MemStore的写入流程:
刚开始时,写入,更新,删除等操作会将数据写入ConcurrentSkipListMap A ,当ConcurrentSkipListMap A中的数据量超过设定的阈值后,会创建一个新的ConcurrentSkipListMap B来接收新的读写请求,此时ConcurrentSkipListMap会执行异步flush操作落盘形成HFile。如此,循环交替。
MemStore的功能:
MemStore本身不是为了加速数据写入,而是为了维持数据结构。因为HDFS文件不支持修改,为了维持HBase的数据按照rowkey顺序存储,使用MemStore先对数据进行整理排序。
MemStore的缺点:
MemStore本质上是一块缓存,且本身会占用大量内存,因此GC问题不可避免。由于MemStore会不断进行数据写入并进行Flush,最终产生越来越多的内存碎片,到最后分配不出足够大的内存给写入的对象,就会触发JVM执行Full GC合并内存,可以通过优化GC算法和开启MSLAB内存管理方式改善Full GC情况。


HFile的由来:
MemStore中的数据落盘后会形成一个文件写入HDFS,即为HFile。
HFile参考了BigTable的SSTable和Hadoop的TFile,共计三个版本,第一个版本中存在占用内存过多问题,第二个版本对该问题进行了优化,第三个版本在第二个版本的基础上增加了对Tag数组的支持。
HFile文件结构:
HFile中包含四个部分:
Scanned Block:顺序扫描HFile时所有的数据块将被读取,该部分包含三种数据块,其中Data Block用于存储KeyValue数据,Leaf Index Block用于存储索引树的叶子节点数据。Bloom Block用于存储布隆过滤器相关数据。
Non-scanned Block:顺序扫描时数据不会被读取,包含Meta Block和Intermediate level Data Index Blocks两部分。
Load-on-open:该部分数据打开HFile时被直接加载到内存中,包含FileInfo,布隆过滤器MetaBlock,Root Data Index和Meta indexBlock。
Trailer:该部分数据主要记录了HFile的版本信息,以及其他部分的偏移值和寻址信息。
感觉这一块很抽象,再细化的话暂时也不太理解,先到这吧。

LRUBlockCache方案中JVM垃圾回收机制经常导致程序长时间暂停,采用堆外内存对数据进行管理可以有效缓解系统长时间GC,JVM对堆内对象的管理很完善,会自动回收对象,但是回收堆内对象的时候JVM和发生停顿,可能会导致业务系统卡住。而堆外内存虽然不如堆内内存好用,但是在回收堆外内存时JVM不会停顿,也就不会影响业务系统。但是如果没有成速度方案,不要轻易尝试使用堆外内存,风险很大。

LSM树,全称Log Structured Merged Tree,并没有严格的树状结构,具有以下优点:
1).能够将一次随机IO写入转换为一次顺序IO写入,加上内存写入,使得写入性能得到极大提升,大部分对写入性能要求高的数据库系统都会采用这种写入模型。
2).实现KeyValue数据根据Key排序,可以在文件级别根据有序的Key建立索引树,极大提升数据读取效率。
3).缓存最近写入的数据,提升读取性能,实际生产中,大部分业务最新写入的数据被读取的概率最大。
4).可以在数据落盘前进行更多优化。

MemStore Chunk POOl是基于MSLAB进行优化的,实现步骤如下:
1).系统创建一个Chunk Pool用来管理所有违背引用的Chunk,以保证Chunk不会被JVM回收。
2).如果一个chunk没有被再引用,则将其放入Chunk Pool。
3).如果当前Chunk Pool已满,则不再接纳新的Chunk。
4).如果需要申请新的Chunk来储存KeyValue,先从Chunk Pool中进行获取,如果获取不到,则申请新的Chunk。
其中单个chunk使用过程如下:
1).每个MemStore会实例化得到一个MemStoreLAB对象。
2).MemStoreLAB会申请一个2M大小的chunk数组,并维护一个Chunk偏移量,其值初始值为0。
3).当KeyValue数据插入MemStore后,MemStoreLAB会通过KeyValue.getBuffer()获得data数组,并将其复制到Chunk数组中,然后将Chunk偏移量向前移动data.length。
4).当前Chunk满了后,再重新申请新的Chunk,这里即先从Chunk Pool中获取。

这两天学习的都是一些HBase组件的内部结构及层次相关的知识点,比较抽象和晦涩,许多知识点可能看了一遍两遍还是不太理解。先记录下来吧,过段时候再拿出来看看,应当又会有一番新的感悟和理解。

END



原文作者:DBA修行之路;如有侵权,请联系管理员删除。

