



在mysql中,为了防止数据误操作后无法恢复,我们一般会定期对数据进行备份,根据备份的方式不同可以分为逻辑备份和物理备份,可用的工具有mysqldump,xtrabackup。而今天复习的内容正是xtrabackup。为了便于后期进行温故和理解,哈哈,怕时间久了之前记录的东西连自己都看不懂,将关键部分进行了划分,分为四个模块,版本划分,备份原理,备份异常场景,备份bug场景,虽然备份异常场景和备份bug场景的最终结果都是失败,但是自己感觉本质上还是不同的,所以单独分开了。

从上图可以看出,特别针对8.0之前和8.0之后进行了一个版本划分,是因为8.0前后,无论是mysql还是xtrabckup都有了较大的变化。另外,图中遇到的异常场景,一些是自己遇到的,还有一些是其他小伙伴或同事遇到的,虽然暂时自己没遇到,万一自己以后也遇到了呢,不是就可以站在前人的肩膀上少踩一些坑了嘛。现在,一起来学习吧。
xtrabackup的版本最早是1.6版本,其间经历2.0版本,2.1版本等等,详细如下图:
从图中可以看出,xtrabackup的版本是比较多的,但是2.3及之前的版本已经不再维护,因此不建议使用,一般生产上推荐的是:
1.如果你的mysql版本是8.0以下的,则建议使用xtrabackup2.4版本。
2.如果你的mysql大版本为8.0但是小版本是8.0.20以下的,则使用xtrabackup8.0.11版本。
3.如果你的mysql版本为8.0.20及以上的,则使用xtrabackup8.0.12版本。

这里有两方面的原因,一方面,由于mysql8.0载数据字典,redo log及undo log中的更改与之前的版本不兼容,因此xtrabackup8.0版本不支持备份mysql8.0之前的版本,Percona Server for MySQL或Percona XtraDB Cluster中创建的数据库。另外,Xtrabackup8.0直到8.0.11版本与MySQL8.0.20及以上版本或基于它的Percona产品不兼容。另外一方面,在可支持的范围内,建议使用较新的版本,因为新的版本会修复一些历史的bug问题,稳定性更好。
Xtrabackup支持Innodb,XtraDB,MyRocks的非阻塞备份,支持MyISAM,Merge,Archive引擎的备份期间暂停写入备份。以下几点需要注意:
1.Xtrabackup2.4仅支持Percona XtraDB Cluster 5.7,不支持MyRocks或TokuDB存储引擎,与MariaDB10.3及更高版本不兼容。。
2.Xtrabackup8.0从8.0.6版本开始支持MyRocks引擎,不支持TokuDB引擎。
3.Xtrabackup2.4流备份格式支持tar,xbstream,Xtrabackup8.0.*只支持xbstream。

这里以社区版为例:
对于8.0之前的版本,以xtrabackup2.4为例,备份流程为:
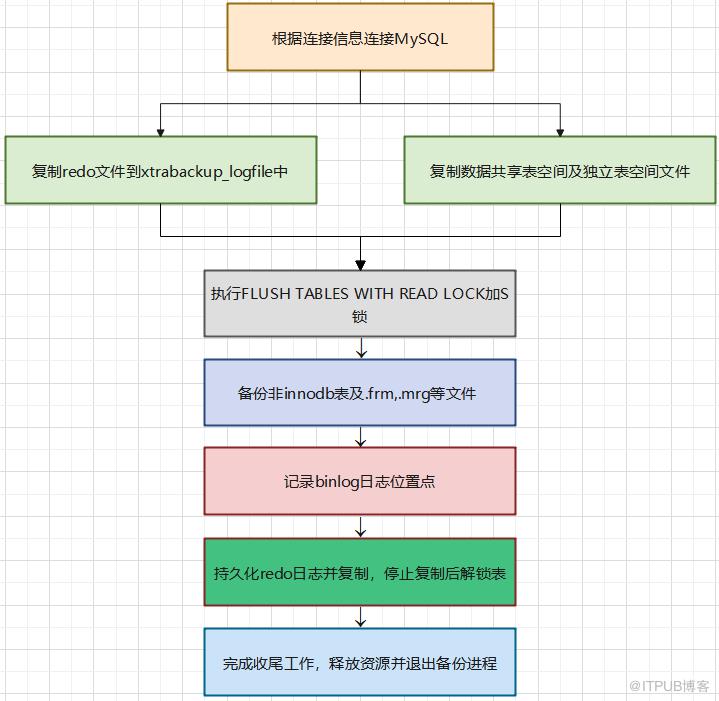
对于8.0及之后的版本,以xtrabackup8.0为例,备份流程为:
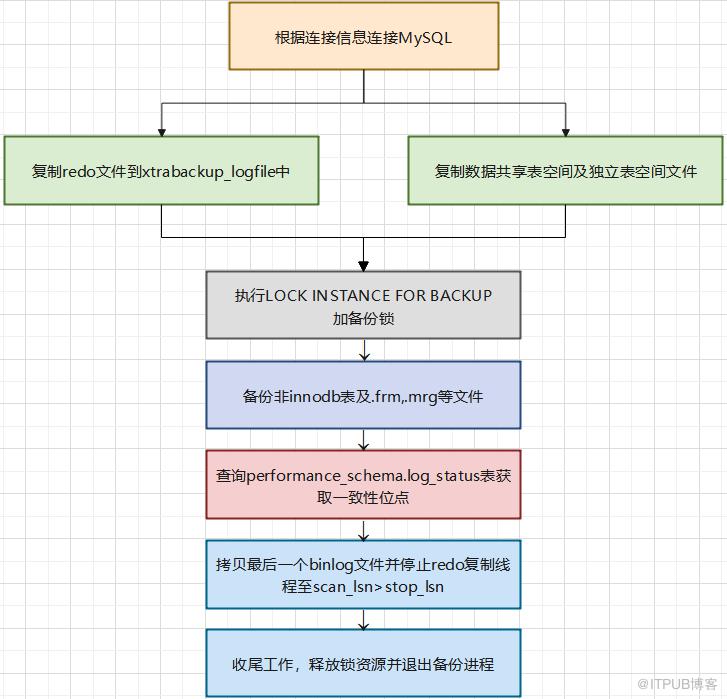
对于恢复流程,简化来说就是:

这里注意的几点是:
1.在mysql8.0中,还有一种情况会在备份时执行ftwrl操作,即备份从库,且从库没有开启gtid。可参考https://www.percona.com/doc/percona-xtrabackup/8.0/how_xtrabackup_works.html。
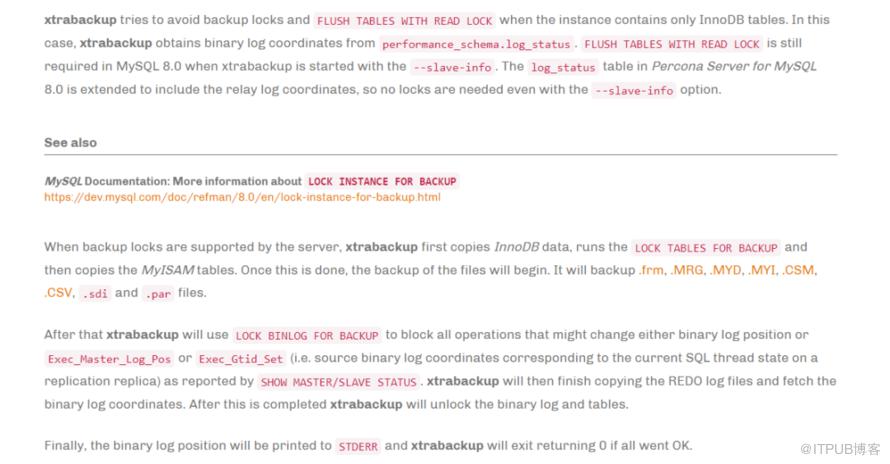
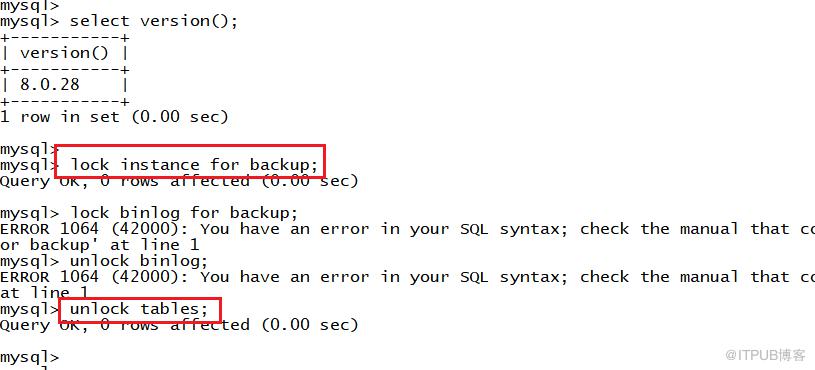
2.官方社区版版本跟percona server的支持命令稍有差别,mysql 8中新增了一个轻量级的备份锁,备份锁由lock instance for backup和unlock instance语法组成。注意,使用这些语句需要BACKUP_ADMIN权限。这在percona server中对应的命令是lock table for backup,除此,percona还支持通过lock binlog for backup和 unlock binlog命令来对binlog进行加锁和解锁,社区版是不支持这个命令的;
3.在备份阶段,xtrabackup是会创建两个线程的,就称为线程一和线程二吧,线程一用来监控事务日志,循环复制redo日志文件中的新增日志,线程二用来复制数据库表相关的文件,当线程二完成所有物理文件复制完成后,通知线程一停止事务日志复制,此时会将相应的一致性位点信息,事务日志等信息存放在xtrabackup_logfile,xtrabackup_checkpoints,xtrabackup_info三个文件中,在恢复时,通过物理文件加备份期间的事务日志及位点信息实现最终一致性。
4.在mysql社区版8.0中,xtrabackup8.0在查询log_status时,mysql服务器会分别对redo log,binlog加轻量级锁以获取一致性备份点,该过程时间非常短,对实例的运行影响可以忽略,xtrabackup可以从一致性备份点中获取到一致性的redo log lsn及binlog日志的gtid位点,然后备份最后一个binlog,用与恢复时判断事务是否需要回滚,并且redo log复制进程会一直复制redo log直到读取到的redo log的lsn大于一致性备份点中的redo log lsn。


xtrabackup备份bug场景暂时梳理了以下5种场景,有2种是自己遇到的,其他是其他小伙伴或同事遇到的,看到了便也记录下来了,是后续如果有新的再进行补充吧。
1.undo truncate操作:
这种场景一般会有如下报错:An undo ddl truncation (could be automatic) operation has been performed.导致该报错的原因是在备份期间实例自己触发或人工执行undo truncate操作导致写新undo文件时undo日志丢失而恢复失败,在xtrabackup中针对mysql8.0.21对该问题进行了不完全的修复,即在备份时解析到undo log的truncate操作时自动备份失败。可以通过在备份时关闭undo tablespace的truncate操作并静止人工创建undo tablespace解决。
2.8.0分区表交换操作:
这个bug也不是太清楚,先记录一下占个坑位吧,以后遇到了再回来补充。
3.版本过低无法识别redo日志:
这种场景一般会有如下报错:Unknown redo log format (4). Please follow the instructions at http://dev.mysql.com/doc/refman/8.0/en/ upgrading-downgrading.html.导致该报错的原因是因为在mysql8.0中,对redo log的日志格式进行了修改,导致在备份时无法识别,这种情况一般替换xtrabackup包为合适的版本重新备份即可。之前遇到过一次xtrabackup版本过低导致备份失败的问题,报错中还有####CORRUPT LOG RECORD FOUND###报错,这种很容易误判为是由于页损坏导致备份失败。更多的,例如,在用xtrabackup8.0.14来备份mysql8.0.22会触发异常BUG,实际上,mysql8.0.24是一个过渡版本,生产上不建议使用。报错信息参考:
stack_bottom = 0 thread_stack 0x46000
xtrabackup8(my_print_stacktrace(unsigned char const*, unsigned long)+0x2e) [0x230b55e]
xtrabackup8(handle_fatal_signal+0x2eb) [0x11b729b]
/lib64/libpthread.so.0(+0xf6d0) [0x7fd7318246d0]
xtrabackup8(dd::get_dd_client(THD*)+0x1) [0x16c8061]
xtrabackup8(dd_table_open_on_name(THD*, MDL_ticket**, char const*, bool, unsigned long, int*)+0x53a) [0x137306a]
xtrabackup8() [0xcc9f5e]
xtrabackup8() [0xccb060]
xtrabackup8(main+0xca9) [0xc8ad19]
/lib64/libc.so.6(__libc_start_main+0xf5) [0x7fd72f697445]
xtrabackup8() [0xcb7bb7]
Please report a bug at https://jira.percona.com/projects/PXB
4.连续ddl操作导致误删ibd文件
这种场景不是很清楚,是之前一个小伙伴遇到过的,我这边也没有实际验证过,解决方法就是在备份期间禁止ddl操作或者备份时添加lock-ddl,lock-ddl-timeout,lock-ddl-per-table等参数。
5.innodb_log_compressed_pages参数问题:
最近遇到这个问题了,现象为备份能够正常结束,但是在recover恢复的时候失败,报错如下:
stack_bottom = 0 thread_stack 0x10000
xtrabackup(my_print_stacktrace+0x2c)[0xcef4ac]
xtrabackup(handle_fatal_signal+0x262)[0xa06812]
/lib64/libpthread.so.0(+0xf5e0)[0x7f4ea976d5e0]
/lib64/libc.so.6(gsignal+0x37)[0x7f4ea73f01f7]
/lib64/libc.so.6(abort+0x148)[0x7f4ea73f18e8]
xtrabackup[0x6f4849]
xtrabackup[0x80fb61]
xtrabackup(_Z22recv_recover_page_funcmP11buf_block_t+0xacc)[0x810cbc]
xtrabackup(_Z20buf_page_io_completeP10buf_page_tb+0x485)[0x8f0225]
xtrabackup(_Z12fil_aio_waitm+0x12f)[0x8b5d0f]
xtrabackup(io_handler_thread+0x28)[0x7e5788]
/lib64/libpthread.so.0(+0x7e25)[0x7f4ea9765e25]
/lib64/libc.so.6(clone+0x6d)[0x7f4ea74b334d]
之前没遇到过这个报错,经大佬指点知道这是一个已知的bug,链接为https://bugs.launchpad.net/percona-xtrabackup/+bug/1736139,解决方法是修改innodb_log_compressed_pages值为on重新备份,有空的时候再细分析下这个bug吧。
无论是社区版8.0之前通过ftwrl阻塞写操作,还是社区版8.0以后通过查询performance.log_status表获取一致性位点,或是percona server通过加binlog锁防止新事务提交,另外,备份完成后redo位点一般是比binlog位点多的,以保证复制的 redo log该提交的都有commit log的信息,多余的redo log在apply过程中奔溃恢复时回滚就行,而这一切都是为了保证恢复时获得一致性数据。
在社区版中,8.0之前使用xtrabackup备份过程中都会有ftwrl加全局读锁的阶段,此时会刷新表,存储引擎会强制关闭表,将表从缓存中排出,所有表的更新操作及ddl都会阻塞。8.0之后新增了轻量级的备份锁,支持备份时innodb表进行dml操作及很多8.0之前不支持的操作,少量的禁止的操作有文件的创建,删除,重命名,账户的管理以及repair table,truncate table,optimize table这些操作。
在mysql5.7之前,mysql创建索引会调用insert apis单条进行b+树的插入,可能会导致大量页分裂与合并操作,还需要查找插入位置,导致开销比较大,5.7后使用Sorted Index方式创建索引的时候会关闭掉Redo Logging,但是这可能会导致备份报错。创建索引详细流程暂时不深究,一点一点学,慢慢来,比较快。xtrabackup引入了--lock-ddl选项来解决这个问题。但是--lock-ddl不是所有mysql分支都支持,例如mariadb,更建议使用通用的--lock-ddl-per-table参数。另外,如果想避免在备份时导致阻塞,可以打开old_alter_table参数。lock-ddl-timeout参数的作用是如果规定时间内无法获取备份锁,则本次备份自动失败。

好几周没更新日记了,最近在看xtrabackup备份这一块的知识点,一方面是感觉对xtrabackup备份流程这一块还有很多困惑,这几天也在向认识的一些大佬在请教。另外一方面,最近自己在新学习mongo数据库的课程。之前对mongo没咋接触,学习起来还是要花些精力的。就一直这么拖着了。哈哈,初学了一遍mongo,感觉mongo跟mysql,redis相比,也有很多亮点,等二刷课程的时候再献上笔记吧,哈哈,偏题了,回到主题吧,本次笔记主要是梳理了下xtrabackup的版本问题,8.0前后备份的原理差异,以及我和认识的一些小伙伴们踩到的一些坑,希望对你有帮助。也不枉费大早上跑起来写昨晚没搞完的笔记了。

END



原文作者:DBA修行之路;如有侵权,请联系管理员删除。

