




前一段时间遇到一个很有趣的case,现场的实例规格是2c16g,现象为实例频繁发生ha切换,ha切换的类型为实例hang住,实际登录实例发现实例没有问题,然后去看了下错误日志,在错误日志中发现了下面的信息: [Note] InnoDB: page_cleaner: 1000ms intended loop took 70389ms. The settings might not be optimal. (flushed=26 and evicted=0, during the time.),根据这个信息可以得知page cleaner 的循环刷脏周期是1s,如果不足1s则sleep,超过1s可能是刷脏太慢,而这里已经超过70s。很明显是不正常的。查看了下现场内存使用率不高,iops值也不高。另外,查看了innodb_log_waits值是大于0的,另外,查看了innodb_buffer_pool_instances的值为1,innodb_buffer_page_cleaners值为1,到此,innodb_lru_scan_depth值为默认值1024,innodb_log_buffer_size值为8388608(8m),结合上面参数结果,初步分析导致实例hang住的原因为innodb_log_buffer_size值较小,同时,刷脏页线程数较少,导致刷脏页较慢,从而导致写redo出现阻塞,继而实例响应慢,出现假死状况,从而触发ha切换机制发生ha切换。为了验证猜想,先调整了innodb_lru_scan_depth参数,从1024调整为256,但是效果不大,还是会有ha情况发生,然后调整了innodb_buffer_page_cleaners和innodb_buffer_pool_instances为4。对innodb_log_buffer_size暂未做调整,后续观察实例运行稳定,便未进行调整了,到此,问题解决。问题虽然解决了,但是这个case感觉还是挺值得思考的,于是有了该篇学习笔记。
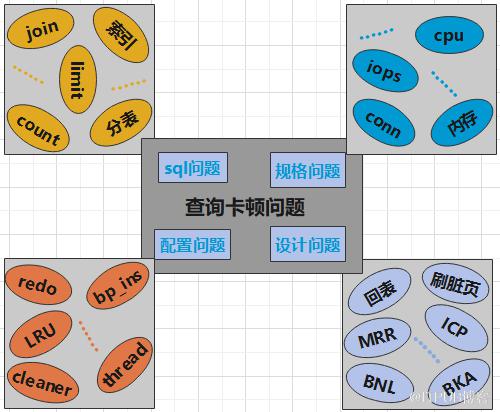
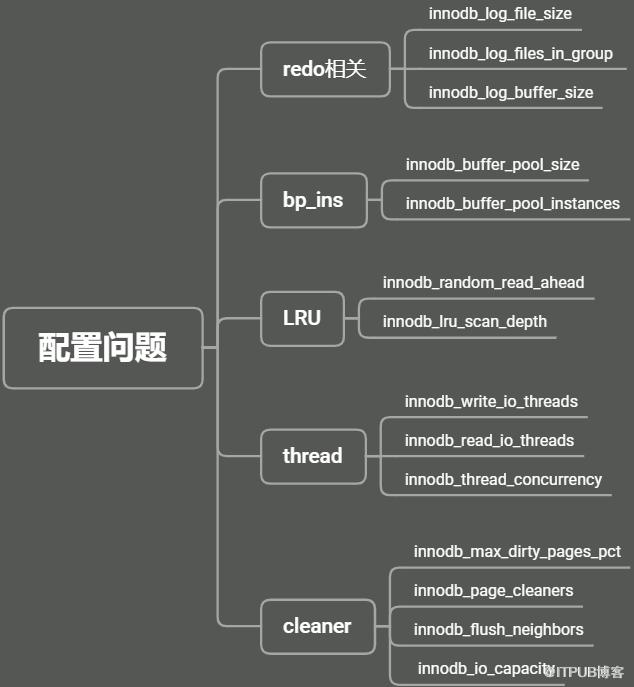
针对ha问题进行扩展问题,归根到底是实例出现卡顿了,但是为什么会出现卡顿呢,出现卡顿时又如何进行解决,如何避免呢,这中间又涉及哪些知识点呢,如上图,我做了一个归纳。
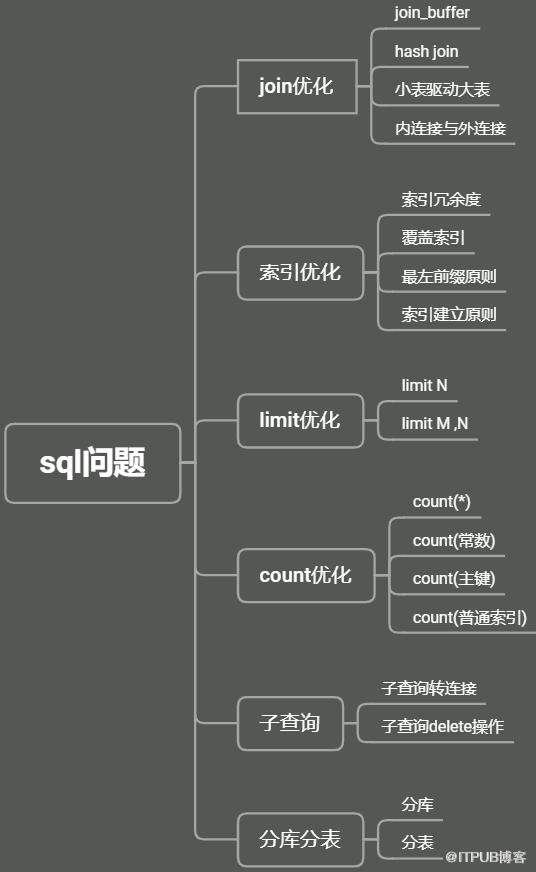
sql问题是一个复杂,庞大的概念体系,我们日常接触并了解的只是冰山一角,但是可以总结出那些常用的知识并转化自己的知识储备,如此未来便可少踩坑。从个人角度,我将sql问题大致分为以下六类:join优化问题,索引优化问题,limit优化问题。count优化问题,子查询问题,分库分表问题,详细如下:
join优化问题:
join在mysql中扮演着不可或缺的角色。当两张表需要连接时,通常便会使用到join,根据连接方式的不同,可以分为内连接和外连接,其中外连接又可细分为左外连接和右外连接。在连接中,分为驱动表(外表)和被驱动表(内表,亦或匹配表),内连接中,驱动表中的记录在被驱动表中找不到匹配的记录则不会计入到最终结果集中,因此驱动表和被驱动表可以互换而不影响最终查询结果。而左外连接和右外连接驱动表中的记录即使在被驱动表中没有匹配的记录,也需要加入到最终结果集,因此驱动表和驱动表交换则会影响查询结果。左外连接选取左侧的表为驱动表,右外连接则会选取右侧的表为驱动表。进行join时,会就驱动表的每一条记录去被驱动表中进行匹配。为了获取更好的性能,建议的原则是小表驱动大表,然后在被驱动表上建立关联字段索引。对于内连接mysql优化器会自动优化。而对于外连接则需要在写sql时自己注意。在8.0.18之前,驱动表不走索引,可能会造成查询扫描数据量大。8.0.18引入了hash 索引,使得驱动表也可以走索引,实现了一个性能的提升。另外,mysql针对join做了一些优化,这个后面进行细说。还有,即使不走索引,也可以通过调整join_buffer大小减少磁盘交互。
索引优化问题:
用一句话来说,成也索引,败也索引。合适的索引能够有效提高查询效率,事半功倍。不恰当的索引不仅不能提高查询性能,还会产生额外的维护成本。一般来说,表的数据量较大时索引效果更好,另外,如果表的数据量频繁变动,维护索引的成本很高,此时是否创建索引便需要进行斟酌了。此外,建立索引的列的数据应该有良好的区分度,同时,如果只需要查询部分列,则覆盖索引是一个很好的选择。如果需要针对多个列建立组合索引,需要考虑最左前缀原则,最后,单表的索引个数不建议太多,建议不超过3-5个。
limit优化问题:
在mysql中,查询关键字查询是按照一定先后顺序规则执行的,同时还会涉及server层和引擎层的交互。而limit关键字是在server层从引擎层获取数据后向客户端发送记录的时候进行处理。对于limit N方式,只需要选择符合条件的前N条即可,而对于limit M,N方式,则需要查询出符合条件的M+N条数据,会增加查询成本。可优化的方法有两种:第一种,先查询需要的N条数据的主键值,然后根据主键值进行回表查询。示例:select * from (select pk_no from test limit M,N) b, test a where a.pk_no= b.pk_no;第二种,通过业务侧优化,记录上次查询的值,然后进行条件查询。例如电影网站使用more获取更多数据。
count优化问题:
count(表达式)的用途是用于统计在满足搜索条件的记录中,指定表达式不为null的行数。在进行统计时候,server层接收从innodb层返回的记录并进行判断,如果不为null则count变量加1,直至innodb层没有记录向server层返回结束。常见的有count(*),count(常数),count(主键),count(普通索引),对于count(*),count(常数),mysql自动对其做了优化,因为server层只关心存储引擎是否读取到记录而不需要判断记录是否为null,因此优化器只会指定占用存储空间最小的索引进行查询,对于count(主键),虽然优化器只会指定占用存储空间最小的索引进行查询,但是会根据索引字段进行判断,而对于count(普通索引),server层需要从innodb中读取包含非主键列的记录。因此通常可以认为性能方面count(*)=count(常数)>count(主键)>=count(普通索引)。但是建议使用count(*)标准方式而不是count(常数)。
子查询:
子查询这一块涉及的比较多,我自身也存在一定欠缺,后续还需强化,总之,概括起来就是:mysql对子查询的处理不是很友好,虽然mysql自身有一些优化机制,但是如果可以的话,还是我们自己动手将子查询改写为连接的方式,另外,对于子查询delete操作,可以利用delete语句支持from后跟多张表的特性将子查询改写为关联查询。
分库分表:
之前业界的通用说法是超过500万行的表就是大表,需要考虑分表,实际上对于最新的8.0而言,千万级别的表也不会有太大压力。当然,需不需要分库分表具体还得结合业务来决断,例如某张表数据很大,但是基本上写多读少,此种情况也可以考虑不分表。分库分表详细来说可分为水平拆分和垂直拆分,或者两者结合使用,除此,还可以使用mysql自身的分区表功能,亦或者使用一些开源中间件,我自己之前接触过mycat,类似的还有shardingjdbc等工具。

数据库服务是运行在机器的,机器常见的配置有cpu,内存,iops等,同时,数据库侧还会有连接数等限制。根据日常遇到的问题及平时学习积累,总结如下:

cpu规格:
cpu高是mysql中一个很高频的问题,也是一个需要重视的问题,cpu高可能会导致响应慢,机器负载高,严重的甚至导致服务hang住,影响业务,常见的导致cpu高的原因有几下几点:1.慢sql,这种一般也是最常见的,解决方法即找到对应的慢sql并进行优化,可以通过mysqldumpslow工具或者pt-query-digest工具协助进行分析。2.业务量,这种可以通过监控曲线进行判断,如果之前cpu都处于一个正常的值,随着qps,tps等指标进行增长,则大概率是因为业务量上升导致cpu高,此种情况升级规格即可。3.短时连接,这种情况一般较少,也比较难排查,可以借助execsnoop工具进行抓取。
内存规格:
mysql与主机侧关联唯二重要的便是内存和磁盘了。在进行操作时,一般都是先和内存交互,然后再持久化到磁盘上,毕竟内存比磁盘要快的多。内存设置的合理,事半功倍,设置不好,轻则导致性能慢,重则引发oom,影响业务。内存设置中占据大头的是buffer pool,一般根据需要设置为示例规格的65%-75%。
连接数:
连接数是限制连接到mysql的会话数,如果连接数满,则会无法连接。这种也会导致业务受损。造成连接数满的原因一方面可能是当前连接数确实设置不合理,无法满足业务需求。另外一方面原因可能是业务侧代码逻辑问题,请求后未及时关闭连接。解决连接数满的方法可以从规避,预防,救火三个时间段解决。规避是从源头解决,合理预估好业务量,并设计好代码逻辑。预防指的是通过监控,提前设置水位,到达水位高点则进行提前处理。救火指的是当连接数已经满了的情况下,此时可能无法登录示例,如果重启,可能对业务影响较大,则可以通过gdb命令临时调整连接数参数。
iops设置:
之前说过,除了内存,mysql与物理机交互最多的便是磁盘了,因为内存断电数据便会丢失,而生产上的数据,尤其涉及到重要业务,是不允许丢失的,因此便涉及到数据的持久化了,这便是落盘机制。相对内存而言,磁盘写入较慢,即使现在大部分都是ssd盘比原来的普通机械盘快了很多。iops便是衡量磁盘读写的一个关键指标,mysql中与之对应的参数便是innodb_io_capacity、innodb_io_capacity_max相关参数,这些参数控制mysql刷脏页的能力。过小会导致刷脏页能力不足,影响性能,甚至因刷脏页耗时过长而导致实例hang住,过大会导致主机io过高,需要合理设置,对于主机的iops能力可以通过fio工具来测试。
其他设置:
对于数据库方面,还可以从主机侧进行一些优化,部分如下:
1.优先使用flash设备,例如NVMe和PCIe接口的flash设备。
2.将binlog,redo等日志文件和数据文件分开存储,日志文件一般是顺序写,此时普通HDD和SSD盘即可满足需求,而数据是异步I/O,需要磁盘满足随机读写IOPS高,并发I/O处理能力强,在资源充足的情况下建议使用PCIe等接口的flash存储或者不带缓冲的SSD盘。
3.设置较小的vm.swappiness值。
4.可以开启大页。
5.采购机器时优先选择频率较高,核数较多的cpu。
6.关闭iptables和SELinux,修改ssh登录端口。


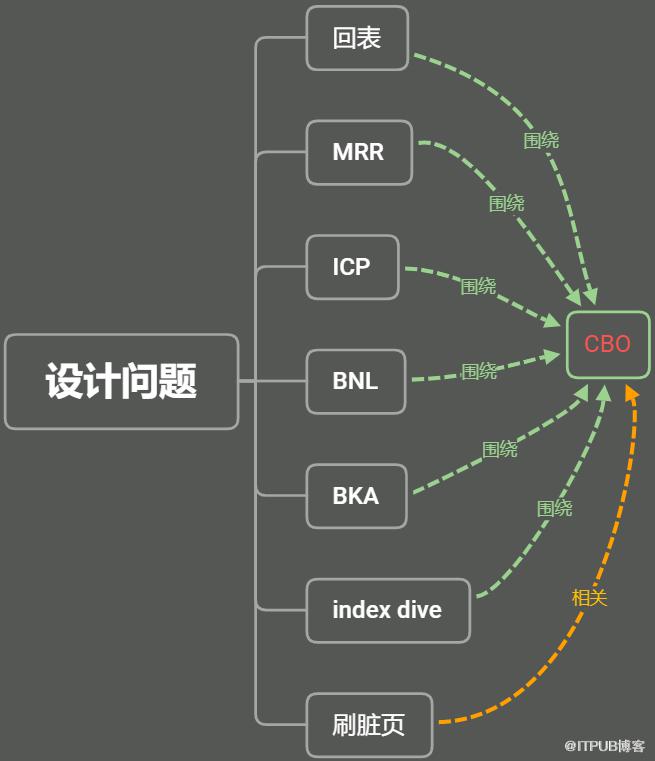
与oracle不同,oracle中支持RBO(Rule-Based Optimization)和CBO(Cost-Based Optimization),mysql只支持CBO。在mysql中,为了提高节能减排,设计者可谓煞费苦心,无论是ICP,还是BNL,亦或是MRR,都能发现这些算法的终极目标就是为了使得sql执行成本更低,了解这些设计思想和优化原理,对于我们日常工作裨益良多。如下,是常见的一些优化算法:
回表:
当执行sql时,如果实际使用的索引是辅助索引,此时如果索引字段不能满足全部查询字段,则需要进行回表操作,即通过辅助索引叶子节点的主键值到主键索引所在的B+树去查找完整记录,这会增加查询成本。
MRR:
MRR全称为multi-range Read,二级索引进行回表时,由于主键索引和二级索引的顺序不一致会导致随机io,随机io会比较慢,MRR会在回表前将索引扫描的顺序根据主键进行排序,然后按照主键进行顺序查找。将随机I/O转化为顺序I/O。可以通过设置SET @@optimizer_switch='mrr=on,mrr_cost_based=on';开启MRR,该过程涉及的buffer参数为read_rnd_buffer_size。
ICP:
ICP全称为Index Condition Pushdown,当where条件查询使用索引时,mysql会将过滤操作从server层下推到引擎层,在引擎层过滤不符合条件的行记录,以此减少引擎层访问基表的次数和server层访问引擎层的次数,降低I/O操作,提高性能。可以通过设置SET @@optimizer_switch='index_condition_pushdown=on';开启ICP,使用ICP优化时,使用explain查看执行计划会发现Extra列显示Using indexcondition提示。
BNL:
BNL全称Block Nested-Loop Join,当join中内循环是全表扫描时,将外循环的行缓存到join buffer中,然后内层循环的每一行与buffer中的记录进行对比,从而减少内层循环的次数。join buffer大小由join_buffer_size参数控制,每次连接使用一个join buffer,多表连接使用多个join buffer,且join buffer只存储与查询相关的字段数据。此时性能较差。
BKA:
BKA全称Batched Key Aceess,是对BNL算法的优化,如果被join的表上有索引,则在join buffer中利用MRR特性对索引字段进行排序,以此减少随机I/O。
index dive:
mysql优化器在进行是基于成本计算的,实际执行查询前,优化器会计算索引查询的成本和全表扫描的成本然后选取更低的方式执行。在范围查询中,当计算索引查询成本时,mysql有两种优化算法,index dive和index statistic,index dive方式中,在查询前优化器会先访问索引来计算需要扫描的索引记录数量。在index statistic方式中,在查询前优化器直接使用索引的统计数值。前者速度慢,但是值更准确,后者速度快,但是值未必准确。另外,mysql中使用eq_range_index_dive_limit参数来控制使用哪种方式。在mysql5.7.3之后,该值默认为200,即当范围区间小于200时,使用index dive方式,否则使用index statistic方式。
刷脏页:
个人角度,mysql中刷脏页的意义一方面是为了解决磁盘和内存容量级别的问题,另一方面是为了保证数据的安全性,持久性,毕竟内存中断电数据就会丢失。
对于调整redo log buffer参数,可以通过实际测试后进行合理调整,innodb_log_buffer_size和innodb_os_log_written状态和
Com_commit状态相关。其中,innodb_os_log_written表示innodb引擎中redo log有多少个字节被写入,Com_commit表示在autocommit=0时提交的事务数量。在业务高峰期,通过如下方式计算每个事务缓冲的平均数据量大小,然后以此为依据设置redo log buffer,单位为bytes。
set global autocommit = 0;
SHOW GLOBAL STATUS LIKE 'Innodb_os_log_written';
select SLEEP(时间);
SHOW GLOBAL STATUS LIKE 'Com_commit';
select Innodb_os_log_written / Com_commit;
另外,如果Innodb_log_waits值一直增大,说明innodb_log_buffer_size过小,需要调大,可通过如下方式测试:
set @old_value := 0;
set @new_value := 0;
select VARIABLE_VALUE into @old_value from information_schema.GLOBAL_STATUS where VARIABLE_NAME = 'Innodb_log_waits';
select SLEEP(时间);
select VARIABLE_VALUE into @new_value from information_schema.GLOBAL_STATUS where VARIABLE_NAME = 'Innodb_log_waits';
select @old_value;
select @new_value;
在mysql中,如何合理设置redo日志的大小呢,我们知道,redo日志是循环写的,如果写满了就会从头覆盖,因此,正常来说,redo日志的大小应该至少设置为满足业务高峰期一个小时的业务日志写入量。可以通过下面方式进行估算:
在业务高峰期执行:
pager grep sequence;
show engine innodb status\G select sleep(60);
show engine innodb status\G
然后将两次lsn的值相减估算出单位时间的写入量,再以此为基数计算一个小时的写入量,最后即可得出估算结果。
首先,我们需要了解ha的机制和原理,ha服务会定时向数据库发送心跳检测数据库是否正常,通常都是连续三次未响应便判定服务异常。其次,关联数据库的四种刷脏页场景。当redo满和脏页过多时虽然mysql本身服务正常,但是此时由于需要全力落盘而无法正常对外提供服务,进入假死状态,类似于jvm发生full gc时的朱丽叶暂停现象。该案例即是如此。

以上便是由之前遇到的一个案例引发的思考了,学而不思则罔,思而不学则怠。虽然是一个比较平常的case,但是如果细细挖掘,便能从中学到很多,结合这个case,我们可以将平时学习的一些知识点进行串联,再消化。下次遇到这类问题思路就更加清晰了,是不是也是一件很有趣很有意义的事情呢。如果能够一直坚持,难道还怕学不好嘛?好了,今天就到这里吧,周五了,祝大家有个美好的周末。

END



原文作者:DBA修行之路;如有侵权,请联系管理员删除。

