

在Innodb中,如果以页为单位进行分配存储空间,逻辑上相邻的两个页的物理位置可能会比较远,当进行范围查找时,会由于随机I/O导致性能较差,因此引入了区,当表中数据量较大的时候,以区为单位而不是页进行空间分配。根据不同准则对区进行分类以便于记忆理解。
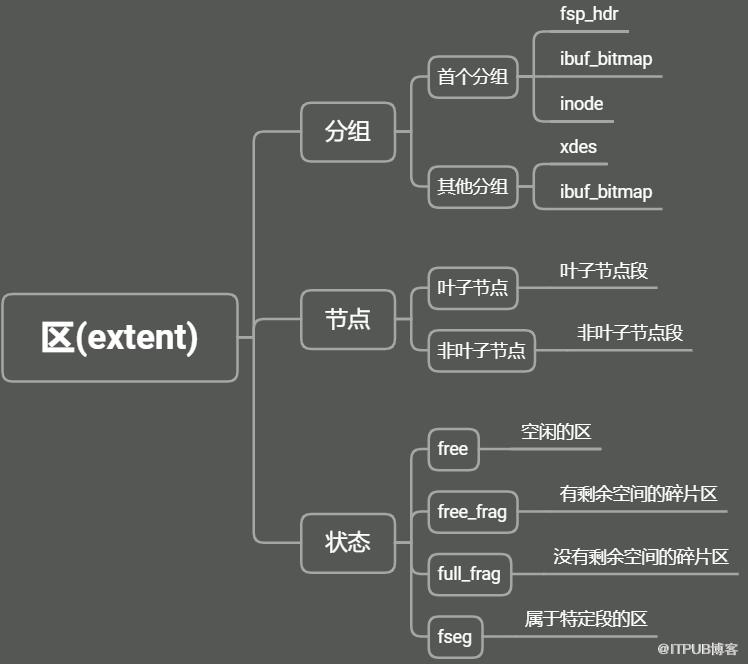
对于16kb的页,物理位置上连续的64个页是一个区,一个区默认占用1mb空间大小,每256个区被划分为一组。例如,extent 0 ~ extend 255是第一个组,extend 256 ~ extent 511是第二个区,其中,第一个组前三个页面类型固定,其余各组前两个页面类型固定。
而在Innodb中,对b+树的叶子节点和非叶子节点也是分区存放的,存放叶子节点的区的集合称之为叶子节点段,存放非叶子节点的区的集合称之为非叶子节点段。
而根据区的状态,又可分为free,free_frag,full_frag,fseg四种。
每个组最开始的页面的类型相关概念如下:
fsp_hdr:该类型的页面的功能是记录整个表空间的一些整体属性以及本组所有的区的属性,整个表空间只有一个fsp_hdr类型的页面。
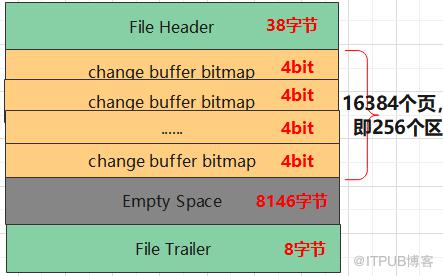
ibuf_bitmap:该类型页面存储本组所有区的所有页面关于insert buffer的信息。
inode:该类型页面存储了inode的数据结构。
xdes:全称为extent descriptor,与fsp_hdr类型的页面的,但是只会记录本组256个区的属性。
在Innodb引擎中,向某一张表插入记录的本质是向该表的聚簇索引及所有二级索引的B+树节点中插入数据,如果每个索引使用单独的段,一个索引会生成叶子节点段和非叶子节点段两个段,段以区为单位进行空间申请,一个区占用存储空间默认为1m,因此即使表的记录很少,每增加一个索引都需要新申请2m的空间。为了提高空间的利用率,Innodb引入了碎片区的概念,即fragment,碎片区直属于表空间,不属于任意一个段。因此向表中插入数据时,段先从碎片区以页为单位进行存储空间申请,当某个段占用了32个碎片区页后,则会以完整的区为单位申请存储空间。
表空间由若干区组成,区根据状态又可以分为如下四类:
free:空闲的区,该区中任何页面都未使用。
free_frag:有剩余空间的碎片区。
full_frag:没有剩余空间的碎片区,即所有页面都被使用。
fseg:属于特定段的区。处于free,free_frag,full_frag状态的区都是独立的,直属于表空间,处于fseg状态的区是附属于某个段的。
FSP_HDR是表空间的第一个页面,页号为0,也是第一个组的第一个页面,存储表空间的整体属性及第一个组内256个区的XDES Entry结构。
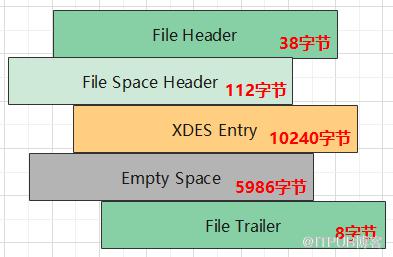
File Header和File Trailer是通用部分,File Space Header记录表空间的整体属性信息。XDES Entry记录本组256个区的属性信息,Empty Space只是用于页的填充,无实际作用。

其中,space id 表示表空间的id,size表示当前表空间的总页面数。space flags用来记录一些占用存储空间小的属性。frag_n_used表示free_frag链表中已经被使用的页面数。
free limit表示当前尚未被初始化的最小页号,在Innodb中,刚开始创建表空间时对应的磁盘文件中是没有数据的,在初始化时只会将部分空闲区对应的XDES Entry结构加入到Free链表中,等到后续不够用了再继续将其他空闲区对应的XDES Entry结构加入Free链表。如果某个区的页号大于free limit的值,表示该区还尚未被初始化,反之则已经被初始化。
next unused segment id记录了当前表空间中最大的段id的下一个id,该值为新建段时赋值id值创建了遍历,当创建索引时无需再进行遍历所有段,直接使用该字段的值即可。
至于list base node for free list,list base node for free_frag list,list base node for full_frag list则分别是直属于表空间的free 链表,free_frag链表,full_frag链表的基节点,list base node for seg_inodes_full list,list base node for seg_inodes_free list则是seg_inodes_free链表,seg_inodes_full链表的基节点。
对于上面的各个链表的16字节的基节点,对应的结构如下:
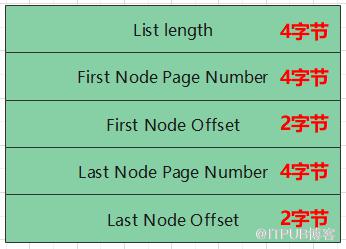
其中,list length表示该链表的节点数,first node page number和first node offset指向该链表的头节点在表空间中的位置,last node page number和last node offset指向该链表的尾节点在表空间的位置。

XDES页与FSP_HDR页类型相似,总体上没有File Space header部分,不需要记录表空间整体的属性,用来存储XDES Entry结构,详细结构如下:
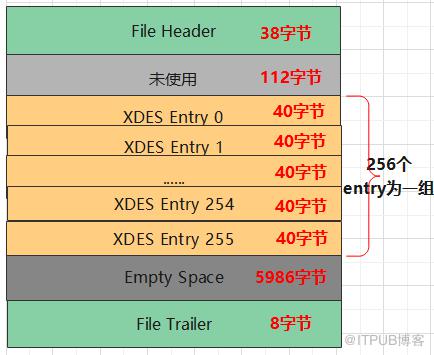
如上,XDES Entry0~255对应着256个区,每个区对应一个XDES Entry结构,XDES Entry结构详细如下:
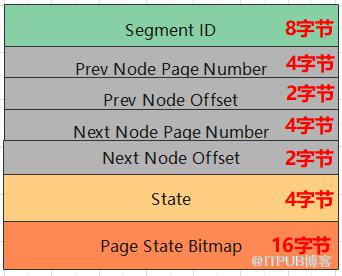
segment id表示该区所在的段,state表示区的状态,可选值为free,free_frag,full_frag以及fseg。
prev node page number和prev node offset两个字段指向前一个XDES Entry的位置,next node page number和next node offset两个字段指向后一个XDES Entry的位置。这四个字段共同构成LIst Node结构。
Page state Bitmap记录每个区中的页的状态,共16个字节,128bit,默认一个区有64个页,每2个bit位对应一个页的状态,两个bit位的前一个位表示对应的页是否是空闲状态,后一位暂未使用。
需要区分直属于表空间的区对应的XDES Entry结构组成的free,free_frag,full_frag链表和专属于段的区对应的XDES Entry对应的free not_full和full链表。
在表空间中,所有状态为free的区对应的XDES Entry通过List Node形成free链表。同理,状态为free_frag,full_frag的对应的为free_frag链表和full_frag链表。
在同一个段中,所有页面都是看贡献的区对应的XDES Entry结构通过List Node形成free链表,这个free链表与前面free链表的区别是专属于某个段的,同理的是,同一个段中有空闲空间的区对应的XDES Entry结构会形成not_full链表,没有空闲空间的区对应的XDES Entry结构形成full链表。
当段中数据较少的时候,会先通过free_frag链表查看表空间中是否有状态为free_frag状态的碎片区,如果有,则申请零碎页进行数据插入,否则通过free链表申请空闲区,然后从新申请的区中申请零碎页进行数据插入,并修改该区状态为free_frag,将该区对应的XDES Entry结构从free链表移动到free_frag链表,当该区中全部空间用完后,会修改该区状态为full_frag,并将该区对应的XDES Entry从free_frag链表移动到full_frag链表。当段中数据占满32个零散的页后,则直接申请完整的区插入数据。

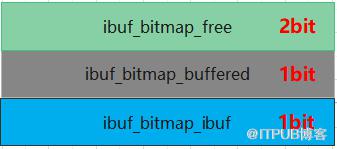

在Innodb中,段是由一些完整的区和一些零散页面共同组成,与使用XDES Entry结构记录区的属性类似,使用INODE Entry结构记录段的属性。用来存储INODE Entry结构的页的类型为INODE,详细结构如下:

其中,File Header和File Trailer是页的通用部分,List Node for INODE Page List由四个字段组成,其中,Prev Node Page Number和Prev Node Offset记录上一个INODE节点的位置,Next Node Page Number和Next Node Offset记录下一个节点的位置。
因为一个INODE类型的页面最多存储85个INODE Entry结构,即对应的85个段,而一个表空间可能不止85个段,因此,在Innodb中用SEG_INODES_FREE链表连接还有空闲空间的INODE页,用SEG_INODES_FULL链表连接没有空闲空间的INODE页,这两个链表基节点对应着File Space Header里的list base node for seg_inodes_free和list base node for seg_inodes_full结构。
每个INODE Entry结构占用192个字节,详细结构如下:

segment id对应INODE Entry结构对应的段的编号。magic number标记当前INODE Entry是否已经初始化。
not_full_n_used字段表示的是not_full链表中已使用的页面数,从而避免遍历。list base node for free list,list base node for not_full list,list base node for full list分别对应段的free链表,not_full链表,full链表的基节点。
fragment array entry对应着零散的页面信息。
在数据页的Page Header部分有page_btr_seg_leaf和page_btr_seg_top两个字段,都占用10个字节,且对应Segment Header结构。Segment Header包含Space ID of the Node Entry(4字节),Page Number of the INODE Entry(4字节),Byte Offset of the INODE Entry(2字节),分别表示段对应的INODE Entry结构对应的表空间ID,页面页号,在页面中的偏移量。
快速记忆不同链表及基节点把握三点即可:
1.所有的基节点都是在FSP_HDR页面,可以理解FSP_HDR是老总,把控全局,XDES,ibuf_bitmap,INODE页面是部门经理,各自管好本部门的业务。
2.链表分为直属表空间的链表,和归属段的链表两类。
3.不同状态链表之间并非固定不变,而是可以相互转换。
上述学习是基于独立表空间展开,系统表空间与独立表空间类似,但是存在如下区别:
1.独立表空间可能有多个,但是系统表空间只有一个。
2.系统表空间比独立表空间多一些额外的记录系统信息的页面。如sys页面,trx_sys页面等,这些后面学习到了再进行记录。

最近比较忙,就没写笔记了,这两天空闲了点就把最近学习的总结下。上面的学习内容是针对表空间的一些系统页的类型及相关结构的学习,与数据(INDEX)页不同的是,这些页记录的并不是实际的用户数据,而是记录系统相关的一些信息。这部分知识学起来比较枯燥,也不是一遍两遍就能记住的,比较鸡肋,学习掌握这些知识点可能并不能让我们解决问题的能力得到提升。但是正如春雨一般,润物无声,可能未来的某个时刻,这些知识点中蕴藏的一些设计思想便能带给我们灵感,帮助我们突破桎梏。最近疫情较严重,大家注意保护自己哈,就到这吧。

END


原文作者:DBA修行之路;如有侵权,请联系管理员删除。

