



HBase适合于写多读少的应用场景,HBase服务端不提供update,delete接口,对数据的更新,删除操作在服务端也会被认为是写入操作,只不过更新操作会写入一个最新版本的数据,删除操作会写入一条标记为deleted的KV数据。HBase数据写入流程随着版本迭代优化,但是总体流程变化不大。
HBase写入流程整体可以分为三个阶段,客户端处理阶段,Region写入阶段,MemStore Flush阶段,流程如下:
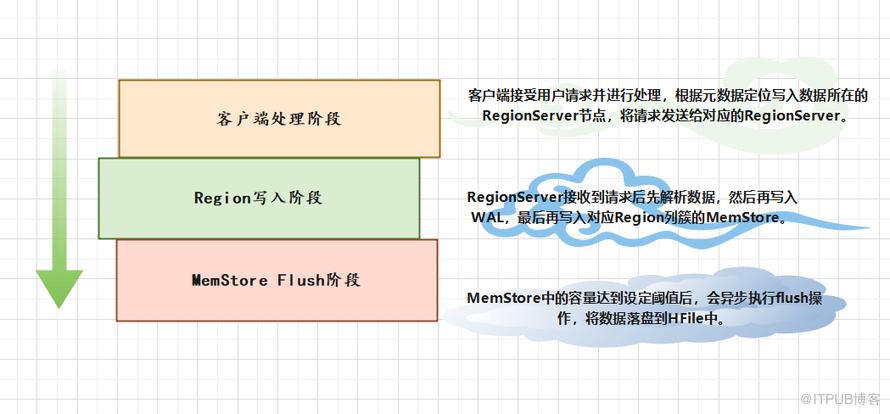


用户提交put请求后,HBase客户端对写入的数据有两种处理方式,一种是批量处理,通过设置autoflush=false实现,先将数据添加到本地缓冲区中,达到一定条件后进行异步批量提交,通过这种方法可以极大提升写入吞吐量,但是会有丢数据风险。另一种是实时处理,通过设置autoflush=true实现,即put请求直接提交给服务器进行处理。
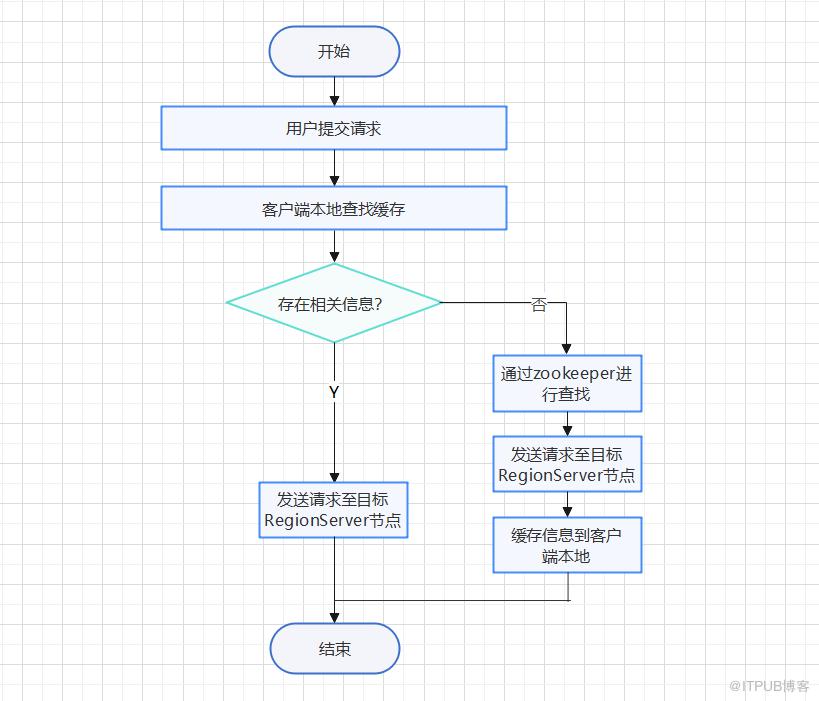
HBase如何将数据提交到对应的RegionServer上呢?实现如下:HBase会在hbase:meta元数据表中根据rowkey进行查找数据归属的RegionServer,该过程中Client会与Zookeeper及RegionServer进行交互。过程如下图:
解析如下:
1).客户端根据写入的表及rowkey在元数据缓存中查找该rowKey对应的RegionServer及Region信息,如果找到直接发送信息至RegionServer。
2).如果找不到,会去与zookeeper交互,在zookeeper的/hbase-root/meta-region-server节点查找RegionServer信息。
3).发送请求至相应RegionServer,查找到Region等信息后将结果缓存到本地。


Region写入可以概括为两大步:
第一步,追加写入HLog。
第二步,随机写入MemStore。
追加写入HLog:
HBase可通过设置HLog持久化级别来决定Hlog机制是否开启及落盘方式,默认级别为SYNC_WAL等级,即同步将数据写入日志文件。旧版本中,HBase的HLog写入需要经历三个阶段,先将数据写入本地缓存,然后将本地缓存写入文件系统,最后执行sync操作同步到磁盘。基于流水线工作,线程同步使用了大量读锁,并发量大时由于抢占锁的问题而导致性能较差。新版本中,HBase使用LMAX Disruptor框架,实现了无锁有界队列操作,大大提高了写入性能。
随机写入MemStore:
MemStore使用ConcurrentSkipListMap数据结构来存储KeyValue,能够非常友好地支持大规模并发写入,同时跳跃表本身存储是有序的,有利于数据有序落盘,提高KeyValue查找性能。
Region写入详细流程如下图:
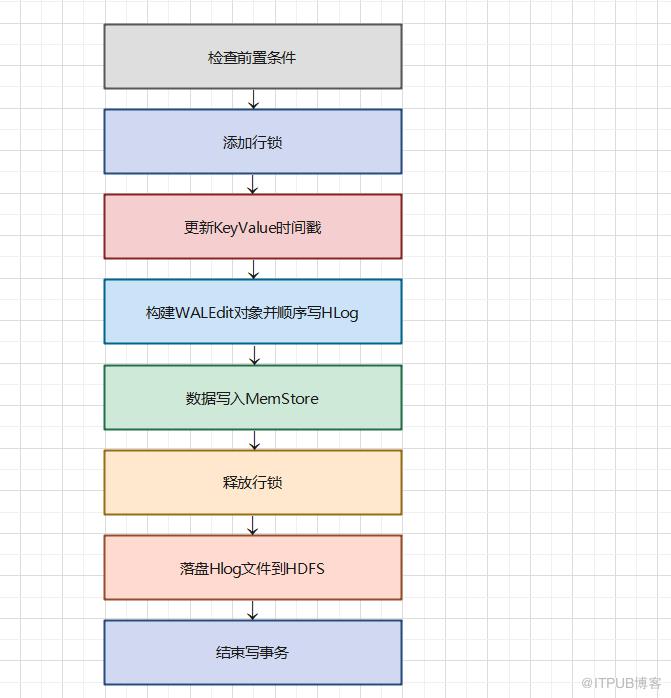
检查前置条件
检查Region是否是只读,MemStore大小是否超过blockingMemStoreSize等。
添加行锁
添加行锁保证对同一行的数据的更新都是互斥操作,以确保更新的原子性。
更新KeyValue时间戳
更新所有待写入的KeyValue的时间戳为当前系统时间。
构建WALEdit对象并顺序写HLog
使用WAL机制以保证数据可靠性,先写日志再写缓存,在内存中构建WALEdit对象,以确保Region级别事务的写入原子性。一次写入操作中所有KeyValue会构建成一条WALEdit记录,然后将WALEdit记录顺序写入HLog中。
数据写入MemStore
写入WAL后将数据写入MemStore中。
释放行锁
释放行锁。
落盘Hlog文件到HDFS
HLog执行sync操作落盘到HDFS,如果sync失败,执行回滚操作将MemStore中写入的数据移除。
结束写事务
当前写线程的更新操作对其他读请求可见,实际生效。
备注:整体流程在不同版本有变化,但原理基本不会有大的变化。

随着数据不断写入,MemStore中存储的数据也会越来越多,便会进行MemStore Flush操作。重点把握以下知识点。
第一:MemStore Flush触发条件
第二:MemStore Flush整体流程。
第三:HFile构建流程。
MemStore Flush触发条件可分为以下几种情况:
MemStore级别限制:当Region中任意一个MemStore的大小达到设置的阈值,默认128MB。
Region级别限制:当Region中所有MemStore的大小综合达到阈值。
RegionServer级别限制:当RegionServer中MemStore大小总和超过设定阈值。flush MemStore顺序按照Region大小。如果此时写入吞吐量高,RegionServer会阻塞更新并强制flush直至总MemStore下降至低水位阈值。
当RegionServer中的HLog数量达到阈值,会选取最早的HLog对应的一到多个Region进行flush。
HBase定期刷新MemStore,默认周期为1小时。
手动执行flush:可以通过flush 'tablename'或flush 'regionname'对表和Region进行flush。
MemStore Flush流程:
HBase中flush过程采用了类似于两阶段提交的方式,以减少flush对读写的影响。共分为三个阶段:
prepare阶段,flush阶段,commit阶段。
prepare阶段,会遍历当前Region中的所有MemStore,对当前数据集做一个快照snapshot。然后新建一个CellSkipListSet介绍新的数据写入,此阶段会添加updateLock对写请求阻塞,但持锁时间很短。
flush阶段:遍历所有MemStore,将生成的snapshot持久化为临时文件,统一放到.tmp目录下,该阶段相对耗时。
commit阶段:将临时文件移动到指定目录下,对于HFile生成的storefile和Reader,会将storefile添加到Store的storefile列表,最后会清空snapshot快照文件。
HFile构建流程
flush过后会将内存中数据按照一定格式写入HFile文件,HFile结构之前的学习总结中有涉及到,可以温故下,更细致的等到掌握基础过后可以自己去了解下。学习还是要循序渐进的,不可急躁。


HLog持久化有五个等级,分别如下:
SKIP_WAL:只写缓存,不写HLog,可以极大提升写入性能,但是存在数据丢失风险,实际生产中不建议使用,除非对数据要求性要求满足。
ASYNC_WAL:异步就是将数据写入HLog。
SYNC_WAL:同步将数据写入日志文件中,但是还没真正落盘。
FSYNC_WAL:同步将数据写入日志文件并强制落盘,是最严格的日志写入等级。能够保证数据不会丢失,但是性能较差。
USER_DEFAULT:如果未指定持久化等级,默认使用SYNC_WAL等级持久化数据。
实际生产环境中需要谨慎考虑,在数据安全和性能两者之间进行权衡,选择最合适的等级。

相同点:
Flush阶段和Compaction阶段生成HFile的流程相同。
不同点:
Flush读取的是MemStore中的KeyValue生成的HFile,Compaction读取的是多个HFile中的KeyValue生成的一个大的HFile。两者KeyValue数据来源不一样。

MemStore执行flush时,会先创建一个Scanner,该Scanner从存储KeyValue数据的CellSkipList中一次从小到大读取每个cell,即KeyValue。保证了HFile文件中数据存储的顺序性。

总体来说,大部分MemStore Flush都不会对业务读写造成太大影响,根据Flush操作方式区分,触发MemStore级别限制,系统定期刷新MemStore,手动执行flush操作,触发HLog数量限制,触发Region级别限制这几种场景只会阻塞对应Region上的写请求,且阻塞时间较短,因而不会对用户请求造成太大影响,但是例如触发RegionServer级别限制,就会对用户请求产生较大影响,flush期间系统会阻塞在该Regionserver上的写入操作,直到MemStore中数据量降低到阈值以下。

详细了解HBase的写流程,一方面有利于实际应用中知道如何针对写操作进行优化。另一方面还能在遇到写入阻塞这些问题时快速定位。除了写流程,还有读流程,下期一起学习吧。

END



原文作者:DBA修行之路;如有侵权,请联系管理员删除。

