



MySQL索引现在最常用的是B+树数据结构,实际上,索引还有哈希表,有序数组等数据结构。
哈希表
哈希表是一种以键-值存储数据的结构,只要输入待查找的值key,就可以找到其对应的值value。多个key值经过哈希函数的换算,可能会出现同一个值的情况,可以通过链表方式处理。哈希表后的链表不是有序的,区间查询的话需要扫描链表,因此哈希表这种结构只适用于只有等值查询的场景。
有序数组:
有序数组在等值查询和范围查询场景中的性能都非常优秀,但是在更新数据的时候非常麻烦,往中间插入一个记录就必须挪动后面所有的记录,成本较高。只适合静态存储引擎。
二分查找
二分查找也称折半查找,是一种效率较高的查找方法,但是要求线性表必须采用顺序存储结构,且表中元素按照关键字有序排列。
二叉树
有序数组的等值查询和比较查询效率很高,但是更新数据会存在问题,为了支持频繁修改,需要采用链表,而单链表查找效率还是不高,因此,催生了二叉查找树。二叉树具有该性质:左子树的键值小于根的键值,右子树的键值大于根的键值。在比较平衡的状态下查找时间复杂度为O(log(n)),但是在某些极端情况下会退化为链表,如插入的数据刚好是有序的。
AVL树
AVL Trees(Balanced binary search trees),又称为平衡二叉树,左右子树的深度差绝对值不能超过1.
AVL树的平衡主要依靠左旋和右旋两个操作。
B-tree(多路平衡查找树):
用树的结构来存储索引的时候,访问一次节点就需要跟磁盘之间发生一次IO,InnoDB操作磁盘的最小的单位是一页(或者叫磁盘块),与主存不同,磁盘I/O存在机械运动耗费,因此磁盘I/O的时间消耗是巨大的,如果每个节点存储的节点太少,从索引中找到需要的数据就需要访问更多的节点,即需要跟磁盘交互次数过多。因此催生了多路平衡查找树,即B树。
B树的节点中存储着多个元素,每个节点有多个分叉。
节点中的元素包含键值和数据,节点中的键值从大到小排列。
父节点当中的原始不会出现在子节点中。
所有的叶子节点都位于同一层,叶节点具有相同的深度,叶节点之间没有指针连接。
B+树(加强版多路平衡查找树):
B树不支持范围查询的快速查找,可能需要回到根节点多次遍历,查询效率待提高,因此引入B+树,B+树和B树最主要的区别在于非叶子节点是否存储数据的问题。
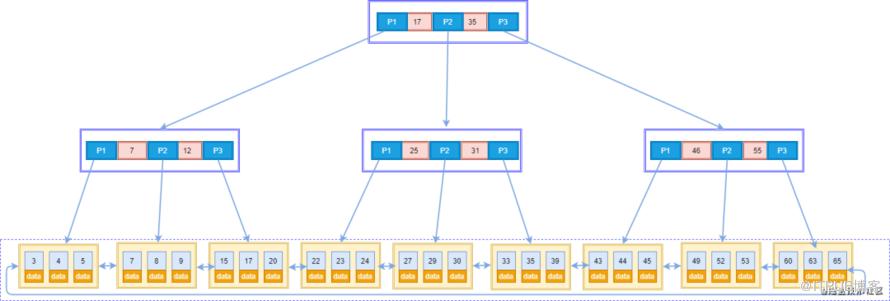
B树非叶子节点和叶子节点都会存储数据,B+树只有叶子节点才会存储数据。非叶子节点只存储键值。叶子节点之间使用双向指针连接,最底层的叶子节点形成了一个双向有序链表。在查找数据时一次页的查找代表一次IO,即一张2000万左右的表,查询数据最多需要访问3次磁盘,因此在InnoDB中B+树深度一般为1~3层,即可满足千万级的数据存储。
这里简单了解下即可哈,有兴趣的可以自己去深入学习。


B+树相较于其他数据结构,含有以下优点:
1).是B树的变种,B树能解决的问题,他都能解决。
2).扫库,扫表能力更强,全表扫描只需要遍历叶子节点就可以了。
3).B+树的磁盘读写能力相对B树更强。
4).排序能力更强
5).效率更加稳定,因为B+树永远是在叶子节点拿到数据,因此IO次数是稳定的。
B+树的结构如下图:(有点懒,借用网络的一张图)


聚簇索引和非聚簇索引的区别:
非聚簇索引:
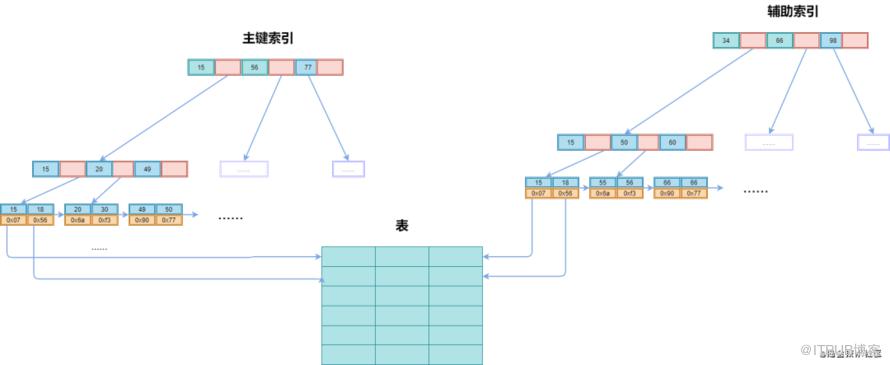
1).MySQL中MyISAM索引采用的是非聚簇索引,非聚簇索引的主键索引和辅助索引基本没有差别,只是主键索引不允许重复重复,不允许空值。
2).非聚簇索引的数据表和索引表分开存储。索引B+树的叶子节点存储着指向键值对应的数据物理地址。
3).非聚簇索引中数据是根据数据的插入顺序进行保存,插入顺序不受键值影响,更适合于单个数据的查询。
还是借用下网上的图哈:
聚簇索引:
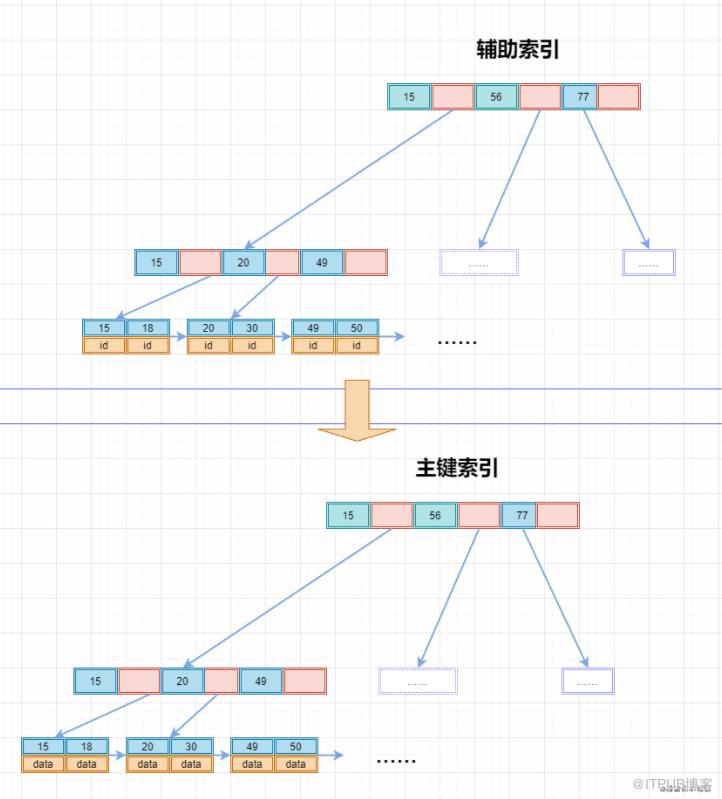
1).MySQL中InnoDB引擎使用的是聚簇索引,聚簇索引的主键索引的叶子节点存储的是键值对应的数据本身,辅助索引的叶子节点存储的是键值对应的数据的主键键值。
2).聚簇索引的数据和主键索引存储在一起。
3).索引的顺序和数据本身的顺序是一致的。
4).在数据行移动或者页分裂时不需要维护辅助索引,能够降低成本,但是聚簇索引会占用更多空间,因为存储了数据。
5).聚簇索引插入时比非聚簇索引慢,因为需要进行主键重复检测,需要遍历主索引的所有叶节点。
还是借用下网上的图哈:

索引按照类别划分,还可以分为以下几种:
主键索引:
索引列的值必须是唯一的,不允许为空值,主键索引只有一个。
普通索引:
索引列的值没特殊要求,一般为经常查询的非主键列,可以设置多个普通索引。
全文索引:
全文索引主要针对文本文件,比如文章,标题,InnoDB引擎5.6后开始支持全文索引。
唯一索引:
索引列的值必须是唯一的,但是允许为空值。
组合索引:
用多个列组合构建的索引,多个列中不允许有空值。
覆盖索引:
在非聚集索引中,不管是单列索引还是联合索引,如果select的数据列只用从索引中就能获取,而不必从数据区中读取,此时使用的索引就叫做覆盖索引,避免了回表,提高了效率,Extra中值为Using index代表使用了覆盖索引。


创建索引,可参考以下规则,最终还需要根据实际情况灵活运用。
1).列的离散度,离散值越高,索引效果越好,如果在B+树结构中重复的值太多,MySQL的优化器发现走索引跟使用全表扫描差不了多少的时候,就算建立了索引,也不一定会走索引。
2).索引最左匹配原则,建立索引的时候,一定要将最常用的列放在最左边。
3).在用于where判断,order排序和join的on字段上创建索引。
4).索引的个数不要过多,建议最多3~5个,因为本身索引也需要进行维护。
5).区分度低的字段不要建立索引。
6).频繁更新的值,不要作为主键或者索引。
7).创建复合索引,而不是修改单列索引。
8).过长的字段可以通过截取字段的前面一部分内容建立索引。
9).不建议用无序的值作为索引,因为会造成叶子节点频繁分裂,出现磁盘存储的碎片化。

索引失效的情况,列举出常见情况,实际情况可能因数据库版本而有差异:
1).索引列上使用函数,表达式,计算。
2).字符串不加引号,出现隐式转换。
3).like条件中前面带%,where条件中like abc%,like %2345%,like %123等用不到索引,因为过滤的开销太大。
4).反向查询not like不能使用索引,!=(<>)和not in在某些情况下可以使用索引(范围索引),可以通过执行计划进行验证是否使用。
5).索引不会包含有NULL值的列,只要列中包含有NULL值都不会被包含在索引中,如果是唯一索引,还是会用到索引。
6).排序的索引问题,MySQL查询只使用一个索引,如果where子句中已经使用了索引的话,order by中的列不会使用索引,因此数据库默认
排序可以满足要求的话不要使用排序操作,尽量不要包含多个列的排序,如果需要最好给这些列创建符合复合索引。
7).组合索引某些情况下不会使用索引,例如组合索引字段为(a,b,c),当查询条件为b,c时,不会走索引。
8).一个SQL语句是否使用索引还与数据库版本,数据量,数据选择度有关系。

索引条件下推:
Index Condition Pushdown(ICP),这是MySQL提供的用某一个索引对一个特定的表从表中获取元组,这种索引优化不是用于多表连接而是用
于单表扫描,准确来说,是单表利用索引进行扫描以获取数据的一种方式,只对非聚簇索引有效。
参考MySQL官方手册描述:
The goal of ICP is to reduce the number of full-record reads and thereby reduce IO operations. For InnoDB clustered indexes, the complete record is already read into the InnoDB buffer. Using ICP in this case does not reduce IO.
可以得出:索引下推只对辅助索引有效,对InnoDB聚集索引无效,索引下推能减少完整记录的读取个数。另外,eq_ref,ref_or_null,ref,system,const可以使用索引,range如果不是index tree only(只读索引),有机会使用索引下推,ALL,index_merger,index_scan不能使用索引下推。
通过如下命令进行关闭或开启:set optimizer_switch='index_condition_pushdown=on/off';
通过explain查看执行计划,Extra列显示“Using index condition”,则表明使用了索引下推。

回表的概念:
在聚簇索引中,通过辅助索引查找数据,先通过索引找到主键索引的键值,然后再通过主键值查出索引里面没有的数据,比基于主键索引的查询多扫描了一棵索引树,这个过程称为回表。
如果select的数据列只用从索引中就能获取,而不必从数据区中读取,则不需要回表,此时使用的索引就是之前提到的覆盖索引。

先说一下主键和默认主键吧,在InnoDB存储引擎中,表都是按照主键的顺序存放的,称为聚簇索引表或者索引组织表(IOT),主键依据如下:
1).显式的创建主键Primary Key。
2).如果表中有非空唯一索引,则为主键。
3).如果不符合上述,MySQL会自动生成一个UUID的隐式主键(6字节大小)。
主键和默认主键的区别,查看了一些资料,询问了几位大佬,加上自己的理解,归纳如下:
1).显式主键可以通过业务来建立,更有意义,默认主键是无意义的,无法根据其来进行查询,仅仅是为了支持MySQL索引组织表特性。
2).显式主键自定义的占用空间可能更小,索引B+树中占用更少的空间。
3).某些工具对于无显式主键不支持,如pt-osc工具,该工具在online DDL操作时经常用到。
4).rowid只有6个字节,最大值为2的48次方,当超过后,数据会被覆盖,虽然2的的48次方数字很大,该瓶颈出现概率很低,但是显式主键没有这个瓶颈。
5).显式主键在主从同步,数据查询等方面性能相比默认主键要优越的多。
6).一般都不会用默认主键,在MGR这种高可用工具里面,没主键的表根本不支持。

索引是MySQL中非常重要的一部分,掌握好索引的相关知识点,一方面可以设计出更合理的表结构,写出更高效的SQL,另一方面,有效避免某些故障的发生。写在最后,祝所有父亲父亲节快乐。


END



原文作者:DBA修行之路;如有侵权,请联系管理员删除。

