

今天这部分会针对索引部分做一个总结归纳,其实大部分人对索引都很熟悉,日常中也经常接触,但是可能很零散,这里系统的总结下吧。
在mysql中,索引是很重要的一部分,尤其在表数据量大的情况下,能够有效缩短记录检索的时间,索引的本质是啥呢,于我而言,索引就是目录,类似于一本书的章节目录。一本书可能有多个章节,每个章节下又包含多个小节,然后每个小节对应具体内容。以主键索引为例,所有的记录就相当于具体内容。这些记录可能比较多,在不同的数据页中,如果一个数据页一个数据页的查找数据,会很慢,此时便可以在此基础上添加一层目录,该目录类似于章节,在该目录中记录每个数据页的页号和对应的该页中的用户记录的最小主键值。如果数据还是很多的话,不行就再加一层。这就形成了一个索引。每层有一到多个数据页,数据页之间通过双向链表连接,从上而下数据页越来越多,因类似于一棵倒立的树,标准称呼为B+树。最底层称为叶子节点,对于聚簇索引来说,叶子节点存储的是完整的用户记录,对于二级索引来说,一般来说,我们接触到的B+树最多不超过4层,假设b+树有n层,则最多只需要进行n个界面的查找。
一般来说,索引可以根据不同条件进行划分,如下:

与innodb中聚簇索引的索引即数据不同,需要特别关注的是myisam引擎的索引和数据是分离开的,在myisam引擎中,会将表中的记录按照记录的插入顺序单独存储在数据文件中,没有数据页的划分概念,单表所有记录都记录在一个数据文件中,在访问记录时,通过行号快速访问。另外,mysiam引擎会将索引信息单独存储到索引文件中,并会单独为表的主键创建一个索引,只不过叶子节点存储的是主键值和行号,查找记录时通过索引寻找对应的行号,然后再通过行号查找对应的记录,因此,某种程度上可以说myisam引擎的表所建的索引都是二级索引。

知道了B+树索引,那么B+树是如何形成的呢,在Innodb引擎中,会在建表时自动建立聚簇索引,而当我们手动创建一个索引时,会经历如下过程:
1.为该索引创建一个根节点页,如果最初表中没有数据,则索引对应的根节点中没有用户和目录项记录。
2.当新插入一条用户记录时,先将用户记录存储到该根节点页中。
3.随着继续插入记录,当根节点页中无可用空间时,会申请一个新页,并将根节点中的所有记录复制到新页,然后对这个新页进行页分裂,得到一个新页,然后根据键值大小将新的记录插入合适的页。
4.根节点升级为存储目录项记录的页。
这里需要注意的是,根节点自从创建开始便不会移动,当创建一个新的索引后,该索引的根节点的页号信息便会被存储到数字字典中,以后当使用该索引时,便会从数字字典中取出根节点的页号,然后访问该索引。


做任何事情都是需要成本的,mysql也不例外,mysql中执行查询操作时的成本由CPU和IO两个方面构成。
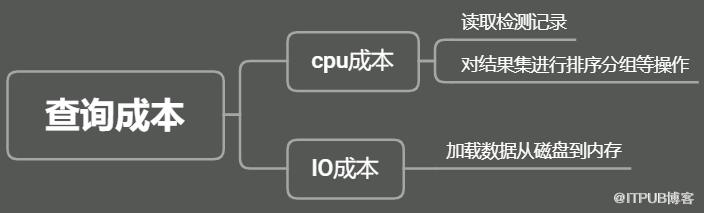
而成本的计算和具体细节相对来说是很复杂的,先占个坑位简单记录一下,后面需要深入的时候再继续学习吧。
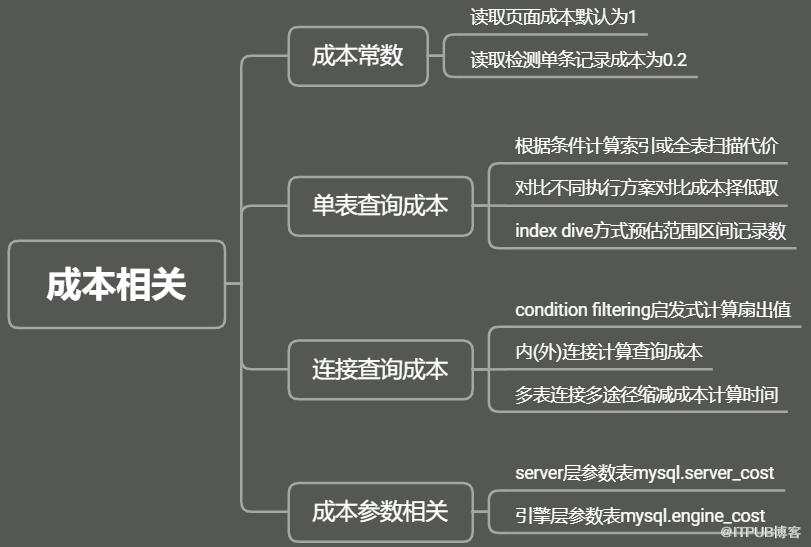
对上述细化几点:
a.规定每次回表操作操作相当于访问一个页面,即成本参数为1。
b.规定读取索引的一个范围区间的IO成本和读取一个页面的成本相同,即使占用多个页面,即成本参数为1。
c.当in子句中的参数个数小于eq_range_index_dive_limit时,使用index dive,否则使用索引统计数据估算。涉及show table status语句中的rows值和show index语句中的cardinality值,假设in语句有m个参数,rows值为n,cardinality值为k,则回表记录数为m*n/k。
d.索引统计数据较index dive方式简单,但是精确性差,可能与实际所需成本相差较大。
e.驱动表的扇出(fanout)指的是对驱动表进行查询后得到的记录条数。
f.修改成本常数后通过flush optimizer_costs;命令进行刷新生效,如果需要再改回默认值,设置值为null后再次进行刷新即可。
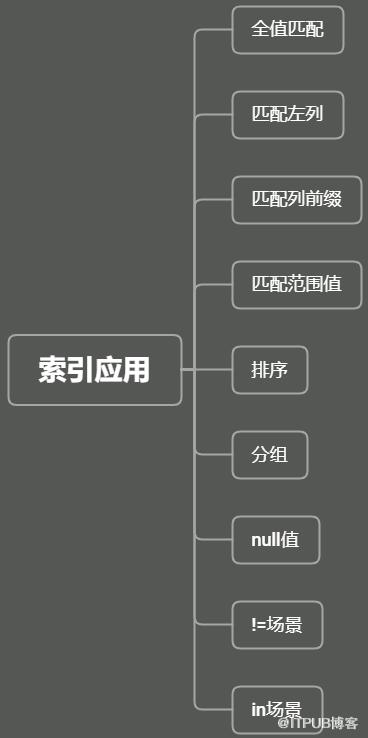
选择索引时可以参考以下原则:
a.为列的基数大的列创建索引。
b.索引列的类型尽可能小以节省空间。
c.只在用于搜索,排序或分组的列上创建索引。
d.对于长字符串值可建立前缀索引。
e.索引不宜过多,最多3-5个,删除重复和冗余索引。
f.尽可能使用覆盖索引,避免回表。
g.建议主键拥有auto_increment属性以避免聚簇索引发生页分裂和记录移位情况。
后续其他的想到了再进行补充吧。
在计算范围区间记录数时,假设区间为(m,n),称m为区间最左记录,n为区间最右记录,如果区间最左记录和区间最右记录相差不大,则精确统计,否则从最左记录向右读若干个页面,然后计算每个页面的平均值,然后乘以区间最左记录和区间最右记录之间的页面数得到预估记录数。计算页面数通过记录目录项个数即可,这个是很快的。这种通过直接访问索引对应的B+树计算范围区间的索引记录数的方式即为index dive。
多表连接时,随着表的数量增加,连接顺序也呈阶乘级增长,如果都计算到底,会产生很大开销,因此对此设定了一些规则进行优化:
a.提前终止,假设之前分析的最小查询成本为m,本次分析还未结束时成本已经达到n,且n>m,则停止本次分析,直接进行下一个顺序的分析。
b.设定分析深度,由optimizer_search_depth系统变量决定穷举分析表的个数,该值越大,越有可能达到更优的成本,但是成本分析花费时间也越长。
c.根据启发式规则进行分析,通过optimizer_prune_level参数控制开启。
实际上,生产上不建议超过3个以上的表连接。

上述内容主要是围绕索引进行汇总的,从索引的分类,到索引的B+树的形成,再到索引的应用场景,以及最终的与索引相关的执行成本,当然,这里执行成本分析部分只是粗略了解下,先有个印象。其实,在执行查询时,mysql就相当于一个精明的商人,会在各种方案中选择一个成本最低的,是索引还是全表扫描心中自有定数,当然,再精明的商人有时也可能犯傻,这有可能是数据统计不精确导致成本分析出错了。好了,就到这里吧,明天又得上班了,难受啊。

END



原文作者:DBA修行之路;如有侵权,请联系管理员删除。

